
Grundlagen der KI
Was sind große Sprachmodelle (LLMs)?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Ein großes Sprachmodell (LLM) ist ein neuronales Netzwerk, das auf großen Sammlungen von Sequenzen trainiert wird, um Token oder verwandte Sprachziele vorherzusagen. Die meisten aktuellen LLMs verwenden Transformer‑Architekturen und können Sprache über eine einheitliche Schnittstelle generieren, klassifizieren, zusammenfassen, übersetzen, abrufen und transformieren.
Ein LLM ist weder eine Datenbank noch ein garantierter Schließer. Seine Ausgabe ist eine bedingte Vorhersage, die von Trainingsdaten, Nachtraining, Kontext, Werkzeugen und Decodierung geprägt ist. Flüssigkeit kann mit sachlichen Fehlern, Unsicherheit, Vorurteilen oder unsicherem Verhalten koexistieren.
Wesentliche Erkenntnisse
- Tokenisierung wandelt Text in diskrete Einheiten um; Einbettungen und Aufmerksamkeit erzeugen kontextuelle Darstellungen.
- Beim Pre‑Training werden allgemeine Muster erlernt, während Feinabstimmung und Präferenzmethoden das Aufgabenverhalten formen.
- Abruf und Werkzeuge können aktuelle Evidenz oder Aktionen hinzufügen, erfordern jedoch separate Berechtigungen und Validierung.
- Bewerten Sie das bereitgestellte System hinsichtlich Qualität, Fundierung, Sicherheit, Latenz, Kosten und Drift.
Token, Transformer und Vortraining
Text wird in Token aufgeteilt. Ein Transformer wandelt sie in Vektoren um, mischt Informationen mittels Aufmerksamkeit und Feed‑Forward‑Schichten und erzeugt eine Wahrscheinlichkeitsverteilung über das nächste oder fehlende Token.
Selbstüberwachte Ziele erzeugen Trainingssignale aus Rohsequenzen. Skalierung in Parametern, Daten und Rechenleistung kann den Verlust über Bereiche hinweg vorhersehbar reduzieren, doch Datensatzqualität, Architektur, Optimierung und Evaluierung bestimmen, welche Fähigkeiten in der Praxis entstehen.
Nachtraining und Inferenz
Instruction‑Tuning nutzt Demonstrationen; Präferenzoptimierung kann Ausgaben besser an menschliche Urteile oder eine Richtlinie anpassen. Bei der Inferenz definieren ein Prompt und der Gesprächsverlauf den Kontext, während Temperatur‑ und Sampling‑Einstellungen die Variabilität beeinflussen.
RLHF und ähnliche Methoden formen das Verhalten, anstatt einen vollständigen Faktenprüfer zu integrieren. Das Modell kann dennoch eine plausible, aber unbelegte Antwort erzeugen.
Abruf, Werkzeuge und Agenten
Retrieval‑augmented Generation liefert Passagen, die aus einer externen Sammlung ausgewählt wurden. Werkzeugaufrufe ermöglichen es Anwendungs‑Code, Datenbanken abzufragen, Berechnungen durchzuführen, zu suchen oder Aktionen auszuführen. Diese Muster trennen einen Teil des Wissens und der Ausführung von den Modellgewichten.
Die Anwendung muss Werkzeug‑Argumente validieren, Berechtigungen durchsetzen, Zitate bewahren und abgerufene Inhalte als unzuverlässige Eingaben behandeln. Ähnlichkeitssuche nach Vektoren unterstützt den Abruf, beweist jedoch nicht, dass eine Passage die Antwort unterstützt.
Einschränkungen und Evaluation
LLMs können halluzinieren, memorierten Inhalt preisgeben, bösartige Anweisungen befolgen, Vorurteile reproduzieren und bei Aufgaben, die Trainingsbeispielen ähneln, versagen. Langer Kontext garantiert nicht, dass jede Tatsache verwendet oder korrekt abgeglichen wird.
Bewerten Sie anhand repräsentativer privater Aufgaben mit dokumentierten Prompts und Versionen. Messen Sie die Unterstützung durch Quellen, Ablehnung, Kalibrierung, Sicherheit, Subgruppen‑Ergebnisse, menschliche Arbeitslast, Latenz und Kosten. Überwachen Sie nach der Veröffentlichung, da sich Modelle, Daten und Nutzerverhalten ändern.
Trainingsdaten und Modellentwicklung
Pre‑Training‑Korpora kombinieren Webseiten, Bücher, Code, wissenschaftliches Material, Gespräche sowie lizenzierte oder kuratierte Quellen. Pipelines erkennen Sprache, entfernen Duplikate, filtern Qualität und unsichere Inhalte, behandeln personenbezogene Daten und wählen Mischungsgewichte. Diese Entscheidungen prägen Wissen, Sprachabdeckung, Stil, Vorurteile und Memorierung.
Optimierungsverfahren verarbeiten Chargen von Token‑Sequenzen und minimieren den Vorhersageverlust mittels Gradientenabstieg. Verteiltes Training teilt Daten, Modell‑Tensoren, Pipeline‑Stufen oder Experten über Beschleuniger auf. Checkpointing, numerische Stabilität, Netzwerkkommunikation und Fehlerrückgewinnung werden bei Skalierung zu wesentlichen ingenieurtechnischen Herausforderungen.
Die Evaluation während des Trainings verfolgt Verlust und Fähigkeits‑Suiten, doch Benchmark‑Kontamination kann Ergebnisse aufblähen. Halten Sie Zeiträume und proprietäre Aufgaben zurück, suchen Sie nach Überschneidungen und berichten Sie genaue Prompts, Decodierung, Werkzeuge und Bewertung. Ein Modell kann den durchschnittlichen Verlust verbessern, während Rückschritte in Sicherheit oder einer ressourcenarmen Sprache auftreten.
Kontextfenster, Decodierung und Inferenz
Bei der Inferenz speichert der Schlüssel‑Wert‑Cache Aufmerksamkeitsprojektionen früherer Token, sodass sie nicht bei jedem Schritt neu berechnet werden müssen. Der Cache‑Speicher wächst mit Schichten, Sequenz, Batch und Repräsentation. Quantisierung und Paging reduzieren die Belastung, können jedoch Qualität oder Latenz verändern.
Greedy‑Decodierung wählt das Token mit höchster Wahrscheinlichkeit aus; Temperatur skaliert Wahrscheinlichkeiten neu; top‑k und top‑p beschränken die Kandidatenmenge; Beam‑Search verfolgt mehrere Sequenzen. Die beste Strategie hängt davon ab, ob die Aufgabe Determinismus, Vielfalt, strukturierte Ausgabe oder Sequenz‑Wahrscheinlichkeit wertschätzt. Validieren Sie stets das Schema nach der Generierung.
Langer Kontext erhöht die verfügbare Informationsmenge, garantiert jedoch kein Abrufen oder Schließen. Position, Ablenkungen, Widersprüche und Prompt‑Struktur beeinflussen die Nutzung. Abruf kann ein kleineres Evidenz‑Set auswählen, während Zusammenfassung die Historie komprimiert, jedoch Gefahr läuft, Details zu verlieren. Messen Sie die Leistung über Kontextlänge und -position.
Anpassung, Bereitstellung und Wirtschaftlichkeit
Voll‑Feinabstimmung aktualisiert alle Parameter; parametereffiziente Methoden aktualisieren Adapter oder Niedrigrang‑Matrizen; fortlaufendes Pre‑Training passt die Domänenverteilung an; Instruction‑ und Präferenz‑Tuning formen die Antworten. Abruf ist oft besser für häufig wechselnde Fakten, während Tuning besser für Verhalten und Aufgabenformat ist. Die Methoden können kombiniert werden.
Bereitstellungsoptionen umfassen gehostete APIs, verwaltete Endpunkte, selbstgehostete offene Gewichte, Geräte‑Modelle und Hybride. Vergleichen Sie Datenverarbeitung, Versionskontrolle, Latenz, Durchsatz, Regionen, Verfügbarkeit, Modell‑Portabilität, Support und Gesamtkosten. Selbst‑Hosting überträgt Verantwortung für Sicherheit, Skalierung, Updates und Missbrauchs‑Monitoring.
Kosten pro Token sind unvollständig. Ein schwaches Modell kann Wiederholungen, längere Prompts, mehr Review oder teure Fehler erfordern. Messen Sie die Kosten pro erfolgreich abgeschlossener Aufgabe bei erforderlicher Qualität und Risikoniveau. Nutzen Sie Caching, Batch‑Verarbeitung, kleinere geroutete Modelle und deterministischen Code, wo sie den gesamten Arbeitsablauf verbessern.
Praktisches Beispiel: Verankerung eines LLMs in Unternehmensdokumenten
Ein Dokumenten‑Assistent sollte mit einem berechtigungs‑bewussten Korpus, stabilen Dokument‑Identifikatoren, Versions‑ und Gültigkeitsdaten, parse‑barer Struktur und einem Evaluations‑Set aus beantwortbaren, unbeantwortbaren, mehrdeutigen und widersprüchlichen Fragen beginnen. Abruf‑Indizes chunk‑ und Metadaten, aber Chunk‑Größe und Überlappung müssen zur Dokumentenstruktur passen. Die Suchqualität wird unabhängig vor der Generierung gemessen, sodass ein flüssiges Modell fehlende Evidenz nicht verbergen kann.
Zur Laufzeit authentifizieren Sie den Nutzer, filtern den Abruf nach Zugriff, rufen Evidenz ab und sortieren sie neu, erstellen einen begrenzten Prompt, generieren eine zitierte Antwort und validieren die erforderliche Ausgabe. Das Modell sollte angeben, wenn Quellen widersprüchlich sind oder eine Antwort nicht unterstützen. Werkzeug‑Nutzung und externe Aktionen erfordern separate Autorisierung. Schützen Sie sich vor in abgerufenen Dokumenten eingebetteten Anweisungen, indem Sie den Inhalt als Daten statt als höher priorisierte System‑Richtlinie behandeln.
Bewerten Sie Abruf‑Recall, Zitations‑Präzision, Antwort‑Richtigkeit, Fundierung, Ablehnung, Latenz und Kosten über Rollen und Dokumentarten hinweg. Verfolgen Sie Modell-, Prompt‑, Index‑, Parser‑ und Korpus‑Versionen für jeden Test. In der Produktion protokollieren Sie Evidenz‑IDs und Feedback, ohne privaten Text offenzulegen, überwachen neu unbeantwortbare Fragen nach Inhaltsänderungen und halten ein sicheres Fallback bereit. Eine LLM‑Schnittstelle ersetzt nicht das Dokumenten‑Management, Zugriffskontrollen oder die verantwortliche Fach‑Review.
Die Kapazitätsplanung sollte Verteilungen von Prompt‑ und Ausgabelängen, gleichzeitige Nutzer, Cache‑Verhalten, Werkzeug‑Latenz und Wiederholungsraten modellieren. Streaming verbessert die wahrgenommene Latenz, erschwert jedoch Moderation und Abbruch, weil unsichere oder falsche Inhalte den Nutzer erreichen können, bevor die vollständige Antwort geprüft ist. Legen Sie Token‑ und Werkzeug‑Budgets fest, isolieren Sie Mandanten, schützen Sie Anbieter‑Credentials und proben Sie Failover zwischen Modell‑Versionen, ohne das Verhalten, von dem die Nutzer abhängen, stillschweigend zu ändern.
Praktische Implementierungs‑Checkliste
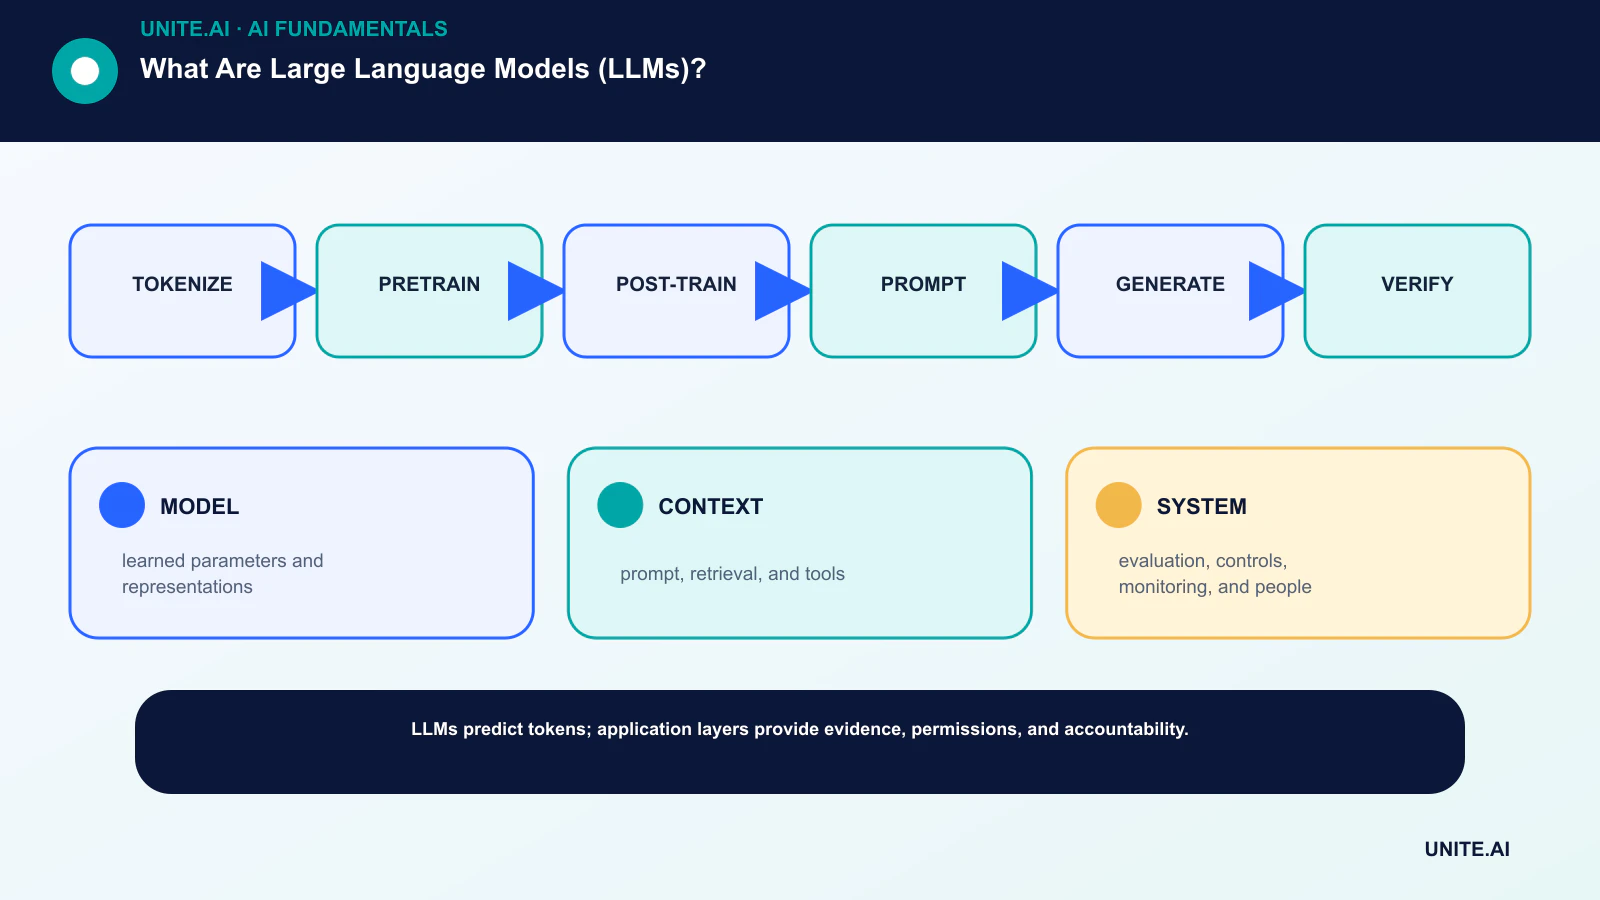
Verwandeln Sie das Konzept in einen begrenzten, testbaren Workflow: tokenisieren → vortrainieren → nachtrainieren → prompten → generieren → verifizieren. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, setzen Sie Annahme‑ und Abbruchkriterien, testen Sie repräsentative Fehlerszenarien und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen verstehen kann.
Vor dem Start führen Sie eine dokumentierte Readiness‑Review mit den Personen durch, die das System bauen, betreiben, sichern und davon betroffen sind. Testen Sie Normalfälle, Grenzbedingungen, Abhängigkeitsfehler und Missbrauch; bewahren Sie die Evidenz und ungelöste Risiken. Definieren Sie, wer die Veröffentlichung freigeben, einen Schwellenwert ändern, eine Ausgabe überschreiben oder den Betrieb stoppen kann. Überarbeiten Sie die Entscheidung, wenn reale Daten eintreffen, da ein technisch erfolgreicher Pilot keine zuverlässige Leistung im größeren Maßstab garantiert.
- MODELL: gelernte Parameter und Repräsentationen.
- KONTEXT: Prompt, Abruf und Werkzeuge.
- SYSTEM: Evaluation, Kontrollen, Monitoring und Personen.
Häufig gestellte Fragen
Warum werden LLMs als groß bezeichnet?
Es gibt keine universelle Parameter‑Schwelle. „Groß“ bezieht sich auf das Ausmaß im Vergleich zu früheren Sprachmodellen, einschließlich Parameter, Trainingsdaten, Rechenleistung und Anwendungsbreite.
Verstehen LLMs Sprache?
Sie erzeugen nützliche interne Repräsentationen und zeigen komplexes Verhalten, doch das Wort „verstehen“ hat mehrere Bedeutungen. Die Leistung sollte aufgabenbezogen demonstriert werden, anstatt aus der Flüssigkeit abzuleiten.
Primäre Referenzen












