Grundlagen der KI
Was ist Deep Learning?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Deep Learning ist eine Familie von Methoden des maschinellen Lernens, die neuronale Netze mit mehreren Verarbeitungsschichten nutzt, um nützliche Darstellungen von Daten zu erlernen. Diese Modelle treiben viele moderne Systeme für Sprache, Bilder, Audio, Empfehlungen, wissenschaftliche Vorhersagen und generative KI an.
Das Wort deep bezieht sich auf die Anzahl der Transformationen zwischen Eingabe und Ausgabe, nicht darauf, dass die Maschine ein tieferes Verständnis besitzt. Ein tiefes Modell lernt numerische Zusammenhänge, die für sein Trainingsziel nützlich sind, und seine Leistung muss weiterhin an neuen Daten getestet werden.
Wesentliche Erkenntnisse
- Deep Learning ist ein Teilbereich des Machine Learning.
- Schichten transformieren Tensoren mithilfe gelernter Parameter, nichtlinearer Aktivierungen, Normalisierung und anderer Operationen.
- Backpropagation berechnet Gradienten; ein Optimierer nutzt diese Gradienten, um trainierbare Parameter, einschließlich Gewichte und Biases, zu aktualisieren.
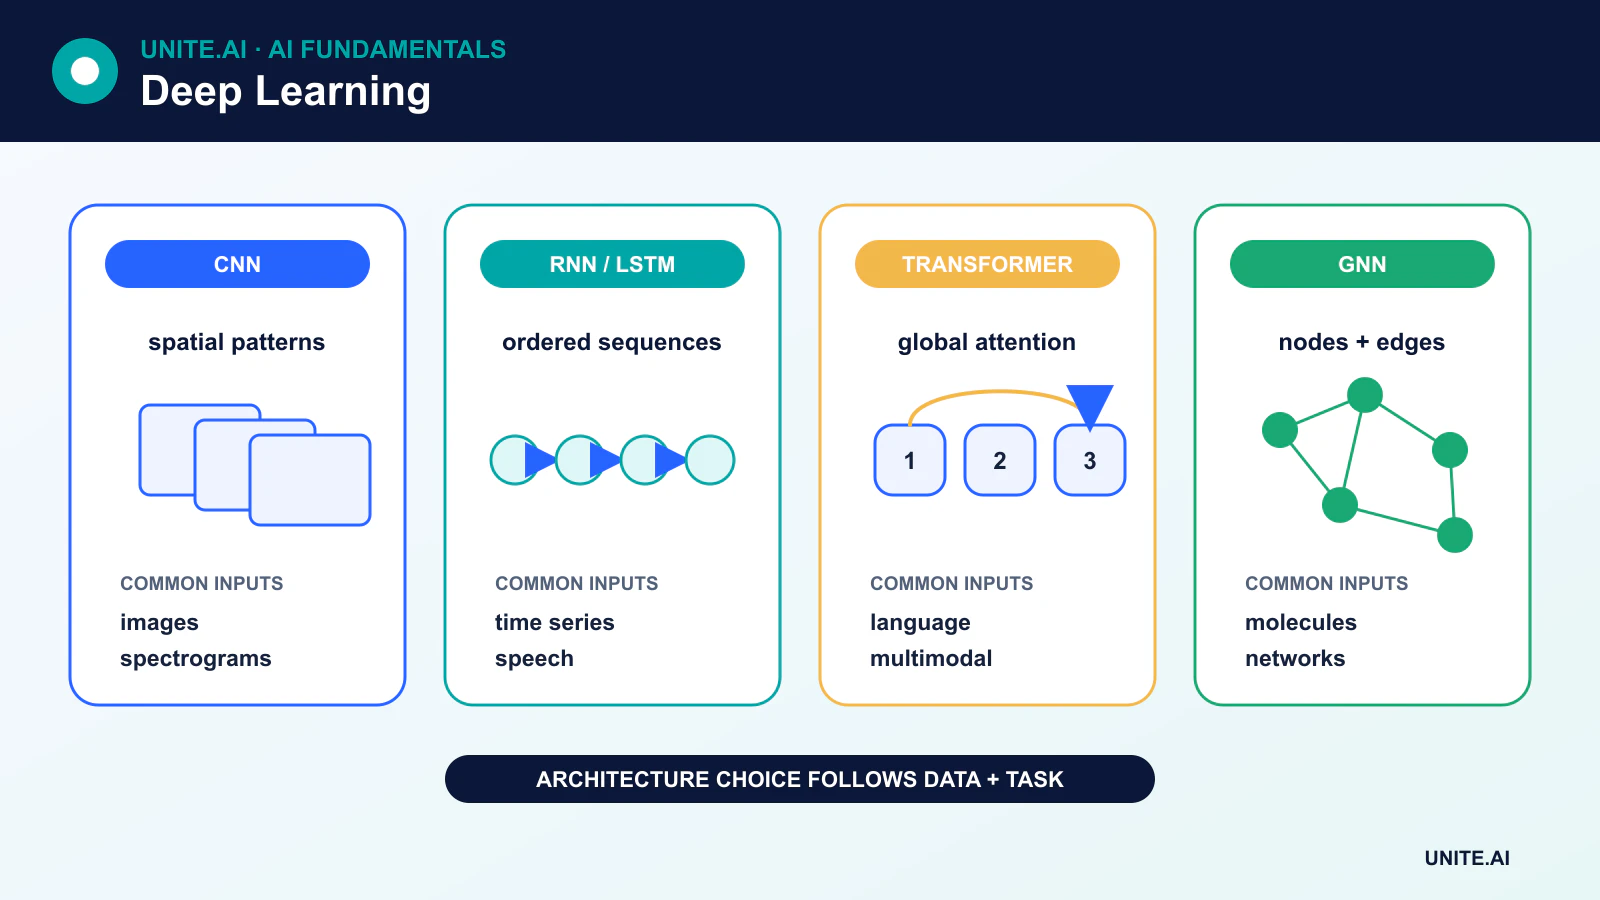
- CNNs, rekurrente Netze, Transformer, Autoencoder und Diffusionsmodelle besitzen unterschiedliche Strukturen und Stärken.
Wie ein tiefes neuronales Netzwerk lernt
Ein neuronales Netzwerk erhält Daten als Tensoren, also mehrdimensionale Zahlenarrays. Ein Bildtensor kann Pixelkanäle kodieren, während ein Sprachmodell Vektoren verwendet, die Tokens repräsentieren. Jede Schicht führt eine differenzierbare Transformation durch und gibt das Ergebnis an die nächste Schicht weiter.
In einer einfachen dichten Schicht berechnet das Modell die gewichtete Summe seiner Eingaben, fügt einen trainierbaren Bias hinzu und wendet dann eine Aktivierungsfunktion an:
output = activation(Wx + b)
Die Aktivierungsfunktion führt Nichtlinearität ein. Ohne sie würde das Stapeln gewöhnlicher linearer Schichten lediglich eine lineare Transformation darstellen. ReLU und seine Varianten sind in versteckten Schichten üblich, während Ausgangsaktivierungen vom jeweiligen Anwendungsfall abhängen.
Das Training folgt typischerweise vier Schritten:
- Ein Forward Pass erzeugt Vorhersagen.
- Eine Loss-Funktion misst, wie die Vorhersagen vom Ziel abweichen.
- Backpropagation wendet die Kettenregel an, um den Gradienten des Verlusts bezüglich jedes trainierbaren Parameters zu berechnen.
- Ein Optimierer wie Stochastic Gradient Descent oder AdamW aktualisiert die Parameter.
Das Wiederholen dieser Schritte über viele Batches kann das Modell verbessern, doch ein niedriger Trainingsverlust garantiert kein zuverlässiges Verhalten in der Praxis. Validierung, Regularisierung, repräsentative Daten und Monitoring bleiben unverzichtbar.
Wichtige Deep-Learning-Architekturen
Mehrschichtige Perzeptrons
Ein mehrschichtiges Perzeptron (MLP) verwendet vollständig verbundene Schichten, bei denen jede Ausgabeeinheit von allen Eingaben der vorherigen Schicht abhängt. MLPs sind nützlich für tabellarische Merkmale und als Komponenten in größeren Systemen, berücksichtigen jedoch keine Annahmen über Bildlokalität oder Reihenfolge von Sequenzen.
Convolutional Neural Networks
Convolutional Neural Networks (CNNs) wenden gelernte Filter über lokale Regionen an. Gewichtsteilung macht sie effizient für Gitter wie Bilder und Spektrogramme. CNNs bleiben wichtig für Vision und Edge-Deployments, obwohl Vision-Transformer und hybride Modelle ebenfalls weit verbreitet sind.
Rekurrente Netze, LSTMs und GRUs
Rekurrente neuronale Netze (RNNs) aktualisieren einen versteckten Zustand, während eine Sequenz verarbeitet wird. LSTMs und gated recurrent units (GRUs) helfen, Informationen zu bewahren und das Vanishing-Gradient-Problem zu reduzieren, das einfache RNNs bei langen Abhängigkeiten Schwierigkeiten bereitet. Sie beseitigen nicht jede Langzeitkontext‑Beschränkung, sind jedoch nach wie vor nützlich für Streaming‑Signale, Zeitreihendaten und kompakte sequenzielle Modelle.
Transformer
Transformer nutzen Attention, um Beziehungen zwischen Elementen einer Sequenz oder Menge zu modellieren. Ihre Fähigkeit, viele Positionen parallel zu verarbeiten, ermöglichte es ihnen, Rekurrenz in den meisten groß‑skaligen Sprachsystemen zu ersetzen, und Transformer‑Varianten verarbeiten heute Bilder, Audio, Video, Proteine und multimodale Daten.
Autoencoder und generative Modelle
Ein Autoencoder komprimiert eine Eingabe zu einer Darstellung und rekonstruiert die Eingabe daraus. Dies erzeugt ein selbstüberwachtes Rekonstruktionsziel; es wandelt nicht automatisch unlabeled Daten in gelabelte Beispiele um.
Generative Adversarial Networks trainieren einen Generator und einen Diskriminator im Wettbewerb. Diffusionsmodelle lernen, einen schrittweisen Rauschprozess umzukehren. Autoregressive Transformer erzeugen ein Token oder eine Einheit nach dem anderen. Diese Ansätze besitzen unterschiedliche Trainingsdynamiken, Kontrollierbarkeit und Rechenanforderungen.
Warum Tiefe hilft – und warum die Architektur wichtig ist
Mehrere Schichten ermöglichen es einem Modell, einfachere Transformationen zu komplexeren zu kombinieren. In der Bildverarbeitung können einige gelernte Merkmale von lokalen Texturen zu aufgabenspezifischen Mustern fortschreiten. In der Sprache bauen Attention‑Schichten kontextabhängige Token‑Darstellungen auf. Diese Beschreibungen sind nützliche Intuitionen, keine festen Regeln dafür, was jede Schicht lernen muss.
Moderne Netze nutzen zudem Residual‑Verbindungen, Normalisierung, sorgfältige Initialisierung, Regularisierung und optimierte Hardware. Einfaches Hinzufügen von Schichten oder Parametern kann ein Modell schwerer trainierbar, langsamer oder anfälliger für Overfitting machen. Die Modellgröße hilft nur, wenn Daten, Ziel, Optimierung und Einsatzumgebung dies unterstützen.
Training versus Inferenz
Training passt Parameter an und ist in der Regel die rechenintensivste Phase. Inference führt das trainierte Modell aus, um ein Ergebnis zu erzeugen. Inferenz kann bei großen Modellen weiterhin teuer sein, weshalb Teams Quantisierung, Distillation, Batching, Caching, Sparsität und spezialisierte Hardware wie Neural Processing Units einsetzen.
Einschränkungen und verantwortungsbewusste Nutzung
Tiefe Modelle können Vorurteile übernehmen, sensible Informationen memorisieren, bei Verteilungsverschiebungen versagen und überzeugende, aber falsche Ausgaben erzeugen. Sie können zudem schwer zu interpretieren und teuer zu trainieren sein. Die Bewertung sollte mehr als einen Benchmark‑Durchschnitt abdecken: Teams benötigen Leistungsmetriken auf Klassen‑ oder Subgruppen‑Ebene, Robustheit, Kalibrierung, Sicherheit, Latenz, Energieverbrauch und die Folgen von Fehlfunktionen.
Darstellungen, Optimierung und Architekturentscheidungen
Tiefe Netze lernen aufeinanderfolgende Darstellungen durch parametrisierte Schichten. Lineare Transformationen mischen Eingaben; nichtlineare Aktivierungen ermöglichen dem Netzwerk, komplexe Funktionen zu approximieren; Normalisierung und Residual‑Verbindungen unterstützen die Optimierung; Attention, Convolution, Rekurrenz oder State‑Space‑Operationen kodieren unterschiedliche strukturelle Annahmen. Tiefe erhöht die Anzahl der Transformationen, nicht jedoch garantiert Intelligenz. Die Architektur sollte die Modalität, Datenmenge, Latenz, Speicher und Invarianzen der Aufgabe widerspiegeln. Ein kleineres Convolution‑Modell kann einem Transformer überlegen sein, wenn Daten knapp sind und lokale räumliche Strukturen dominieren.
Training berechnet einen Verlust, differenziert ihn mittels Backpropagation und aktualisiert die Parameter mit einem Optimierer wie Stochastic Gradient Descent oder Adam. Batch‑Größe, Lernrate, Zeitplan, Initialisierung, Regularisierung und numerische Präzision interagieren. Kurven für Trainings‑ und Validierungsverlust helfen, Underfitting, Overfitting, Instabilität und Leakage zu unterscheiden, stellen jedoch keinen realen Nutzen sicher. Verwenden Sie unabhängige Evaluationsdaten, wiederholte Durchläufe, bei denen Varianz wichtig ist, Ablationsstudien und Vergleiche mit einfacheren Baselines. Große Parameterzahlen erhöhen zudem den Bedarf an Daten‑Governance, Rechenplanung und reproduzierbarer Konfiguration.
Bereitstellung tiefer Modelle sicher und effizient
Der Einsatz kann einen gehosteten Endpunkt, einen dedizierten Beschleuniger, Browser, Telefon oder ein eingebettetes Gerät nutzen. Export und Kompilierung können Operatoren zusammenführen, Gewichte und Aktivierungen quantisieren oder das numerische Verhalten ändern; daher sollte das bereitgestellte Artefakt validiert werden, nicht nur der Trainings‑Checkpoint. Messen Sie Cold‑Start, stabile Latenz, Durchsatz, Speicher, Energieverbrauch und Qualität bei realistischen Batch‑ und Sequenzgrößen. Kompressionsmethoden – Pruning, Distillation, Quantisierung und Low‑Rank‑Adaptation – tauschen Größe oder Geschwindigkeit gegen Genauigkeit und technische Komplexität aus und müssen für sensible Klassen und Randfälle bewertet werden.
Tiefe Modelle können bei Verteilungsverschiebungen, adversarialen Eingaben, irreführenden Korrelationen und schlecht repräsentierten Gruppen selbstbewusst versagen. Überwachen Sie Eingabe‑ und Ausgabeverteilungen, Aufgabenergebnisse, Kalibrierung, Ressourcenverbrauch und Versionsstände von Abhängigkeiten. Nutzen Sie Zugriffskontrollen, signierte Artefakte, geschützte Trainingsdaten, Red‑Team‑Tests und Raten‑Limits, die zum Bedrohungsmodell passen. Erklärungen wie Saliency‑Maps oder Attention‑Ansichten liefern diagnostische Evidenz, jedoch keinen Kausalitätsnachweis. Kombinieren Sie sie mit Verhaltens‑Tests, Counterfactuals, menschlicher Prüfung, Incident‑Response und expliziten Beschränkungen automatisierter Entscheidungen.
Praktisches Beispiel: Training eines Bilddefekt‑Detektors
Eine Fabrik sammelt Produktbilder von verschiedenen Kameras, Schichten, Materialien und bekannten Defektklassen und teilt sie anschließend nach Produktionscharge, sodass nahezu identische Stücke nicht über Partitionen hinweg gelangen. Ein kleiner konvolutionaler Baseline wird mit einem vortrainierten tiefen Netzwerk verglichen. Augmentation reproduziert validierte Beleuchtungs‑ und Blickwinkel‑Variationen, ohne Defekte zu entfernen. Die Bewertung berichtet den Recall pro Defekt, die False‑Reject‑Rate, Kalibrierung, Inferenz‑Latenz und die Robustheit gegenüber Unschärfe, Blendung, Kameratausch und seltenen Materialfarben.
Das exportierte Modell sowie der exakte Code für Größenänderung, Farbkorrektur und Normalisierung werden auf der Fertigungs‑Hardware getestet, um dauerhaften Durchsatz und thermisches Verhalten zu prüfen. Fälle mit geringer Sicherheit werden an Prüfer weitergeleitet; eine unabhängige Regel stoppt die Linie bei sicherheitskritischem Sensorsausfall. Bilder werden nur im erlaubten Umfang gespeichert und Modellartefakte sind signiert. Monitoring verknüpft Vorhersagen mit späteren Prüfergebnissen und Produktionschargen. Eine neue Kamera oder ein neues Material löst eine kontrollierte Neubewertung aus, anstatt stillschweigend online aus nicht überprüften Labels zu lernen.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenzen jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluations‑Datensatz vor dem Feintuning. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten benachteiligt werden. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung bzw. Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout sollten Verantwortlichkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollbacks und Stilllegung festgelegt werden. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlfunktionen. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für Reaktionen und prüfen Sie dann reale Evidenz nach dem Deployment, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Incident‑Lern‑, Lösch‑ und Aufbewahrungs‑Prozesse sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Primärreferenzen