Grundlagen der KI
Was sind RNNs und LSTMs im Deep Learning?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Recurrent neural networks (RNNs) verarbeiten Sequenzen, indem sie über die Zeit einen versteckten Zustand aktualisieren. Long short-term memory (LSTM) Netzwerke sind gesteuerte RNNs, die entwickelt wurden, um Informationen effektiver zu bewahren und zu steuern als eine einfache rekurrente Einheit.
RNNs und LSTMs dominierten einst viele Sprachaufgaben, doch moderne große Chatbots basieren hauptsächlich auf transformers. Rekurrente Modelle bleiben nützlich für Streaming, Zeitreihen, Sprache, Steuerung und ressourcenbeschränkte Systeme, bei denen inkrementeller Zustand und geringe Latenz wichtig sind.
Wesentliche Erkenntnisse
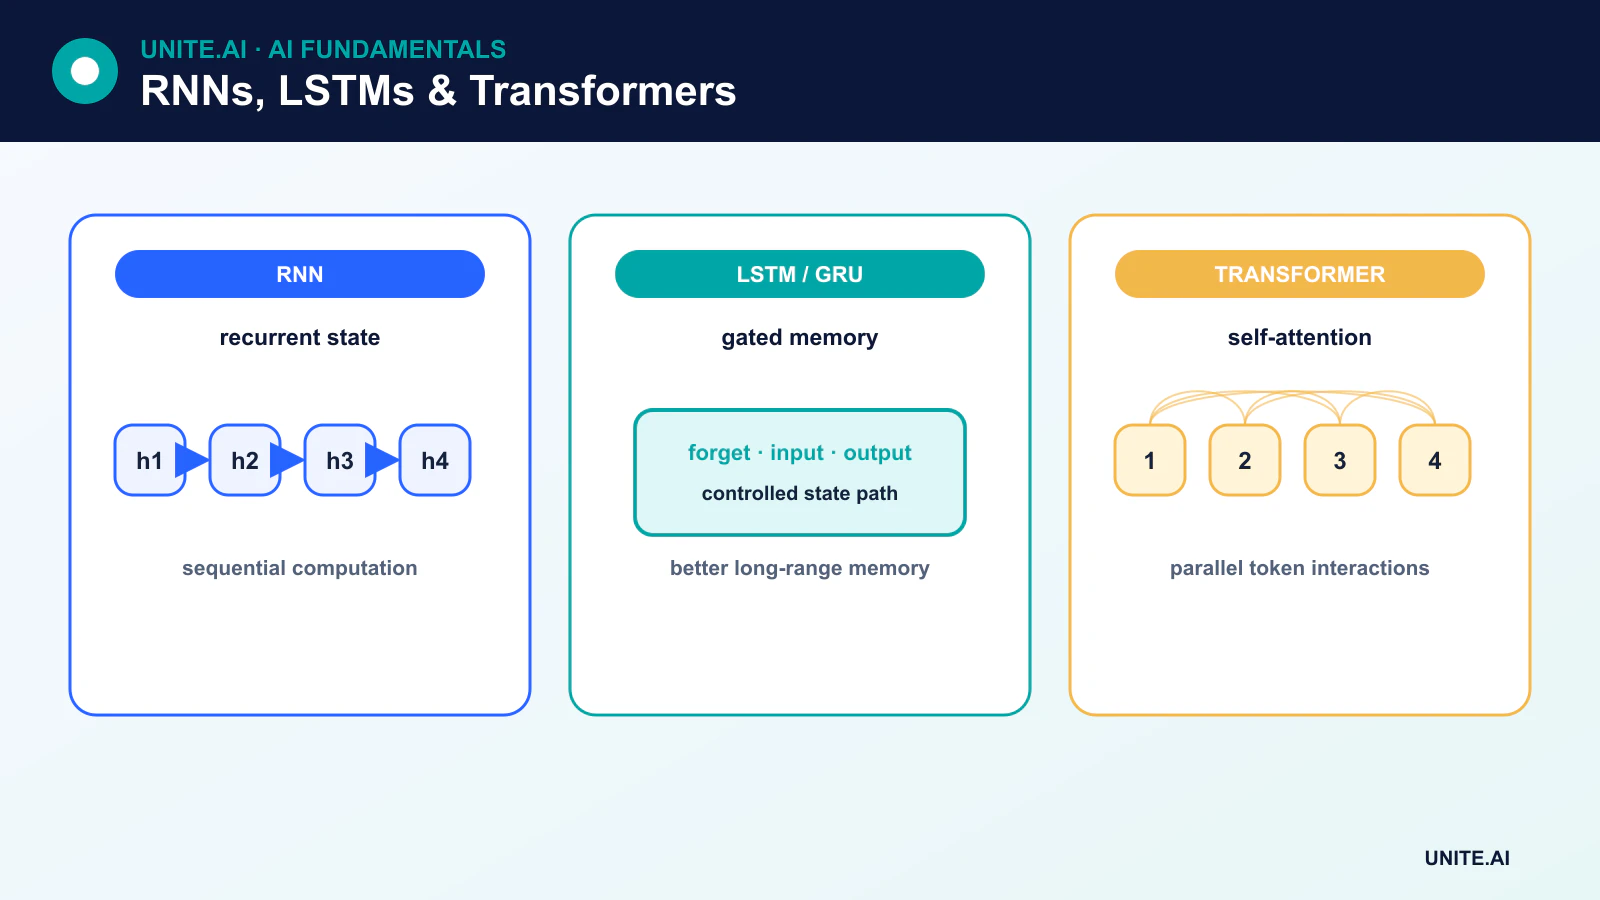
- Ein RNN verwendet bei jedem Sequenzschritt dieselben Parameter erneut und trägt einen versteckten Zustand weiter.
- Das Training über die Zeit kann zu verschwindenden oder explodierenden Gradienten führen.
- Ein LSTM fügt einen Zellzustand sowie Eingangs-, Vergessens- und Ausgangs‑Gates hinzu.
- Transformer verarbeiten langfristige Beziehungen und paralleles Training anders; keine der beiden Architekturen ist für jede Anwendung optimal.
Wie ein einfaches RNN funktioniert
Im Schritt t kombiniert eine einfache rekurrente Einheit die aktuelle Eingabe xₜ mit dem vorherigen versteckten Zustand hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Der versteckte Zustand ist eine gelernte Zusammenfassung, die für den nächsten Schritt und je nach Aufgabe als Ausgabe verwendet wird. Ein „entrolltes“ Diagramm zeigt für jeden Zeitschritt eine Kopie, wobei alle Kopien dieselben Parameter teilen. Die Ausgabe wird nicht einfach als neuer Rohinput zurückkopiert; die Rekurrenz übergibt den versteckten Zustand durch eine definierte Transformation.
Rückpropagation durch die Zeit
RNNs werden mit Rückpropagation durch die Zeit (BPTT) trainiert. Die entrollte Sequenz bildet einen tiefen Berechnungsgraphen, und backpropagation berechnet, wie der Verlust von den geteilten rekurrenten Parametern abhängt.
Wiederholte Multiplikation kann dazu führen, dass Gradienten gegen Null schrumpfen oder unbegrenzt wachsen. Verschwindende Gradienten verhindern das Erlernen langer Abhängigkeiten; explodierende Gradienten erzeugen instabile Updates. Gradient Clipping behebt explodierende Gradienten, während Gating, Initialisierung, Normalisierung und kürzere Trainingsfenster helfen können.
Im Inneren einer LSTM-Zelle
Ein LSTM hält zusätzlich zum versteckten Zustand hₜ einen Zellzustand cₜ. Seine Gates sind gelernte, datenabhängige Steuerungen:
- Das Forget-Gate steuert, wie viel des vorherigen Zellzustands beibehalten wird.
- Das Input-Gate steuert, wie viel der Kandidateninformationen geschrieben wird.
- Das Output-Gate steuert, wie viel Zellinformation zum versteckten Zustand beiträgt.
Sigmoid-Ausgaben zwischen Null und Eins fungieren als weiche Gates, während ein tanh-transformierter Kandidat neuen Inhalt liefert. Der additive Zellzustands‑Pfad hilft, dass Gradienten erhalten bleiben, aber LSTMs garantieren keinen unbegrenzten Speicher und beseitigen nicht alle Optimierungsprobleme.
GRUs und bidirektionale Rekurrenz
Eine Gated Recurrent Unit (GRU) fasst die Gate-Mechanismen in einer einfacheren rekurrenten Zelle zusammen, ohne einen separaten LSTM‑ähnlichen Zellzustand. GRUs können schneller trainieren und bei manchen Aufgaben ähnlich gut abschneiden.
Ein bidirektionales RNN verarbeitet eine vollständige Sequenz in beide Richtungen und kombiniert die Zustände. Es kann zukünftigen Kontext für Tagging oder Kodierung nutzen, ist jedoch für kausales Streaming ungeeignet, wenn zukünftige Eingaben noch nicht verfügbar sind.
Sequenz-zu-Sequenz-Modelle
Encoder‑Decoder‑RNNs bilden eine Sequenz auf eine andere ab. Aufmerksamkeit (Attention) wurde eingeführt, damit ein Decoder verschiedene Encoder‑Zustände konsultieren kann, anstatt sich auf einen festen Vektor zu verlassen. Dieser Ansatz führte zur Transformer‑Architektur, die Rekurrenz durch auf Aufmerksamkeit basierende Blöcke ersetzte.
RNNs versus Transformer
Transformer verarbeiten Trainingspositionen parallel und erzeugen kurze Attention‑Pfade zwischen entfernten Tokens. RNNs verarbeiten den Zustand sequenziell, was die Parallelität einschränkt, aber während des Streamings einen konstant großen rekurrenten Zustand bietet. Die Inferenz von Transformern kann einen wachsenden Schlüssel‑Wert‑Cache benötigen, während ein RNN die Historie in seinem versteckten Zustand komprimiert und dabei Details verlieren kann.
Wählen Sie basierend auf Sequenzlänge, Datenumfang, Hardware, Latenz, Speicher und ob die Aufgabe offline oder im Streaming erfolgt. Hybride und State‑Space‑Architekturen bieten zusätzliche Kompromisse.
Aktuelle Anwendungsfälle
RNNs und LSTMs bleiben relevant für Vorhersagen, Anomalieerkennung, Sensorverarbeitung, Sprachkomponenten, Handschrift, eingebettete Steuerungen und low‑latency Sequenzmodellierung. Sie sind nicht die Standard‑Erklärung für aktuelle große Sprachmodelle oder KI‑Chatbots.
Rekurrenz, Gates und Sequenzspeicher
Ein rekurrentes neuronales Netzwerk verarbeitet eine Sequenz, indem es die aktuelle Eingabe mit einem aus vorherigen Schritten mitgeführten versteckten Zustand kombiniert. Geteilte Gewichte ermöglichen variable Sequenzlängen, und das Entrollen legt die Berechnung über die Zeit für das Training offen. Grundlegende RNNs können zeitliche Abhängigkeiten darstellen, doch Gradienten, die über lange Sequenzen wiederholt multipliziert werden, neigen zum Verschwinden oder Explodieren. Trunkierte Rückpropagation begrenzt Speicher und Rechenaufwand, während Gradient Clipping extreme Updates kontrolliert. Der versteckte Zustand ist eine gelernte Zusammenfassung, kein exaktes Abbild jedes früheren Tokens.
Long Short-Term Memory‑Netzwerke fügen einen Zellzustand sowie Eingangs‑, Vergessens‑ und Ausgangs‑Gates hinzu, die das Schreiben, Behalten und Offenlegen von Informationen regulieren. Gated Recurrent Units verwenden eine einfachere Reset‑ und Update‑Struktur. Bidirektionale Varianten nutzen zukünftigen Kontext und können daher nicht kausal ohne Verzögerung streamen. Gestapelte, Residual‑ und mit Attention erweiterte rekurrente Modelle erhöhen die Kapazität. Padding und Masken müssen verhindern, dass künstliche Sequenzelemente den Zustand oder den Verlust beeinflussen, und der Zustand sollte an echten Sequenzgrenzen zurückgesetzt werden, um Leckagen zwischen Beispielen zu vermeiden.
Training, Vergleich und zustandsbehaftete Bereitstellung
RNNs und LSTMs bleiben nützlich für Streaming, kompakte On‑Device‑Modelle, Zeitreihen und Workloads, bei denen sequenzieller Zustand effizient ist. Transformer parallelisieren das Training und modellieren langfristige Interaktionen anders, können jedoch mehr Speicher und Cache benötigen. Vergleichen Sie Architekturen hinsichtlich Genauigkeit, Latenz, Durchsatz, Speicher, Energie und Leistung, wenn sich die Sequenzlänge ändert. Bewerten Sie Vorhersagen mit rollierenden Zeitsplits, Sprache mit sequenzbewussten Metriken und Anomalieerkennung mit ereignisbezogenen Messungen. Untersuchen Sie Fehler nach langen Lücken, Regimewechseln, fehlenden Proben und abrupten Sequenzgrenzen.
Zustandsbehaftete Bereitstellung muss den versteckten Zustand der richtigen Sitzung zuordnen, ihn verfallen lassen, bei sensiblen Daten verschlüsseln und nach Fehlern oder Modelländerungen zurücksetzen. Out‑of‑Order‑ oder duplizierte Ereignisse können den Zustand beschädigen; fügen Sie Zeitstempel, Sequenznummern und Idempotenz hinzu. Überwachen Sie das Alter des Zustands, die Sequenzlänge, Fehlende Werte, Output‑Drift und Latenz. Quantisierung erfordert gate‑sensitivierte Validierung, da kleine numerische Änderungen über die Zeit akkumulieren können. Der RNN‑Speicher ermöglicht Kontext, kann jedoch auch private oder veraltete Informationen bewahren, sodass Aufbewahrung und Nutzerkontrollen im Design berücksichtigt werden müssen.
Praktisches Beispiel: ein LSTM für Streaming‑Sensorsequenzen
Ein Dienst nutzt ein LSTM, um die Kurzzeitlast aus aktuellen Messungen, Kalender und Wetter vorherzusagen. Sequenzen werden in strikter zeitlicher Reihenfolge aufgebaut; der versteckte Zustand wird an Einspeiser‑Grenzen zurückgesetzt und Padding wird maskiert. Saisonale naive und gradient‑verstärkte Baselines werden mit dem LSTM über rollierende Fenster verglichen. Tests decken fehlende Intervalle, verzögertes Wetter, Feiertage, Ausfälle und Sequenzlängen über das übliche Training hinaus ab.
Der Streaming‑Dienst verknüpft den Zustand mit einem Einspeiser, verwirft out‑of‑Order‑Duplikate und lässt den Zustand nach langen Lücken oder Modell‑Updates verfallen. Eine sichere statistische Vorhersage ersetzt die Ausgabe, wenn Sensoren oder der Zustand ungültig sind. Quantisierte Inferenz wird über lange Sequenzen auf akkumulierten Drift geprüft. Das Monitoring verfolgt das Alter des Zustands, Fehlende Werte, Latenz, Bias und Intervallfehler. Das Modell wird nur nach Netzänderungen neu trainiert, und die überprüften Ergebnisse zeigen, dass die gelernten zeitlichen Zusammenhänge nicht mehr verallgemeinerbar sind.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluationsdatensatz vor der Feinabstimmung. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Verantwortlichkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollbacks und Stilllegung zugewiesen werden. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingespeisten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, die Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und prüfen Sie dann Evidenz aus der Praxis nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Vorfällen, Lösch‑ und Aufbewahrungs‑Prozeduren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist ein LSTM immer besser als ein einfaches RNN?
Nein. Gating hilft bei vielen Langzeit‑Abhängigkeits‑Problemen, erhöht jedoch den Rechenaufwand und die Parameterzahl. Ein einfaches RNN kann für kurze, einfache Sequenzen ausreichend sein, und eine andere Architektur kann bei sehr langen Kontexten besser geeignet sein.
Kann ein LSTM eine unbegrenzte Historie verarbeiten?
Nein. Sein Zustand hat eine endliche Kapazität, Gradienten und Trainingsdaten setzen Grenzen, und relevante Details können überschrieben werden. Die Leistung bei langen Kontexten muss gemessen werden, anstatt sie aus dem Namen der Architektur abzuleiten.
Primärreferenzen