Grundlagen der KI
Was sind neuronale Netze?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Ein künstliches neuronales Netzwerk ist ein parametrisiertes mathematisches Modell, das aus Schichten verbundener Operationen besteht. Während des Trainings passt das Netzwerk seine Parameter an, sodass Eingaben auf nützliche Ausgaben abgebildet werden. Neuronale Netze können komplexe nichtlineare Zusammenhänge approximieren und Repräsentationen direkt aus Text, Bildern, Audio, Zeitreihen und anderen Daten lernen.
Der Name ist historisch von biologischen Neuronen inspiriert, doch moderne Netze sind technische Systeme und keine realistischen Simulationen des Gehirns. Begriffe wie „Neuron“ und „Lernen“ sind nützliche Abkürzungen und sollten nicht fälschlich als Hinweis auf menschliche Kognition verstanden werden.
Wesentliche Erkenntnisse
- Ein Neuron berechnet eine gewichtete Summe, fügt einen trainierbaren Bias hinzu und wendet eine Aktivierungsfunktion an.
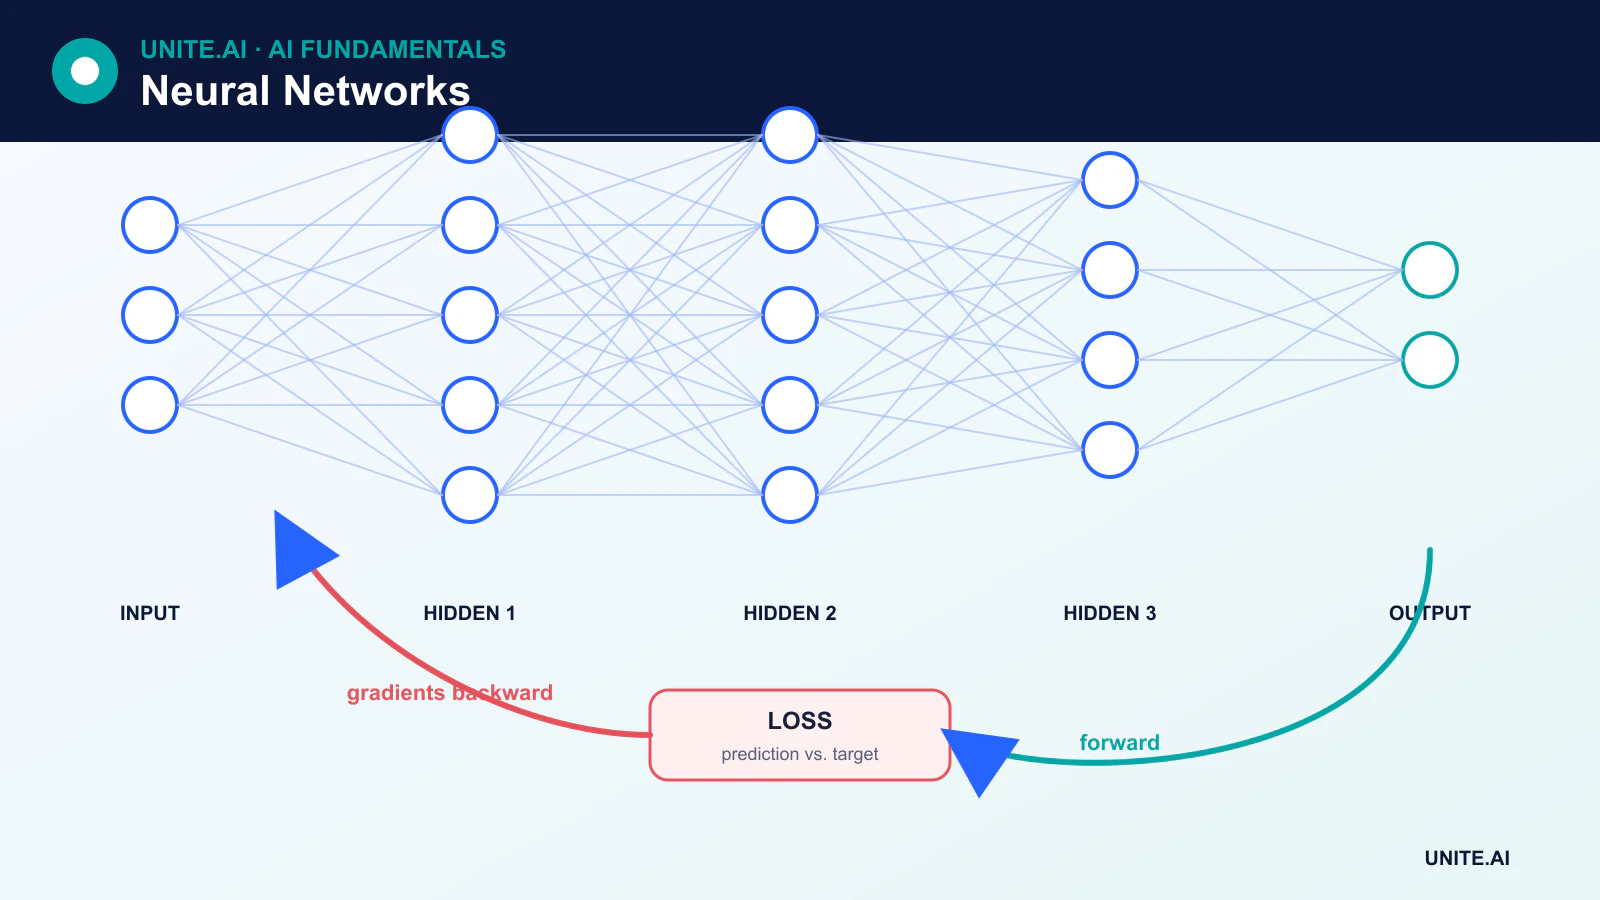
- Ein Forward‑Pass erzeugt Vorhersagen; ein Loss misst den Fehler; Backpropagation berechnet Gradienten; ein Optimierer aktualisiert die Parameter.
- MLPs, CNNs, RNNs und Transformer organisieren die Verbindungen unterschiedlich.
- Mehr Schichten oder Parameter führen nicht automatisch zu einem besseren oder vertrauenswürdigeren Modell.
Von einem einzelnen künstlichen Neuron zu einem Netzwerk
Für einen Eingabevektor x berechnet eine Basiseinheit:
z = Wx + boutput = activation(z)
W enthält trainierbare Gewichte und b ist ein trainierbarer Bias. Die Aktivierungsfunktion führt Nichtlinearität ein. Die Gewichte „durchlaufen“ die Aktivierung nicht von selbst; die Aktivierung wird auf die gewichtete Summe und den Bias angewendet.
Ein Multilayer‑Perzeptron (MLP) stapelt dichte Schichten. Die Eingabeschicht repräsentiert die Merkmale, verborgene Schichten transformieren sie, und die Ausgabeschicht ist für die Aufgabe konzipiert – zum Beispiel Klassen‑Logits oder einen Regressionswert.
Wie neuronale Netze lernen
- Das Modell initialisiert die trainierbaren Parameter.
- Ein Forward‑Pass verarbeitet ein Batch und erzeugt Vorhersagen.
- Eine Verlustfunktion vergleicht die Vorhersagen mit dem Trainingsziel.
- Backpropagation verwendet die Kettenregel, um Gradienten zu berechnen.
- Ein Optimierer wie Stochastic Gradient Descent oder AdamW aktualisiert Gewichte und Biases.
Backpropagation wurde durch über mehrere Jahrzehnte entwickelte und popularisierte Arbeiten zum zentralen Bestandteil des Trainings neuronaler Netze; es wurde nicht erst in der jüngsten Deep‑Learning‑Ära geschaffen. Moderne Frameworks implementieren die automatische Differenzierung im Reverse‑Mode, sodass Praktiker nicht jede Ableitung manuell durchführen müssen.
Warum Aktivierungsfunktionen wichtig sind
Ohne nichtlineare Aktivierungen kollabieren mehrere gewöhnliche lineare Schichten zu einer einzigen linearen Transformation. ReLU wird häufig verwendet, weil es einfach und effizient ist. GELU und SiLU sind in modernen Architekturen üblich. Sigmoid und Softmax bleiben für bestimmte Ausgabeinterpretationen nützlich, jedoch kann Sigmoid in verborgenen Schichten sättigen und zu verschwindenden Gradienten führen.
Wichtige Architekturen neuronaler Netze
Faltungsneuronale Netze
CNNs wenden gelernte Filter über lokale Nachbarschaften an und teilen Parameter über Positionen hinweg. Diese Eigenschaften machen sie effizient für Bilder und andere gitterartige Signale.
Rekurrente Netze
RNNs, LSTMs und GRUs aktualisieren einen verborgenen Zustand über eine Sequenz. Sie bleiben nützlich für Streaming‑ und Zeitreihenaufgaben, obwohl Rekurrenz die Parallelverarbeitung einschränkt und bei langen Abhängigkeiten Probleme verursachen kann.
Transformer
Transformers verwenden Attention, um kontextabhängige Repräsentationen zu erzeugen. Residual‑Verbindungen, Normalisierung, Positionsinformationen und Feed‑Forward‑Blöcke sind zentrale Bestandteile der Architektur. Transformer bilden heute die Grundlage vieler großer Sprach‑ und multimodaler Modelle.
Autoencoder und generative Netze
Autoencoders lernen Repräsentationen durch Rekonstruktion. GANs, Diffusionsmodelle und autoregressive Netze erzeugen neue Stichproben mittels unterschiedlicher Ziele und Trainingsverfahren.
Komponenten, die tiefe Netze trainierbar machen
Moderne Systeme nutzen mehr als nur Schichten und Aktivierungen. Residual‑Verbindungen ermöglichen es Informationen und Gradienten, Blöcke zu umgehen. Normalisierung stabilisiert Aktivierungen. Regularisierung, Datenaugmentation, Dropout und Weight‑Decay können Overfitting reduzieren. Embedding‑Schichten bilden diskrete Elemente wie Tokens auf Vektoren ab. Attention lässt eine Repräsentation dynamisch von anderen Elementen abhängen.
Stärken und Einschränkungen
Neuronale Netze können Merkmale aus hochdimensionalen Rohdaten lernen und mit Datenmenge sowie Rechenleistung skalieren. Sie können jedoch große Datensätze, spezialisierte Hardware und sorgfältige Abstimmung erfordern. Ihre Vorhersagen können schlecht kalibriert, bei Verteilungsverschiebungen spröde, anfällig für adversariale Manipulationen oder schwer erklärbar sein.
Die Architektur sollte der Aufgabe und den Bereitstellungsbedingungen entsprechen. Für viele tabellarische Probleme kann ein Baum‑Ensemble oder ein lineares Modell schneller und leichter zu validieren sein. Für Anwendungen mit hohen Risiken muss die Modellleistung nach Untergruppen und Fehlermodi bewertet werden, nicht nur anhand eines aggregierten Benchmarks.
Schichten, Aktivierungen und Informationsfluss
Ein neuronales Netzwerk setzt parametrische Funktionen zusammen. Jede Einheit bildet eine gewichtete Kombination der Eingaben, fügt einen Bias hinzu und leitet das Ergebnis durch eine Aktivierung wie ReLU, Sigmoid, Tanh oder GELU. Das Stapeln von Schichten ermöglicht hierarchische Merkmale und nichtlineare Entscheidungsgrenzen. Die Breite bestimmt die Einheiten pro Schicht; die Tiefe steuert aufeinanderfolgende Transformationen; Konnektivität und Gewichtsteilung kodieren die Architektur. Die Ausgabe des Netzwerks hängt von Vorverarbeitung, Parametern, Normalisierung und Inferenzmodus gemeinsam ab. Ein Neuron ist ein mathematischer Vorgang, kein wörtliches biologisches Neuron oder ein eigenständig bedeutungsvolles Konzept.
Die Vorwärtspropagation berechnet Vorhersagen; ein Loss quantifiziert den Fehler; Backpropagation wendet die Kettenregel auf Gradienten an; ein Optimierer aktualisiert die Parameter. Initialisierung, Lernrate, Batch‑Statistiken, Residual‑Pfade und Normalisierung beeinflussen, ob Gradienten verschwinden, explodieren oder nützlich bleiben. Regularisierung umfasst Weight‑Decay, Dropout, Augmentation, Early Stopping und architektonische Beschränkungen. Plotten Sie Trainings‑ und Validierungsverhalten, inspizieren Sie Gradient‑ und Aktivierungsstatistiken und vergleichen Sie wiederholte Durchläufe. Ein großes Netzwerk kann Trainingsdaten auswendig lernen, während ein kleines unterfitten oder notwendige Strukturen verfehlen kann.
Auswahl, Bewertung und Bereitstellung von Architekturen
Multilayer‑Perzeptren verarbeiten feste Vektoren; Faltungsnetze nutzen lokale Strukturen; rekurrente und State‑Space‑Modelle verarbeiten Sequenzen; Transformer verwenden Attention; Graph‑Netze tauschen Informationen entlang von Kanten aus. Hybride sind üblich. Wählen Sie basierend auf induktiver Voreingenommenheit, Daten, Sequenz‑ oder Bildgröße, Latenz, Speicher, Interpretierbarkeit und verfügbarer Hardware. Evaluieren Sie gegenüber einem linearen oder baumbasierten Baseline und führen Sie Ablationsstudien durch, um zu lernen, welche Komplexität relevant ist. Die reine Parameterzahl sagt weder Qualität, Inferenzkosten noch Datenbedarf voraus.
Der Service erfordert eingefrorene Vorverarbeitung, einen exportierten oder kompilierten Graphen, numerische Validierung und Ressourcentests unter realistischen Lastbedingungen. Quantisierung und Pruning können die Größe reduzieren, können jedoch das Verhalten seltener Klassen verändern. Überwachen Sie Eingaben, Ausgaben, Kalibrierung, Latenz und bestätigte Ergebnisse; testen Sie adversariale und verschobene Daten. Schützen Sie Modelle, Abhängigkeiten und Daten durch signierte Artefakte, Zugriffskontrolle und Lieferketten‑Review. Erklärungen aus einzelnen Aktivierungen oder Salienz erfordern kausale und verhaltensbezogene Verifikation. Neuronale Netze sind flexible Funktionsapproximatoren, keine Garantien für Verständnis, Wahrheit oder Robustheit.
Praktisches Beispiel: ein neuronaler Nachfrage‑Forecaster
Ein Einzelhändler prognostiziert die wöchentliche Artikelnachfrage anhand von Verkäufen, Aktionen, Preis, Feiertagen, Verfügbarkeit und Wetter. Das Netzwerk wird mit saisonal‑naiven, linearen und baumbasierten Baselines unter Verwendung rollierender Zeitsplits verglichen. Zukünftige Aktionen werden nur dann einbezogen, wenn sie zum Prognosezeitpunkt tatsächlich bekannt sind, während Fehlbestände modelliert werden, weil beobachtete Verkäufe die Nachfrage unterschätzen können. Die Bewertung nutzt gewichteten absoluten Fehler, Bias, Intervallabdeckung und Ergebnisse nach Artikel‑Velocity und Filiale.
Die Service‑Pipeline versioniert Feature‑Verfügbarkeit, Modell und Zeithorizont und verweigert eine Prognose, wenn erforderliche Eingaben veraltet sind. Planer sehen Intervalle und können mit aufgezeichneten Gründen überschreiben. Monitoring erkennt fehlende Feeds, sich ändernde Fehler, Bias und ungewöhnliche Prognosen; Geschäftsergebnisse werden von der Prognosegenauigkeit getrennt, da die Bestellpolitik ebenfalls den Lagerbestand beeinflusst. Ein Modell‑Update wird über mehrere Zyklen hinweg im Schatten ausgeführt, und der vorherige Forecaster bleibt für Rollbacks während saisonaler oder Lieferanten‑Störungen verfügbar.
Implementierungsnachweis und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenzen jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Verantwortlichkeiten für Release, Ausnahmen, Änderungen, Rollback und Stilllegung zugewiesen werden. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingesetzten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für Reaktionen und prüfen Sie dann Evidenz aus der Praxis nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Vorfalls‑Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Ist jedes neuronale Netzwerk Deep Learning?
Nein. Ein kleines Netzwerk mit einer verborgenen Schicht ist ein neuronales Netzwerk, während Deep Learning im Allgemeinen Architekturen mit mehreren gelernten Verarbeitungsebenen bezeichnet. Die Grenze ist konventionell und nicht ein strenger wissenschaftlicher Schwellenwert.
Speichern neuronale Netzwerke ihre Trainingsdaten?
Sie speichern gelernte Parameter, nicht eine gewöhnliche durchsuchbare Kopie des Datensatzes. Dennoch können große Modelle einzelne Trainingsbeispiele auswendig lernen und reproduzieren, was Datenschutz‑ und Urheberrechtsrisiken erzeugt, die getestet werden müssen.
Primärreferenzen