Grundlagen der KI
Was ist Dimensionsreduktion?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
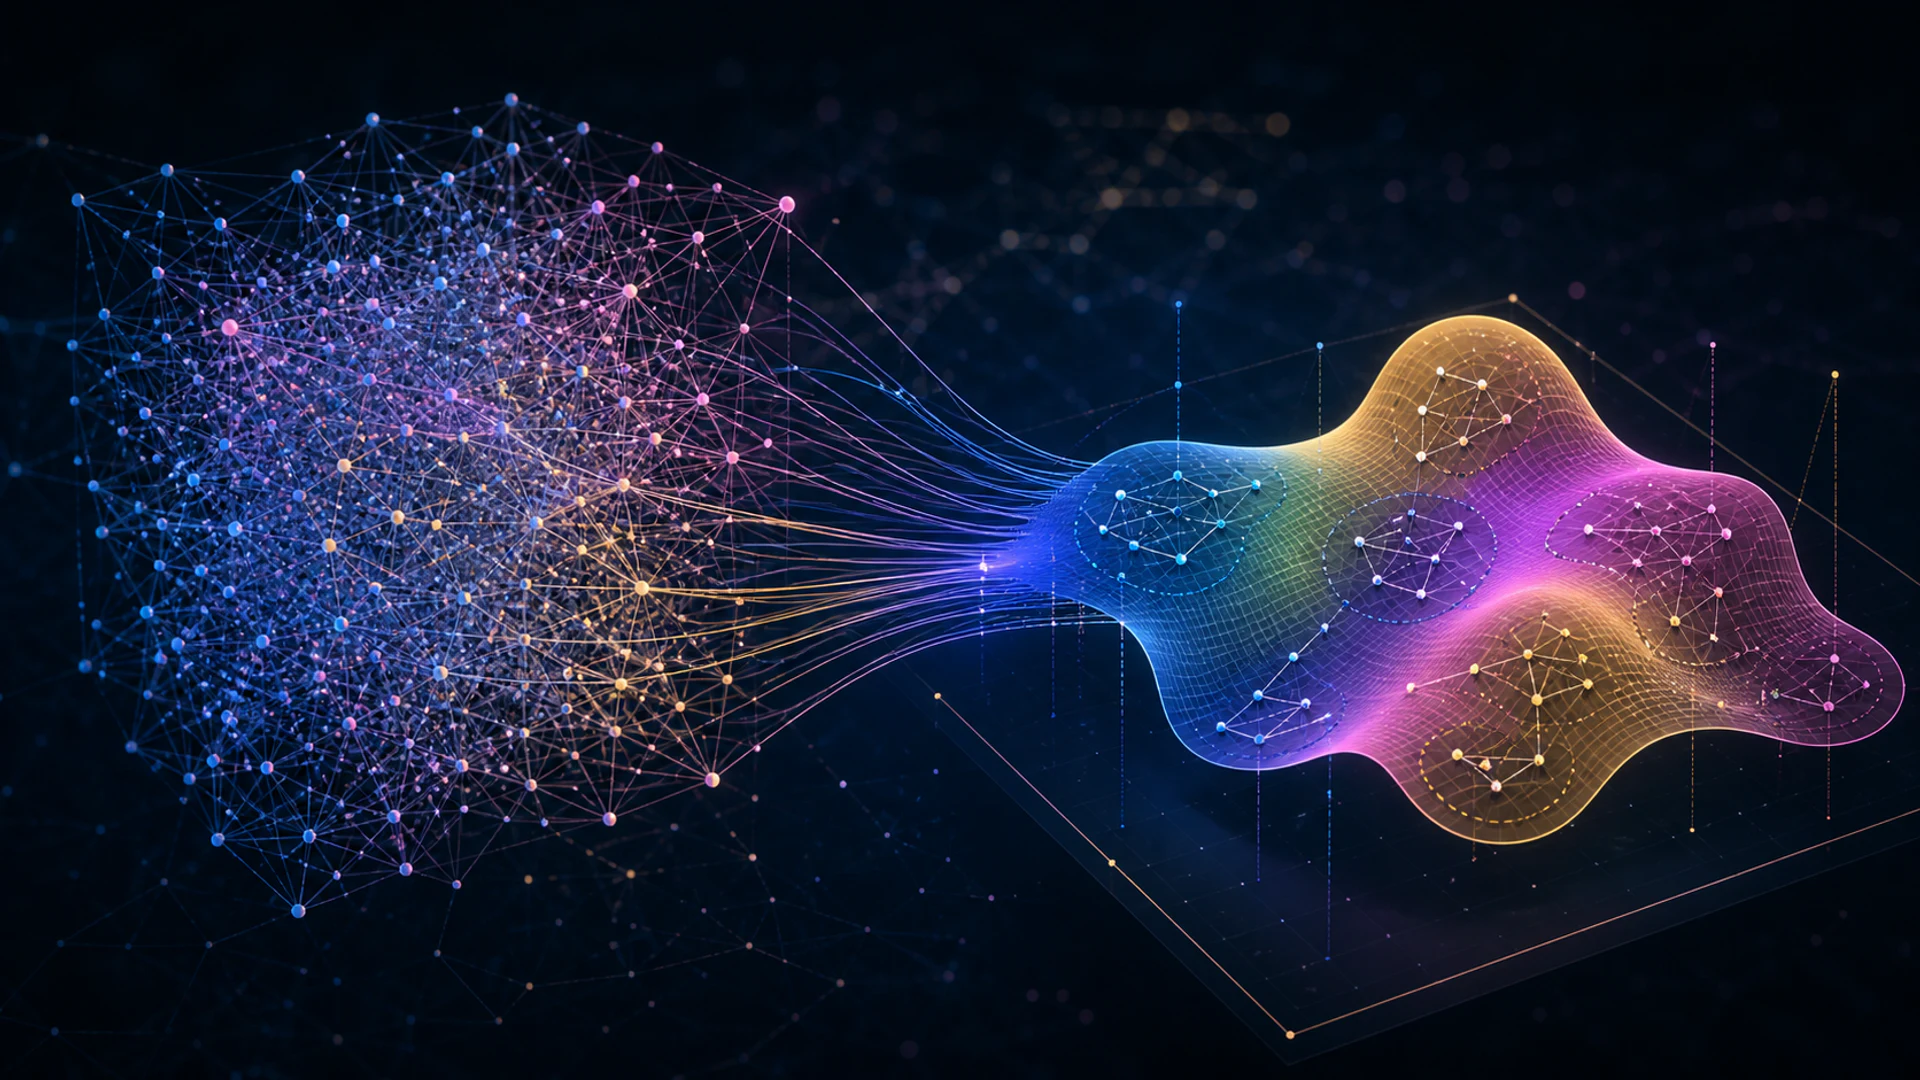
Dimensionsreduktion stellt Daten mit weniger Variablen dar, während sie für eine Aufgabe nützliche Informationen bewahrt. Sie kann Speicherbedarf und Rauschen reduzieren, die Visualisierung verbessern, redundante Merkmale mindern und nachgelagerte Modelle leichter trainierbar machen.
Keine Methode bewahrt jede Beziehung. Eine sinnvolle Reduktion beginnt damit, festzulegen, was erhalten bleiben soll: Varianz, Klassentrennung, lokale Nachbarschaften, globale Geometrie, Rekonstruktionsqualität oder Interpretierbarkeit.
Wesentliche Erkenntnisse
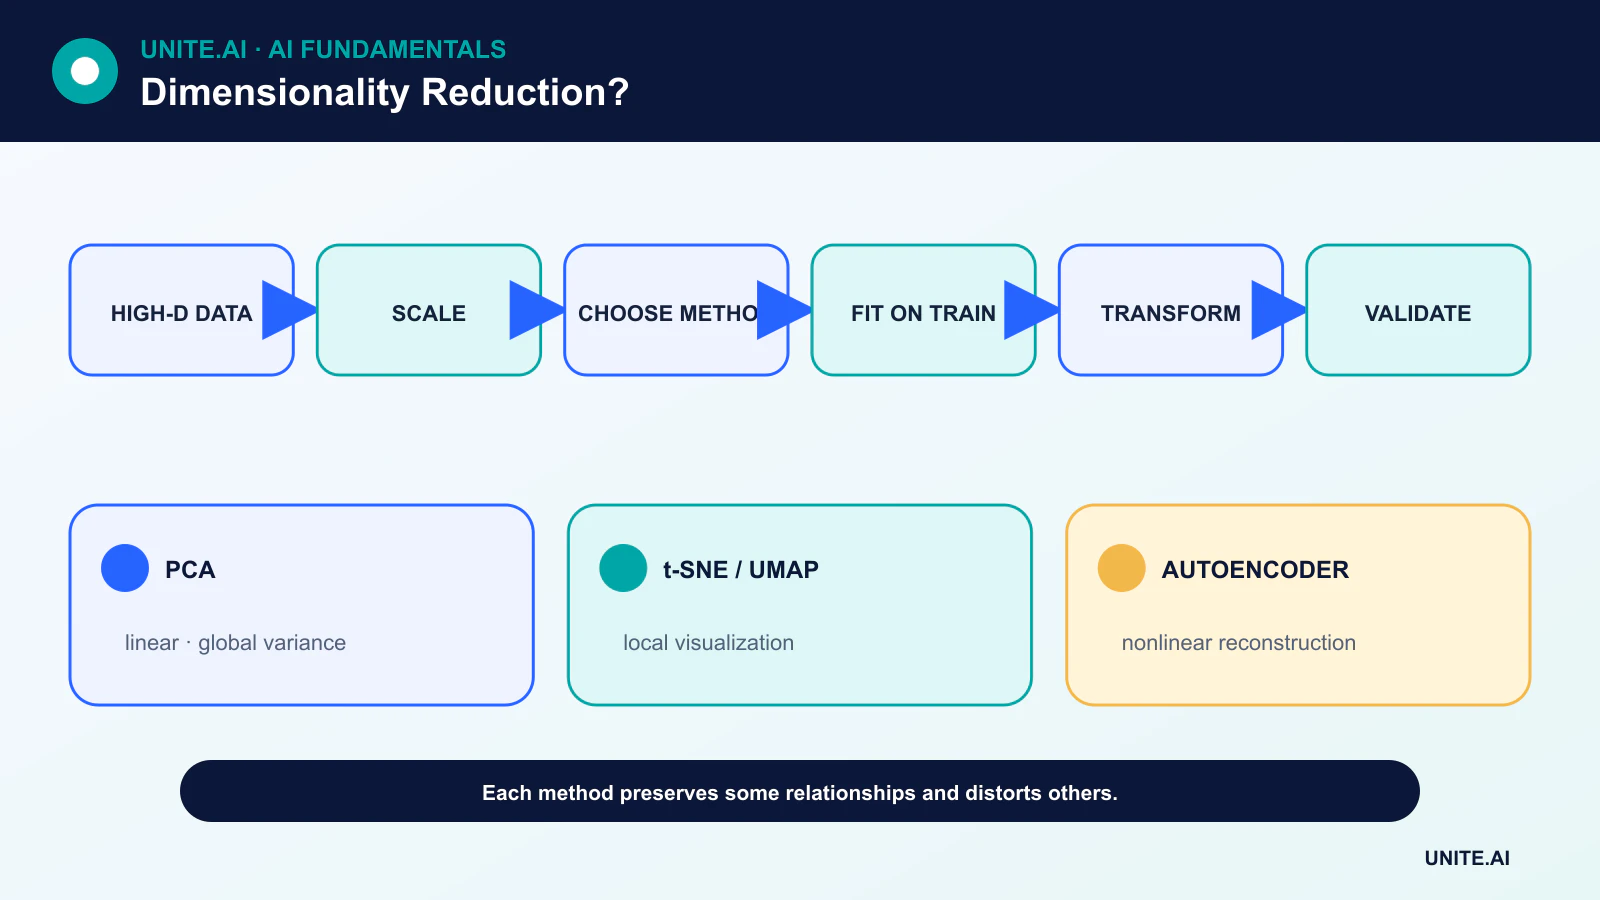
- Feature‑Auswahl behält die ursprünglichen Variablen bei; Feature‑Extraktion erzeugt neue, niedrigdimensionale Koordinaten.
- PCA ist linear und varianzorientiert; t‑SNE und UMAP betonen die Nachbarschaftsstruktur für die Visualisierung.
- Visualisierungs‑Embeddings können Entfernungen, Clustergrößen und globale Trennung verzerren.
- Reduktion nur auf Trainingsdaten anpassen und anschließend die erlernte Transformation auf Validierungs‑ und Testdaten anwenden.
Feature‑Auswahl versus Projektion
Feature‑Auswahl entfernt Variablen anhand von Fachregeln, Fehlwerten, Redundanz, prädiktiven Tests oder Regularisierung. Sie bewahrt die ursprüngliche Bedeutung, was Governance und Erklärbarkeit unterstützen kann.
Projektionsmethoden kombinieren Variablen zu neuen Koordinaten. Sie können verteilte Strukturen erfassen, machen jedoch jede Koordinate schwerer interpretierbar. Ein Autoencoder lernt eine nichtlineare Projektion durch Rekonstruktion.
PCA und SVD
Die Hauptkomponentenanalyse (Principal Component Analysis) identifiziert nach Zentrierung der Daten orthogonale Richtungen abnehmender Varianz. Die Singulärwertzerlegung (Singular Value Decomposition) bietet einen gängigen numerischen Weg. Skalierung ist wichtig: eine Messgröße mit hoher Varianz kann die Komponenten dominieren.
PCA ist bis auf Vorzeichen und mehrfache Eigenwerte deterministisch, unterstützt die Transformation von Daten außerhalb des Trainings und liefert Zusammenfassungen der erklärten Varianz. Hohe Varianz ist nicht immer aufgabenrelevant, und lineare Komponenten können nicht jedes gekrümmte Mannigfaltigkeit entfalten.
t‑SNE und UMAP
t‑SNE konstruiert Wahrscheinlichkeitsverteilungen über Nachbarn und optimiert eine niedrigdimensionale Karte, die lokale Ähnlichkeit betont.
UMAP erstellt einen gewichteten Nachbarschaftsgraphen und optimiert eine niedrigdimensionale Darstellung mit verwandten Zielen für die lokale Struktur.
Beide sind leistungsfähige explorative Werkzeuge, jedoch empfindlich gegenüber Vorverarbeitung, Distanzmetrik und Hyperparametern. Leerer Raum, Cluster‑Fläche und Abstand zwischen Clustern in einer 2‑D‑Darstellung sollten nicht automatisch als reale Interpretation angesehen werden.
Überwachte Methoden und aufgabenbewusste Repräsentationen
Lineare Diskriminanzanalyse verwendet Klassenlabels, um Trennung zu suchen, und unterscheidet sich damit von unüberwachtem PCA.
Neuronales Repräsentationslernen kann Vorhersage‑ oder kontrastive Ziele optimieren, anstatt Rekonstruktion.
Werden Labels zur Steuerung der Reduktion verwendet, müssen alle Anpassungen und Abstimmungen innerhalb des Trainingsprozesses bleiben. Andernfalls kann Information aus dem Testset in die Modellauswahl einfließen und ein zu optimistisches Ergebnis erzeugen.
Auswahl und Validierung einer Methode
Beginnen Sie mit Vorverarbeitung und einer einfachen Basislinie. Für Kompression messen Sie Rekonstruktion oder nachgelagerte Leistung über verschiedene Dimensionalitäten hinweg. Für Visualisierung testen Sie die Stabilität über verschiedene Zufallsstarts und Hyperparameter und vergleichen die Erhaltung der Nachbarschaft mit Domänenwissen.
Für den Produktionseinsatz fragen Sie, ob die Methode neue Datensätze transformieren kann, wie sie mit fehlenden Werten umgeht, ob sie sich beim Retraining ändert und ob Nutzer Erklärungen zu den Original‑Features benötigen. Overfitting kann im Reduktionsschritt genauso auftreten wie im endgültigen Modell.
Lineare und nichtlineare Reduktionsmethoden
Dimensionsreduktion projiziert hochdimensionale Daten in weniger Koordinaten, wobei ausgewählte Strukturen erhalten bleiben. Die Hauptkomponentenanalyse findet nach Zentrierung orthogonale Richtungen maximaler Varianz; Skalierung ist nötig, wenn Einheiten vergleichbar beitragen sollen. Die Singulärwertzerlegung berechnet die zugehörige niedrigrangige Struktur und unterstützt spärliche Matrizen. Die lineare Diskriminanzanalyse nutzt Labels, um klassentrennende Richtungen zu finden. Diese Verfahren liefern explizite Transformationen, jedoch können Varianz oder Klassentrennung die für nachgelagerte Aufgaben erforderlichen Informationen nicht bewahren.
Mannigfaltigkeits‑Methoden wie t‑SNE und UMAP konstruieren Nachbarschaften und optimieren ein niedrigdimensionales Layout. Sie sind für die Exploration leistungsfähig, verzerren jedoch globale Entfernungen, Dichte, Clustergröße und manchmal die Trennung. Die Ergebnisse hängen von Vorverarbeitung, Metrik, Nachbarschafts‑ oder Perplexitäts‑Einstellungen, Initialisierung und Zufallsseed ab. Ein ansprechender Cluster in zwei Dimensionen kann sogar ohne diskrete Gruppen entstehen. Verwenden Sie mehrere Einstellungen, färben Sie nur nach Metadaten, die nicht beim Fitten verwendet wurden, und validieren Sie die scheinbare Struktur im Originalraum oder mit unabhängigen Labels.
Feature‑Auswahl, Embeddings und Evaluation
Feature‑Auswahl behält die ursprünglichen Variablen durch Filter, Wrapper oder modellbasierte Wichtigkeit bei; Repräsentationslernen erzeugt neue latente Merkmale mittels Autoencodern oder überwachten Modellen. Zufällige Projektionen erhalten Entfernungen unter bestimmten Bedingungen annähernd und bieten effiziente Baselines. Wählen Sie die Methode basierend auf Kompression, Visualisierung, Rauschreduktion, Geschwindigkeit, Speicherbedarf oder Modellleistung. Passen Sie den Reduktor nur auf Trainingsdaten an und transformieren Sie anschließend Validierungs‑ und Testsets. Überwachte Reduktion muss innerhalb der Kreuzvalidierung verschachtelt sein, um ein Leck von Labels zu vermeiden.
Bewerten Sie erklärte Varianz oder Rekonstruktion für lineare Kompression, Vertrauenswürdigkeit und Erhaltung der Nachbarschaft für Visualisierung sowie nachgelagerte Genauigkeit, Kalibrierung, Latenz und Robustheit für Vorhersagen. Messen Sie die Stabilität über Stichproben und Seeds. Prüfen Sie, ob seltene Klassen oder sensible Gruppen zusammengefasst werden und ob eine inverse Abbildung möglich ist. Reduzierte Koordinaten können weiterhin private Informationen enthalten; ein zweidimensionales Diagramm ist keine Anonymisierung. Dokumentieren Sie die Transformation, Skalierung, Feature‑Reihenfolge und Einschränkungen.
Einsatz in der Produktion
Der Einsatz erfordert die exakt angepasste Transformation und das Eingabeschema. Überwachen Sie fehlende Merkmale, Bereichsverschiebungen, Verteilung der Komponenten‑Scores, Rekonstruktionsfehler und nachgelagerte Ergebnisse. Wenn neue Kategorien oder Sensoren auftauchen, retrainieren und versionieren Sie die gesamte Pipeline, anstatt stillschweigend Spalten anzuhängen. Reduktion kann die Rechenleistung verbessern und ein Modell entrauschen, kann jedoch auch schwache Signale, die für seltene Ereignisse wichtig sind, verwerfen. Betrachten Sie sie als einen erlernten Messschritt, dessen erhaltene und verlorene Informationen gegen die Entscheidungsfindung geprüft werden müssen.
Praktisches Beispiel: Reduktion von Kundenverhaltens‑Features
Ein Analyst standardisiert 200 Verhaltensmaße und führt PCA nur auf den Trainings‑Kunden durch. Die Kreuzvalidierung wählt die Anzahl der Komponenten anhand der nachgelagerten Abwanderungs‑Leistung und Stabilität, nicht anhand eines zweidimensionalen Streudiagramms. Die Ladungen werden auf dominierende Quellen und Fehlwerte geprüft. PCA, Feature‑Auswahl, zufällige Projektion und ein nicht reduziertes regularisiertes Modell werden hinsichtlich Kalibrierung, Latenz und Ergebnissen für seltene Kundensegmente verglichen. Wiederholte Stichproben testen zudem, ob die führenden Komponenten und nachgelagerten Schlussfolgerungen stabil bleiben.
Die bereitgestellte Pipeline fixiert Feature‑Reihenfolge, Skalierer und Komponenten und verwirft fehlende Schema‑Versionen. Das Monitoring verfolgt Komponenten‑Verteilungen, Rekonstruktionsfehler und nachgelagerte Ergebnisse. Eine Visualisierung mit scheinbaren Clustern dient zur Generierung von Fragen, nicht zur Zuordnung von Kunden‑Personas. Da latente Komponenten weiterhin das Verhalten kodieren, bleiben Zugriff und Bindung kontrolliert. Ändern sich die Quell‑Definitionen, werden die gesamte Transformation und das Modell neu erstellt und validiert, anstatt inkompatible Daten in alte Komponenten zu projizieren.
Implementierungsnachweis und betriebliche Bereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Verantwortlichen und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout weisen Sie Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollbacks und Stilllegung zu. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und verifizieren Sie das Monitoring mit bewusst eingespeisten Fehlfunktionen. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Eingriffe und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion und prüfen Sie anschließend Evidenz aus der Praxis nach dem Deployment, anstatt anzunehmen, dass Offline‑Leistungen fortbestehen. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Zeitpunkt, zu dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Verbessert Dimensionsreduktion immer ein Modell?
Nein. Sie kann prädiktive Informationen verwerfen oder die Interpretation erschweren. Vergleichen Sie mit einer Basislinie ohne Reduktion auf gehaltenen Daten.
Beweisen getrennte t‑SNE‑Cluster, dass reale Klassen existieren?
Nein. Die Karte ist eine optimierte Visualisierung von Nachbarschaftsbeziehungen und kann scheinbare Trennungen erzeugen. Validieren Sie Cluster mit unabhängigen Evidenzen.
Primärreferenzen