
Grundlagen der KI
Was ist Few-Shot Learning?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
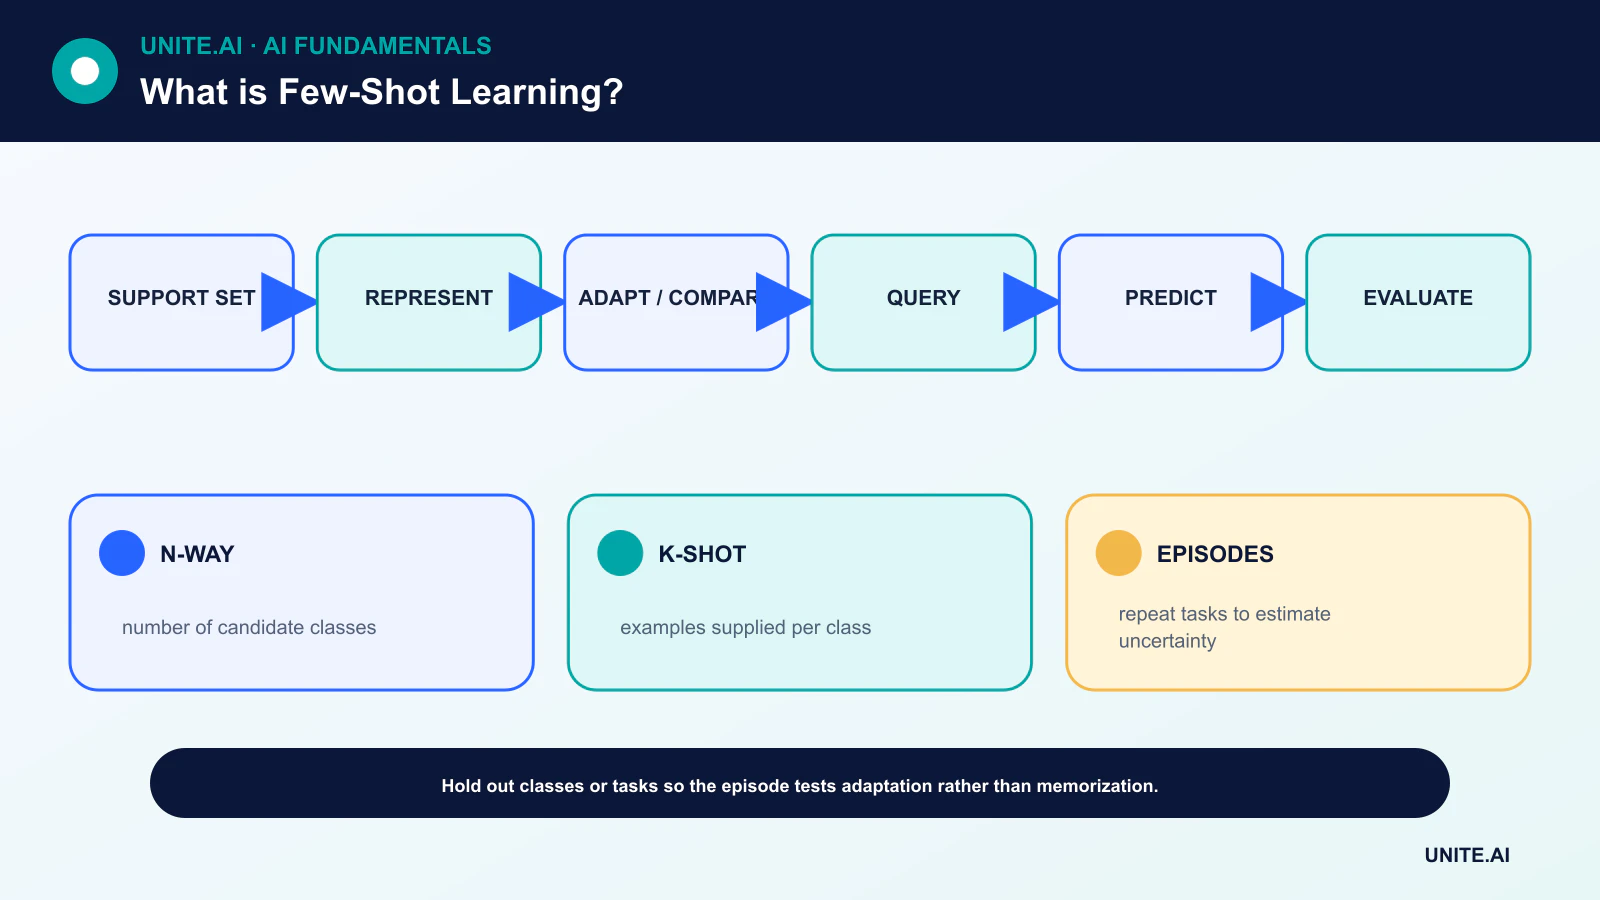
Few-shot learning untersucht, wie ein Modell sich an eine neue Aufgabe oder Klasse anpassen kann, wenn nur eine kleine Anzahl gelabelter Beispiele vorliegt. In klassischen Benchmarks liefert ein Episode ein Support‑Set — zum Beispiel fünf Klassen mit ein oder fünf Beispielen pro Klasse — und fordert das Modell auf, ungesehene Anfragen zu klassifizieren.
Der Begriff wird auch für In‑Context‑Learning verwendet, bei dem ein vortrainiertes Sprachmodell einige Demonstrationen in seinem Prompt erhält, ohne dass Parameter aktualisiert werden. Diese Einstellungen teilen das Ziel, mit wenigen Beispielen zu arbeiten, nutzen jedoch unterschiedliche Adaptationsmechanismen und erfordern verschiedene Evaluationsdesigns.
Wesentliche Erkenntnisse
- N-way K-shot beschreibt N Klassen und K gelabelte Support‑Beispiele pro Klasse.
- Metric‑Learning‑Methoden vergleichen Anfragen mit gelernten Repräsentationen der Support‑Beispiele.
- Meta‑Learning optimiert über viele Aufgaben, sodass eine neue Aufgabe schnell erlernt werden kann.
- Wenige Beispiele verstärken Fehlbeschriftungen, Datenlecks, Klassen‑Mehrdeutigkeiten und Unsicherheit, daher sind Baselines und das Reporting von Konfidenz wichtig.
Episoden, Support‑Sets und Query‑Sets
Eine Few‑Shot‑Episode trennt ein kleines gelabeltes Support‑Set von einem Query‑Set, das zur Evaluation verwendet wird. Während des Meta‑Trainings sieht das Modell viele solcher Episoden. Eine strenge Evaluation lässt ganze Klassen, Aufgaben oder Domänen aus, sodass die Test‑Episode die Anpassungsfähigkeit statt das Auswendiglernen misst.
Berichte Genauigkeitsverteilungen über viele Episoden hinweg statt einer einzigen bequemen Stichprobe. Vergleiche mit einfachen Nearest‑Neighbor‑ und linearen Baselines; eine ausgefeilte Methode, die keine gut trainierte Repräsentation plus einen einfachen Klassifikator übertreffen kann, rechtfertigt ihre Komplexität möglicherweise nicht.
Metrisches Lernen und Prototypen
Matching‑Networks und verwandte Methoden betten Support‑ und Query‑Beispiele in einen Raum ein, in dem nahe Vektoren dieselbe Beschriftung teilen sollten. Prototypical‑Networks mitteln die Support‑Einbettungen für jede Klasse und klassifizieren eine Anfrage anhand der Distanz zu diesen Klassen‑Prototypen.
Dies verbindet Few‑Shot‑Learning mit der Qualität von Repräsentationen. Ein vortrainiertes Deep‑Learning-Modell kann bereits relevante Merkmale gut organisieren, während eine nicht passende Repräsentation jede Distanz irreführend machen kann.
Optimierungsbasiertes Meta‑Learning
Model‑Agnostic Meta‑Learning sucht nach Parametern, die sich mit einer kleinen Anzahl von Gradientenschritten anpassen lassen. Andere Methoden lernen einen Optimierer, eine Initialisierung oder eine Regel zur Parameteraktualisierung. Die äußere Schleife bewertet die Leistung nach der Anpassung über verschiedene Aufgaben.
Meta‑Learning geht davon aus, dass nützliche Strukturen zwischen Trainings‑ und Ziel‑Aufgaben geteilt werden. Wenn die Ziel‑Verteilung stark abweicht, kann die schnelle Anpassung scheitern. Die Validierung sollte die Anzahl der Shots, Klassen, Domänen und Aufgabenschwierigkeit variieren, anstatt einen einzigen Benchmark als universell zu behandeln.
Transfer‑Learning und datenbasierte Strategien
Transfer‑Learning ist oft der stärkste praktische Ausgangspunkt: ein vortrainierter Encoder wird eingefroren, ein kleiner Kopf trainiert und anschließend selektiv feinjustiert, sofern ausreichend Daten vorhanden sind. Datenaugmentation kann Invarianzen einführen, doch unrealistische synthetische Beispiele können Bias verstärken oder Kurzschlüsse erzeugen.
Active Learning kann priorisieren, welche Beispiele zu labeln sind, während semi‑supervised Learning zusätzliche ungelabelte Daten nutzen kann. Diese Strategien ergänzen sich, sind jedoch keine Synonyme für Few‑Shot‑Learning.
Few‑Shot‑Prompting ist anders
Ein Transformer kann ein Muster aus Demonstrationen, die in seinem Kontext platziert werden, ableiten. Es ist kein permanentes Parameter‑Update erforderlich. Reihenfolge, Formulierung und Balance der Labels können das Ergebnis wesentlich verändern, und Beispiele können einen großen Teil des Kontext‑Fensters beanspruchen.
Verwende ein repräsentatives Evaluations‑Set, versioniere jeden Prompt und jede Demonstration und teste Zero‑Shot-, Few‑Shot- und feinjustierte Alternativen. Ein winziges Support‑Set rechtfertigt keine starken, bevölkerungsweiten Behauptungen, insbesondere nicht für seltene oder sicherheitskritische Fälle.
Few‑Shot‑Learning‑Paradigmen und Aufgaben‑Konstruktion
Few‑Shot‑Learning zielt darauf ab, eine Aufgabe mit sehr wenigen gelabelten Beispielen zu bewältigen. In metrikbasierten Methoden mappt ein Encoder Beispiele in einen Raum, in dem nächste Prototypen oder Nachbarn Klassen repräsentieren. Optimierungsbasiertes Meta‑Learning trainiert eine Initialisierung oder Aktualisierungsregel für schnelle Anpassung. Transfer‑Learning fine‑tunt ein vortrainiertes Modell auf einem kleinen Ziel‑Set. In‑Context‑Learning liefert Beispiele in einem Prompt, ohne Gewichte zu aktualisieren. Diese Mechanismen unterscheiden sich, daher sollten Behauptungen angeben, ob Parameter geändert werden, welche Vor‑Trainings‑Daten verwendet wurden und wie Beispiele ausgewählt werden.
Die Evaluation sollte Trainings‑ und Test‑Klassen, Aufgaben, Subjekte oder Domänen gemäß der behaupteten Generalisierung trennen. Eine N‑way K‑shot‑Episode enthält N Klassen und K Support‑Beispiele pro Klasse sowie Query‑Beispiele zur Bewertung. Wiederholte Episoden schätzen die Varianz durch Support‑Auswahl. Beim Prompting können Reihenfolge, Label‑Formulierung, Format und Ähnlichkeit der Demonstrationen das Ergebnis wesentlich beeinflussen. Vergleiche mit Zero‑Shot, Nearest‑Neighbor, Linear‑Probe und herkömmlichen Fine‑Tuning‑Baselines unter Verwendung derselben Repräsentation und Datenbudget.
Datenqualität, Unsicherheit und negativer Transfer
Bei wenigen Beispielen haben falsch gelabelte oder atypische Fälle überproportionalen Einfluss. Definiere Annotationsregeln, inspiziere jedes Support‑Element und erhalte ein Ergebnis „unbekannt“ oder „Enthaltung“. Datenaugmentation und synthetische Beispiele können nur helfen, wenn sie die Aufgabe erhalten und realistische Variation hinzufügen. Ein vortrainiertes Modell kann Kurzschlüsse oder Bias aus seiner Quell‑Domäne übertragen. Teste Out‑of‑Domain‑Fälle, seltene Gruppen und die Empfindlichkeit gegenüber dem Entfernen eines Support‑Beispiels. Berichte Konfidenz‑Intervalle über Aufgaben und Zufallssamen, nicht nur einen günstigen Prompt.
Active Learning kann nach Labels für informative Fälle fragen, während semi‑supervised Methoden unlabeled Daten unter zusätzlichen Annahmen nutzen. Retrieval kann relevante Demonstrationen dynamisch auswählen, muss jedoch Test‑Label‑Leakage vermeiden. Anpassung kann schnell überfitten, daher sollten Updates eingeschränkt, Regularisierung eingesetzt und auf separaten Beispielen validiert werden. Für hochriskante Aufgaben rechtfertigen wenige Labels selten autonome Entscheidungen; das Modell sollte zur Priorisierung oder Unterstützung der Prüfung eingesetzt werden, bis ausreichende Evidenz für das Ergebnis vorliegt.
Produktionsbetrieb
Versioniere das Basismodell, Einbettungen oder Prompt‑Vorlage, Demonstrationen, Label‑Schema und Adaptations‑Parameter. Schütze Beispiele, da Prompts oder Gradienten sensible Datensätze preisgeben können. Überwache die Leistung, während Klassen und Sprache sich ändern, und aktualisiere Support‑Beispiele durch gesteuerte Überprüfung statt automatisches Selbst‑Labeln. Few‑Shot‑Learning reduziert den Bedarf an gelabelten Ziel‑Daten, indem es vorherige Strukturen nutzt; es eliminiert jedoch nicht die Notwendigkeit einer repräsentativen Evaluation, sorgfältiger Aufgaben‑Definition, Domänen‑Expertise oder einer sicheren Rückfallebene, wenn die neue Aufgabe außerhalb dieses Vorwissens liegt.
Praktisches Beispiel: Few‑Shot‑Klassifikation für ein neues Produkt
Ein Support‑Team benötigt Routing‑Labels für ein Produkt, für das nur fünf geprüfte Beispiele pro Problem vorliegen. Es vergleicht nächste Prototypen in einer vortrainierten Einbettung, einen linearen Kopf, parameter‑effizientes Fine‑Tuning und In‑Context‑Prompting. Produktfamilien, Kunden und spätere Nachrichten werden vom Meta‑Training und der Modellauswahl ausgeschlossen. Wiederholtes Sampling des Support‑Sets berichtet Klassen‑Recall, Kalibrierung, Varianz und Empfindlichkeit gegenüber einer falsch gelabelten Demonstration.
Nachrichten mit geringer Konfidenz und ohne Support‑Beispiel werden an den allgemeinen Support weitergeleitet, und Prüfer korrigieren Labels über eine gesteuerte Warteschlange. Beispiele werden anonymisiert, versioniert und niemals aus dem finalen Test‑Set ausgewählt. Das Monitoring verfolgt neuen Wortschatz, Klassenraten, Korrekturen und Meinungsverschiedenheiten. Sobald genügend Labels gesammelt sind, wird das Few‑Shot‑System mit herkömmlichem überwachten Training verglichen. Der schnelle Aufbau ist nützlich, rechtfertigt jedoch keine Automatisierung, wenn die Leistung instabil bleibt oder das neue Produkt erheblich von den vorherigen Aufgabenfamilien abweicht.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definiere die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etabliere eine reproduzierbare Basislinie und ein versioniertes Evaluations‑Set vor dem Tuning. Teste reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungs‑Shift, Ausfall von Abhängigkeiten, Missbrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Miss die Aufgaben‑Qualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentiere jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout weise Verantwortlichkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Nutze ein gestuftes Rollout, bewahre eine sichere Rückfallebene und prüfe das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabe‑Qualität, Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, Gesundheitszustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse aufzeigen, ohne unnötige sensible Daten zu sammeln. Definiere Alarm‑Schwellen und einen Verantwortlichen für Reaktionen, dann prüfe reale Evidenz nach dem Deployment, anstatt anzunehmen, dass Offline‑Leistung bestehen bleibt. Überprüfe erneut, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus Vorfällen, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist One‑Shot‑Learning dasselbe wie Few‑Shot‑Learning?
One‑Shot‑Learning ist der Spezialfall, bei dem pro Klasse oder Aufgabe nur ein gelabeltes Support‑Beispiel vorliegt. Zero‑Shot‑Learning verwendet keinerlei gelabelte Ziel‑Beispiele.
Eliminiert Few‑Shot‑Learning den Bedarf an Daten?
Nein. Es verlagert die Abhängigkeit hin zu Pre‑Training‑Daten, verwandten Aufgaben, Repräsentationen und Annahmen. Die Ziel‑Labels sind wenige; die gesamte Lernhistorie ist in der Regel umfangreich.
Primärreferenzen












