
Grundlagen der KI
Standardlösungen vs. maßgeschneiderte Machine-Learning-Modelle

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
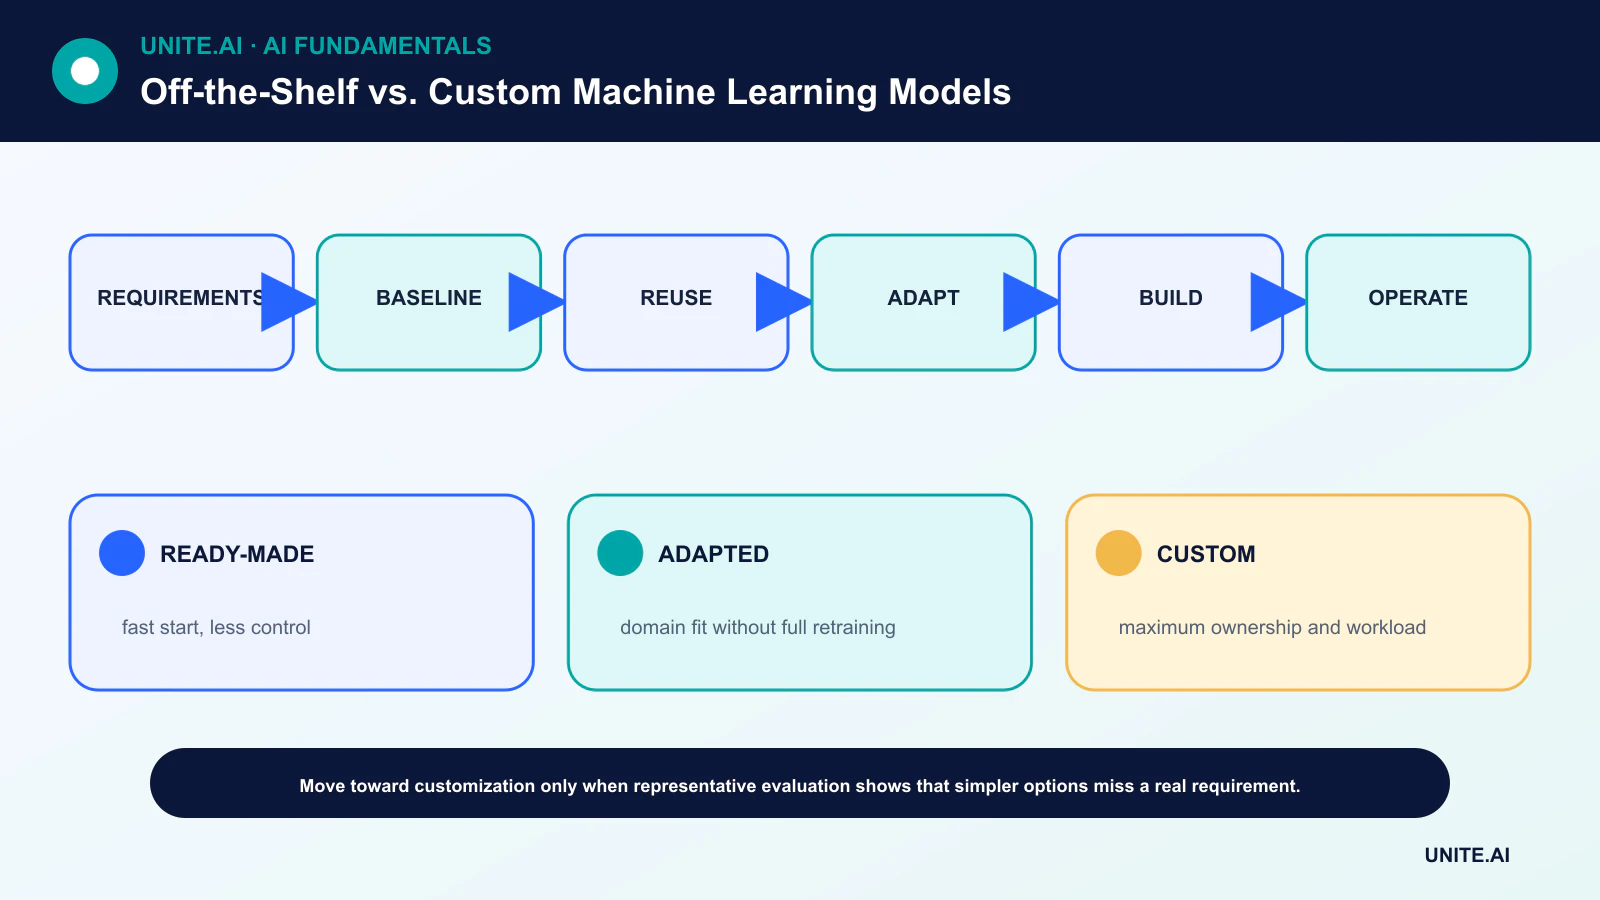
Die Auswahl einer Machine‑Learning‑Lösung ist selten eine einfache Kauf‑gegen‑Selbstbau‑Entscheidung. Der eigentliche Kontinuum reicht von einer gehosteten API oder einem paketierten Modell über Prompting, Retrieval und Feinabstimmung bis hin zu einer vollständig maßgeschneiderten Architektur, die mit organisationsspezifischen Daten trainiert wird.
Die beste Option ist der am wenigsten komplexe Ansatz, der eine verifizierte Produktanforderung erfüllt. Ein maßgeschneidertes Modell kann Kontrolle und Differenzierung ermöglichen, erzeugt jedoch auch eine fortlaufende Verpflichtung, Datenpipelines, Evaluierungen, Monitoring, Sicherheit, Updates und Rollbacks zu betreiben.
Wesentliche Erkenntnisse
- Beginnen Sie mit einer messbaren Aufgabe, einer nicht‑ML‑Baseline und Akzeptanzschwellen.
- Bewerten Sie Kandidatenmodelle anhand repräsentativer privater Daten und nicht nur anhand öffentlicher Benchmark‑Ergebnisse.
- Berücksichtigen Sie Integrations‑, Latenz‑, Prüfungs‑, Retrainings‑ und Incident‑Kosten in den Gesamtkosten des Besitzes.
- Bevorzugen Sie reversible Stufen: Baseline, Retrieval oder Prompt, Feinabstimmung und erst dann ein Training von Grund auf, wenn die Evidenz es unterstützt.
Definieren Sie die Entscheidung, bevor Sie ein Modell auswählen
Geben Sie den Nutzer, die Entscheidung, Eingaben, Ausgaben, Fehlkosten, Latenzbudget, Verkehrsmuster und Eskalationspfad an. Bestimmen Sie, ob eine deterministische Regel oder ein Suchsystem einen ausreichenden Teil des Problems löst. Googles Rules of ML empfiehlt einfache Baselines und vertrauenswürdige Infrastruktur, bevor komplexe Modelle eingesetzt werden.
Erstellen Sie ein Offline‑Evaluierungsset, das die Produktion widerspiegelt, einschließlich seltener und adversarialer Fälle. Wenn Entscheidungen Menschen betreffen, definieren Sie Untergruppen‑Checks und menschliche Prüfungsregeln. Diese Schranken machen Vergleiche konkret, anstatt die Architekturwahl zu einer bloßen Präferenz zu machen.
Der Kontinuum von Wiederverwendung und Anpassung
Eine gehostete API bietet schnelle Integration und verwaltetes Skalieren, jedoch nur begrenzte Kontrolle über Modell‑Interna, Versionen und Datenverarbeitung. Ein offenes vortrainiertes Modell erhöht die Deploy‑Kontrolle. Retrieval oder Prompt‑Engineering können domänenspezifischen Kontext hinzufügen, ohne die Gewichte zu ändern.
Feinabstimmung oder parameter‑effiziente Adapter können das Verhalten spezialisieren. Ein Training von Grund auf ist nur gerechtfertigt, wenn Daten, Zielsetzung, Umfang oder Eigentumsanforderungen nicht durch Wiederverwendung erfüllt werden können. Transfer‑Learning erfasst häufig den Großteil des Werts mit deutlich weniger Daten und Rechenleistung.
Qualität, Kontrolle und Bindung
Messen Sie Aufgabenqualität, Kalibrierung, Latenz, Durchsatz, Verfügbarkeit und Fehlertoleranz. Ein Anbietermodell kann sich automatisch verbessern, aber auch das Verhalten ändern; ein selbstgehostetes Modell kann fixiert werden, erfordert jedoch, dass das Team Upgrades und Schwachstellen verwaltet.
Vertragliche Bedingungen sollten Datenaufbewahrung, Trainingsnutzung, regionale Verarbeitung, geistiges Eigentum, Service‑Levels, Exportpfade und Veraltung abdecken. Die Portabilität verbessert sich, wenn die Anwendung modell‑spezifische Adapter von der Geschäftslogik trennt und reproduzierbare Evaluationsartefakte speichert.
Datenschutz, Sicherheit und Betrieb
Kartieren Sie jeden Datenfluss und jede Bedrohungsgrenze. Sensitive Eingaben können ein privates Netzwerk, On‑Premise‑Inference oder Edge‑AI erfordern. Selbst‑Hosting macht ein System nicht automatisch sicher; es überträgt Sicherheits‑ und Compliance‑Verantwortung auf den Betreiber.
Der Produktionsbetrieb umfasst Beobachtbarkeit, Drift‑Checks, Missbrauchs‑Monitoring, Incident‑Response und Rollback. Das Betriebsteam muss in der Lage sein zu beantworten, welches Modell, welcher Prompt, welche Datenversion und welche Richtlinie ein Ergebnis erzeugt haben.
Nutzen Sie gestufte Evidenz, nicht Ideologie
Führen Sie einen zeitlich begrenzten Benchmark mit demselben Datensatz und denselben Akzeptanzkriterien über alle Optionen hinweg durch. Schätzen Sie den Ingenieuraufwand, Annotation, Beschleuniger‑Nutzung, Anbietergebühren, Prüfungsaufwand, Fehlkosten und die erwartete Änderungsrate.
Wählen Sie den einfachsten Kandidaten, der die Schranken besteht, und evaluieren Sie anschließend erneut, wenn Anforderungen oder Preise sich ändern. Anpassungen sind wertvoll, wenn sie messbaren Nutzen oder notwendige Kontrolle bringen – nicht nur, weil ein maßgeschneidertes Modell strategisch wichtig klingt.
Anforderungen und Gesamtkostenvergleich
Ein Standardmodell, eine API oder ein paketiertes System bietet vorgefertigte Fähigkeiten mit Anbietersupport und schnellerer Erstimplementierung. Ein maßgeschneidertes Modell wird für eine spezifische Aufgabe, Daten und Betriebsumgebung trainiert oder wesentlich angepasst. Die Wahl beginnt mit den Anforderungen: Zielergebnis, Qualität nach Untergruppe und Randfall, Latenz, Durchsatz, Verfügbarkeit, Erklärbarkeit, Datenresidenz, Update‑Kontrolle, Integration, Sicherheit und Fehlkonsequenz. Ein generischer Benchmark oder Demo kann nicht beantworten, ob ein Produkt diese Anforderungen erfüllt.
Die Gesamtkosten umfassen Evaluation, Datenaufbereitung, Kennzeichnung, Integration, Lizenzen oder Nutzung, Infrastruktur, Monitoring, Prüfung, Incident‑Response, Upgrades und Ausstieg. Standardlösungen reduzieren den anfänglichen Aufwand, können jedoch variable Kosten, Bindung, Verhaltensänderungen und begrenzte Beobachtbarkeit erzeugen. Maßgeschneiderte Entwicklung fügt Daten‑ und MLOps‑Verantwortung hinzu und kann weiterhin von vortrainierten Gewichten und Anbietern abhängen. Modellkosten sollten pro erfolgreich erledigter Aufgabe bei erforderlicher Qualität gemessen werden, nicht pro Token oder Trainingslauf allein.
Evaluierung, Beschaffung und Anpassung
Erstellen Sie ein repräsentatives privates Testset vor der Anbieterauswahl und führen Sie jeden Kandidaten unter identischen Prompts, Vorverarbeitung, Schwellenwerten und Betriebsgrenzen aus. Beziehen Sie mehrdeutige, adversariale, nicht unterstützte, mehrsprachige und hochkritische Fälle ein. Messen Sie Genauigkeit, Kalibrierung, Latenz, Kosten, Ablehnungsrate, Sicherheit und Auswirkungen auf den menschlichen Workflow. Testen Sie API‑Ausfälle, Rate‑Limits, regionales Verhalten und Versionswechsel. Anbieter‑Behauptungen erfordern Dokumentation zu Training, Rechten, Datenschutz, Aufbewahrung, Unter‑verarbeitern, Sicherheit, Support und Incident‑Benachrichtigung.
Anpassungsoptionen bilden ein Spektrum: Konfiguration, Retrieval, Prompting, Feinabstimmung, parameter‑effiziente Updates, benutzerdefinierte Heads oder Training von Grund auf. Verwenden Sie die am wenigsten komplexe Methode, die die Evidenz erfüllt. Retrieval ist geeignet für häufig wechselndes Wissen; Feinabstimmung kann Format‑ oder Domänenverhalten formen; deterministischer Code sollte exakte Regeln behandeln. Validieren Sie kombinierte Systeme, da ein starkes Basismodell dennoch durch schlechtes Retrieval, Berechtigungen oder Integration scheitern kann.
Lebenszyklus und Ausstiegsplanung
Gehostete Produkte können sich ändern oder verschwinden, während maßgeschneiderte Modelle ohne Eigentümer zu technischer Schuld werden. Version‑Abhängigkeiten, Verhalten und Ergebnisse überwachen, Retrain‑ oder Reevaluierungs‑Trigger definieren und Rollbacks beibehalten. Daten und Schnittstellen, die für Migration nötig sind, erhalten, Löschung und Export aushandeln und vermeiden, dass das proprietäre Schema eines Anbieters die gesamte Anwendung durchdringt. Die beste Wahl kann hybrid: kommerzielle Fähigkeiten für Standardaufgaben und maßgeschneiderte Komponenten dort, wo Domänen‑Performance, Kontrolle oder Risiko nachhaltigen Wert schaffen.
Praktisches Beispiel: Auswahl eines Dokument‑Extraktionsmodells
Ein Unternehmen erstellt ein privates Testset von Rechnungen verschiedener Lieferanten, Sprachen, Scans, Handschriften und Randfällen und vergleicht anschließend eine verwaltete API, ein offenes vortrainiertes Modell, ein angepasstes Modell und eine Regel‑Baseline. Es bewertet Feld‑Genauigkeit, monetäre Fehler, nicht unterstützte Dokumente, Latenz, Durchsatz, Datenschutz, Datenresidenz, Integration und Kosten pro korrekt verarbeiteter Rechnung. Anbieter‑Demos und öffentliche Benchmarks ersetzen diese abgestimmte Evaluation nicht.
Das ausgewählte Hybrid nutzt einen kommerziellen OCR‑Dienst mit lokaler Validierung und menschlicher Prüfung bei geringer Sicherheit oder hohen Beträgen. Verträge definieren Aufbewahrung, Unter‑verarbeiter, Updates und Löschung; die Architektur bewahrt Ausgangsdateien und einen Ausstiegspfad. Ein Schatten‑Zeitraum erkennt Schema‑ und Lieferantenlücken. Monitoring trennt OCR, Extraktion, Validierung und Korrekturen durch Prüfer. Ändert sich das Verhalten des Anbieters, kann das Team einfrieren, wechseln oder mehr Arbeit zu seiner eigenen Komponente verlagern, ohne den Finanz‑Workflow neu zu schreiben.
Implementierungsnachweis und betriebliche Bereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Baseline und ein versioniertes Evaluationsset vor der Feinabstimmung. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem ansprechenden Prototyp unterscheiden kann.
Vor dem Start sollten Sie die Zuständigkeit für Release, Ausnahmen, Änderungen, Rollback und Stilllegung festlegen. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie dann Evidenz aus der Praxis nach dem Rollout, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Incident‑Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Zeitpunkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Wann sollte ein Team ein Modell von Grund auf trainieren?
Wenn vortrainierte oder gehostete Optionen die validierten Anforderungen nicht erfüllen und das Team über ausreichende proprietäre Daten, Rechenleistung, Expertise und langfristige Betriebsfähigkeit verfügt.
Ist ein Standardmodell wartungsfrei?
Nein. Integration, Evaluation, Versionsänderungen, Monitoring, Datenschutz‑Kontrollen und das Fallback‑Verhalten bleiben Verantwortung des Anwenders.
Primärreferenzen











