
Grundlagen der KI
Was ist Asset Performance Management (APM)?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Asset Performance Management (APM) kombiniert Asset-Strategie, Instandhaltung, Zustandsüberwachung, Zuverlässigkeitsanalyse und operative Daten, um den von physischen Anlagen gelieferten Wert zu steigern. Es wird typischerweise für Geräte wie Turbinen, Pumpen, Fahrzeuge, Produktionslinien und Infrastruktur eingesetzt.
APM ist kein reines Sensor-Dashboard oder ein eigenständiges Predictive-Maintenance‑Modell. Es ist ein Entscheidungsprozess, der Leistung, Kosten, Risiko, Sicherheit und Nachhaltigkeit über den gesamten Anlagenlebenszyklus ausbalanciert und klare Verantwortlichkeiten für Inspektionen, Arbeiten, Ersatzteile und Investitionsplanung definiert.
Wesentliche Erkenntnisse
- Beginnen Sie mit Kritikalität und den Folgen von Ausfällen, nicht mit dem am leichtesten zu erfassenden Sensor.
- Kombinieren Sie Zustandsdaten mit Instandhaltungshistorie, Betriebskontext und technischem Fachwissen.
- Verwenden Sie prädiktive Signale, um eine definierte Arbeitsentscheidung und Vorlaufzeit‑Anforderung zu unterstützen.
- Messen Sie vermiedene Risiken, Verfügbarkeit, Instandhaltungsqualität, Lebenszykluskosten und Fehlalarme.
Von der Asset-Strategie zur Arbeit
Organisationen definieren Ziele, Asset-Hierarchien, Kritikalität, Leistungsstandards, Ausfallmodi und Instandhaltungsstrategien. Ein Arbeitsmanagement‑System plant Inspektionen und Reparaturen; APM‑Analysen helfen, zu priorisieren, wann und warum Arbeiten durchgeführt werden sollten.
Der gleiche Zustand kann für eine redundante, kostengünstige Pumpe und eine sicherheitskritische Turbine unterschiedliche Maßnahmen bedeuten. APM verknüpft technische Evidenz mit geschäftlichem und sicherheitsrelevantem Kontext, anstatt nur einen Vorhersagewert zu optimieren.
Daten und digitale Repräsentationen
Nützliche Quellen umfassen Sensor‑Zeitreihen, Alarme, Rundgänge von Bedienern, Instandhaltungsnotizen, Bauteile, Umgebungsbedingungen, Lasten und Designgrenzen. Asset‑Kennungen und Zeitstempel müssen vor der Analyse abgestimmt werden. Fehlende, driftende oder ausgetauschte Sensoren können falsche Trends erzeugen.
Ein digitaler Zwilling kann Ingenieurmodelle und den Live‑Zustand kombinieren, benötigt jedoch validierte Annahmen und Aktualisierungsregeln. Unstrukturierte Techniker‑Notizen können Kontext hinzufügen, den die Telemetrie nicht liefert.
Zustand, Vorhersage und Entscheidung
Schwellenwerte erkennen bekannte Grenzen; Anomalie‑Modelle kennzeichnen Abweichungen; Diagnose‑Modelle schätzen Ursachen; Prognose‑Modelle schätzen die verbleibende Nutzungsdauer. Jeder Ansatz erfordert einen Zeithorizont und eine Unsicherheit, die zur jeweiligen Instandhaltungsentscheidung passen.
Ein Modell, das einen Ausfall fünf Minuten im Voraus vorhersagt, kann zwar genau sein, ist jedoch betriebsunbrauchbar, wenn Ersatzteile eine Woche benötigen. Maschinelles Lernen sollte mit Regel‑ und Zuverlässigkeitsmethoden verglichen und über verschiedene Betriebsregime hinweg getestet werden.
Implementierung und Messung
Beginnen Sie mit einer kritischen Anlagenklasse, einem plausiblen Ausfallmodus, verfügbarem Vorlauf und einem Verantwortlichen, der handeln kann. Integrieren Sie Empfehlungen in Planung, Arbeitsaufträge und Bestände; erfassen Sie das Ergebnis, damit die Regel oder das Modell überprüft werden kann.
Verfolgen Sie Verfügbarkeit, ungeplante Ausfallzeiten, Instandhaltungskosten, Termin‑Einhalten, Fehlalarme, verpasste Ereignisse, Sicherheitsbelastungen und den Lebenszykluswert. Vermeiden Sie die Behauptung vermiedener Ausfälle ohne kontrafaktische Methode und dokumentierte Annahmen.
Asset-Hierarchie, Ausfallverhalten und Kritikalität
Ein APM‑Programm beginnt mit einer Asset‑Hierarchie, die Standorte, Systeme, Geräte, Baugruppen und wartbare Komponenten verbindet. Jede Ebene benötigt konsistente Kennungen, Eigentumsverhältnisse, Standort, Spezifikationen und Beziehungen. Ohne diese Grundlage können Sensorströme, Arbeitsaufträge, Inspektionsbefunde und Kostendaten das gleiche physische Asset nicht zuverlässig beschreiben.
Ausfallmodi erklären, wie ein Asset seine geforderte Funktion nicht mehr erfüllen kann, warum der Ausfall auftritt, welche Evidenz zuerst erscheint und welche Konsequenz folgt. Failure‑Mode‑and‑Effects‑Analysis, reliability‑centered Maintenance und Root‑Cause‑Analysis verwandeln die Instandhaltung von einer rein kalenderbasierten Tätigkeit in eine risikobewusste Disziplin. Die Analyse sollte Symptome von Kausalmechanismen unterscheiden.
Kritikalität kombiniert Wahrscheinlichkeit mit Konsequenzen für Sicherheit, Umwelt, Produktion, Qualität, Compliance und Kosten. Eine redundante Pumpe, die einen nicht wesentlichen Kreislauf bedient, sollte nicht das gleiche Überwachungsbudget erhalten wie ein Kompressor, der ein Single‑Point‑of‑Failure darstellt. Kritikalität ändert sich mit dem Betriebskontext, daher sollten Teams die Bewertungen nach Änderungen von Prozessen, Assets oder Nachfrage neu prüfen.
Zustandsüberwachung, Vorhersage und Instandhaltungsentscheidungen
Zustandsüberwachung kann Vibration, Temperatur, Druck, Strom, akustische Emission, Schmierstoffanalyse, Sichtinspektion und Beobachtungen des Bedieners nutzen. Die Abtastrate muss zur Physik des Ausfalls passen. Hochfrequente Lager‑Vibrationen und langsam driftende Korrosion erfordern unterschiedliche Sensoren, Speicherung, Merkmale und Alarmlogik. Kalibrierungs‑ und Installationsqualität sind Teil der Datenqualität.
Predictive Modelle können Anomalien erkennen, bekannte Fehler klassifizieren, Gesundheitsindikatoren schätzen oder die verbleibende Nutzungsdauer prognostizieren. Ein statistisch ungewöhnliches Signal ist nicht automatisch ein umsetzbarer Ausfall. Modelle benötigen Kontext des Betriebszustands, Unsicherheit, Vorlaufzeit‑Bewertung und Validierung über Geräte, Jahreszeiten, Lasten und Instandhaltungsereignisse hinweg. Fehlalarme kosten Vertrauen und Arbeitskraft; verpasste Erkennungen können zu schweren Verlusten führen.
Die Ausgabe der Analytik muss mit einer Entscheidung verknüpft werden: inspizieren, schmieren, die Belastung reduzieren, Arbeiten planen, ein Bauteil bestellen oder abschalten. Entscheidungsschwellen sollten die Ausfallfolgen, den Eingriffsvorlauf, die Kapazität der Belegschaft, Ersatzteile und Produktionsfenster berücksichtigen. Die wirtschaftlich optimale Schwelle ist selten die Schwelle, die eine generische Modellmetrik maximiert.
APM-Integration, Wertmessung und Governance
APM verknüpft operative Technologie mit Unternehmenssystemen wie Computerized Maintenance Management, Enterprise Asset Management, Historian‑Systemen, Bestands‑ und Planungs‑Tools. Die Integration sollte Zeitstempel, Einheiten, Asset‑Identität, Arbeitsstatus und Herkunft bewahren. Netzwerksegmentierung und kontrollierte Gateways sind essenziell, da diagnostische Bequemlichkeit keinen Pfad in sicherheitskritische Steuerungssysteme eröffnen darf.
Messen Sie den Wert durch vermiedene Ausfallzeiten, reduzierte Notfallarbeiten, Instandhaltungskosten, Verfügbarkeit von Ersatzteilen, Energieeffizienz, Ertrag, Sicherheitsbelastungen und Asset‑Lebensdauer. Vermeidete Ausfälle sind kontrafaktisch, daher sollten glaubwürdige Baselines, vergleichbare Assets, dokumentierte Annahmen und Sensitivitätsbereiche verwendet werden. Ein Pilot, der viele Anomalien entdeckt, aber keine Instandhaltungsentscheidungen ändert, hat keinen geschäftlichen Mehrwert gezeigt.
Governance weist Eigentümer für Sensoren, Modelle, Alarmregeln, Fehlbibliotheken und Arbeitsprozesse zu. Überprüfen Sie Alarme nach jeder Intervention, dokumentieren Sie, ob die Diagnose korrekt war, und speisen Sie bestätigte Ergebnisse in Regeln und Modelle ein. Bediener und Instandhalter benötigen eine Möglichkeit, Empfehlungen zu hinterfragen; lokales Wissen ist Evidenz, nicht Widerstand gegen Automatisierung.
Praktisches Beispiel: Schutz eines kritischen rotierenden Assets
Für einen Produktionskompressor kartiert das Team Komponenten und Ausfallmodi, bewertet Produktionsverluste und Sicherheitsfolgen und verknüpft Historian‑Tags, Vibrationssensoren, Schmierstoffproben, Inspektionen und Arbeitsaufträge mit einer einzigen Asset‑Identität. Basisdaten müssen Anlauf, Gleichlast, Teilbelastung und saisonale Bedingungen abdecken. Andernfalls könnte das Modell normale Betriebsübergänge als Fehler kennzeichnen oder eine nur bei einer bestimmten Last sichtbare Degradation übersehen.
Eine Analytik‑Schicht erkennt Änderungen im Vibrationsspektrum und der Lagertemperatur, schätzt die Unsicherheit und stellt die Evidenz neben vergleichbare historische Ereignisse dar. Ein anhaltender Alarm erzeugt eine Inspektionsanforderung statt automatisch abzuschalten. Der Instandhalter dokumentiert Befunde, Maßnahmen, ausgetauschte Teile und die bestätigte Ursache. Diese Ergebnisse bestimmen, ob Schwelle, Fehlermodell oder Sensorinstallation angepasst werden müssen.
Bewerten Sie Vorlaufzeit der Warnungen, bestätigte Erkennungsrate, Fehlalarmbelastung, vermiedene Ausfallzeiten, Notfallarbeiten, Ersatzteilbereitschaft und Instandhaltungskosten im Vergleich zu einer dokumentierten Basislinie. Berücksichtigen Sie die Kosten für Sensoren, Integration, Analyse und geänderte Arbeitsprozesse. Eine Cyber‑Security‑Prüfung isoliert die Überwachung von der Steuerung, und Governance weist Eigentümer für Daten und Modelle zu. Ziel ist eine sicherere, ökonomische Instandhaltungsentscheidung, nicht die größtmögliche Sammlung von Asset‑Telemetrie.
Praktische Implementierungs‑Checkliste
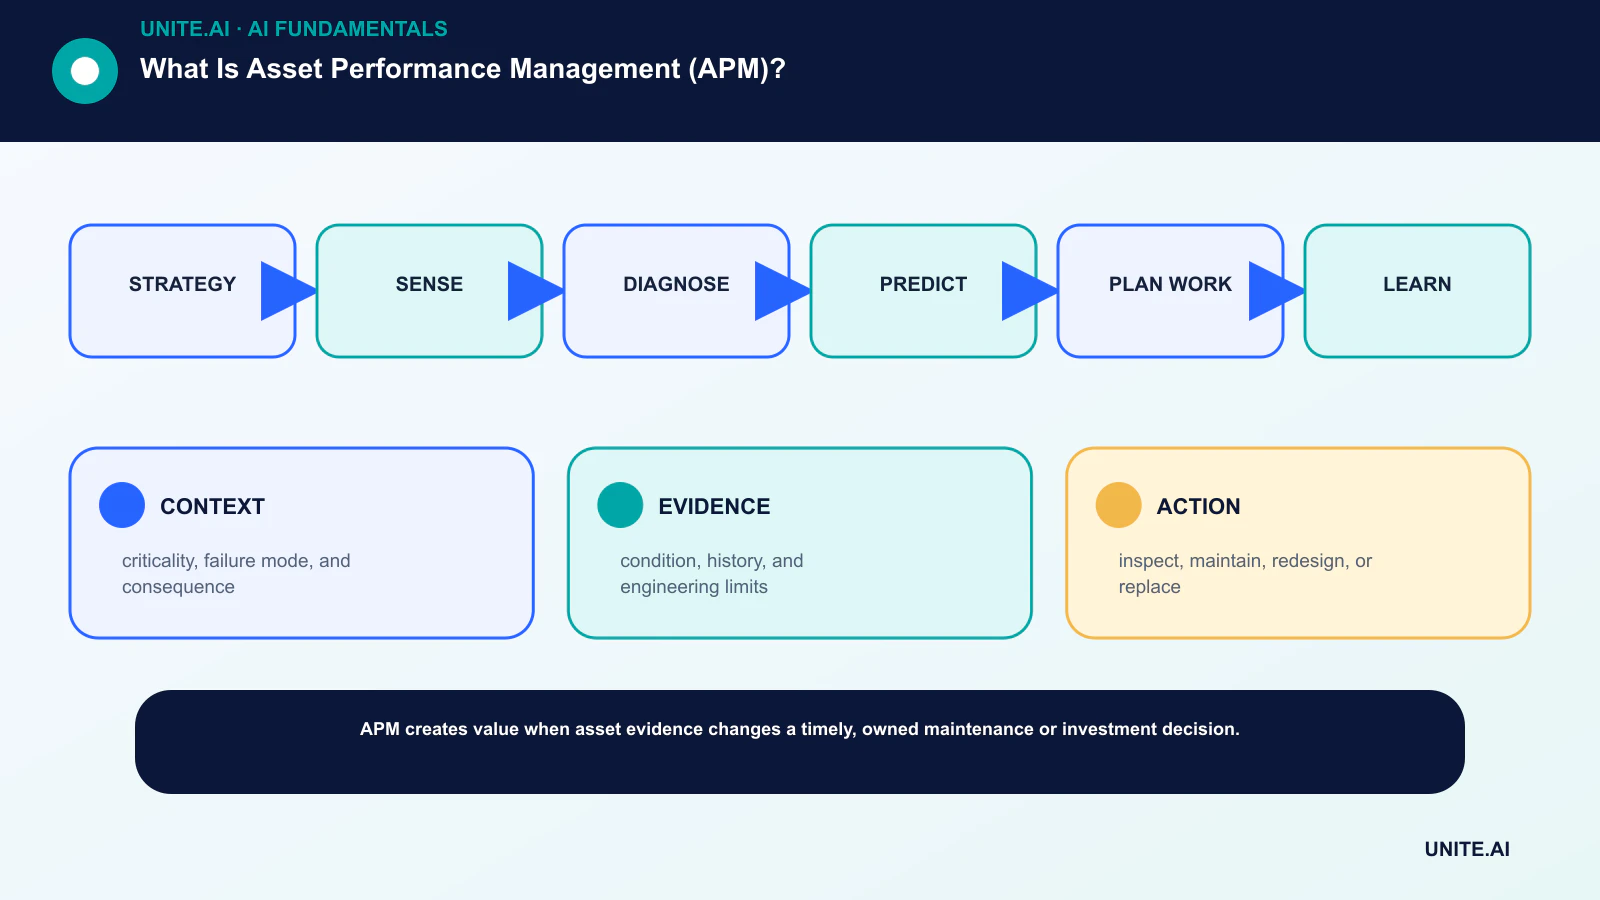
Verwandeln Sie das Konzept in einen abgegrenzten, testbaren Workflow: Strategie → Erfassung → Diagnose → Vorhersage → Arbeitsplanung → Lernen. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, definieren Sie Akzeptanz‑ und Abbruchkriterien, testen Sie repräsentative Ausfälle und legen Sie Überwachung, Rollback und Review fest, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Bereitschafts‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Ausfall von Abhängigkeiten und Fehlgebrauch; bewahren Sie die Evidenz und ungelöste Risiken. Definieren Sie, wer die Freigabe, Schwellenwertänderungen, Overrides von Ausgaben oder das Stoppen des Betriebs genehmigen darf. Überprüfen Sie die Entscheidung erneut, sobald reale Daten vorliegen, da ein technisch erfolgreicher Pilot nicht automatisch zuverlässige Leistung im größeren Maßstab garantiert.
- KONTEXT: Kritikalität, Ausfallmodus und Konsequenz.
- EVIDENZ: Zustand, Historie und technische Grenzen.
- AKTION: inspizieren, warten, neu gestalten oder ersetzen.
Häufig gestellte Fragen
Wie unterscheidet sich APM von einem CMMS?
Ein CMMS verwaltet hauptsächlich Instandhaltungsarbeiten, Zeitpläne und Aufzeichnungen. APM ergänzt Asset‑Strategie, Zuverlässigkeits‑ und Zustandsanalyse, Priorisierung und Leistungsentscheidungen; die Systeme werden häufig integriert.
Ist prädiktive Instandhaltung für APM erforderlich?
Nein. Präventive, zustandsbasierte, Run‑to‑Failure‑, Neugestaltungs‑ und Ersatzstrategien können alle passend sein. Vorhersage ist ein Werkzeug innerhalb einer Asset‑Strategie.
Primäre Referenzen












