
Grundlagen der KI
Was ist konversationelle Spracherkennung (CSR)?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Konversationelle Spracherkennung (CSR) erweitert die automatische Spracherkennung über die isolierte Transkription hinaus, indem sie Dialogkontext, Turn‑Taking‑Signale, Sprecherinformationen und eine niedrige Latenz nutzt. Ziel ist es, eine Live‑Interaktion zu unterstützen, bei der Wörter, Timing, Unterbrechungen und vorherige Turns alle von Bedeutung sind.
CSR ist ein aufstrebendes Produkt‑ und Forschungsetikett, kein einzelner standardisierter Modelltyp. Ein starkes System kombiniert Streaming‑ASR mit Endpointing, Sprecher‑Handling, kontextuellem Sprachmodell, Dialogzustand und einer Antwort‑Policy und bewertet anschließend die Erfahrung von Anfang bis Ende.
Wesentliche Erkenntnisse
- Streaming‑Erkennung gibt vorläufige Hypothesen aus und überarbeitet sie, sobald mehr Audio eintrifft.
- Endpointing und Turn‑Vorhersage sind von der Transkriptionsgenauigkeit getrennt.
- Konversationsverlauf und Hotwords können die Erkennung verbessern, aber auch frühere Fehler weitergeben.
- Bewerten Sie Latenz, Unterbrechungen, Sprecher, Akzente, Hintergrundgeräusche, Datenschutz und Aufgabenerfüllung – nicht nur die Wortfehlerrate.
Von ASR zu Live‑Dialog
Traditionelles ASR wandelt Audio in Text um. Ein konversationelles System muss entscheiden, wann es zuhört, wann ein Turn abgeschlossen ist, ob die Sprache an das System gerichtet ist und wie es sich erholt, wenn das Transkript oder die Antwort falsch ist.
Streaming‑Modelle verarbeiten Frames inkrementell und erzeugen Teil‑Transkripte. Niedrige Latenz verbessert die Reaktionsfähigkeit, doch ein zu früher Abschluss kann Revisionen oder Fehler erhöhen. Die Anwendung benötigt eine Richtlinie, wann Text als stabil bzw. vorläufig gilt.
Turn‑Taking, Überlappungen und Sprecher
Die Dauer der Stille allein ist ein schwaches Endpoint‑Signal. Lexikalische Vollendung, Prosodie, Timing, Blickkontakt und Dialogzustand können helfen vorherzusagen, ob eine Person das Wort hält oder abgibt. Barge‑In ermöglicht es einem Nutzer, synthetische Sprache zu unterbrechen, ohne den Kontext zu verlieren.
Überlappende Stimmen und Diarisierung bleiben schwierig. Systeme sollten Sprecherunsicherheit erhalten, vermeiden, eine Aussage der falschen Person zuzuordnen, und einen Korrekturpfad bieten – besonders bei Aufzeichnungen im Gesundheitswesen, Finanz‑ oder Rechtsbereich.
Kontextuelle Erkennung
Frühere Turns können Namen und Referenzen disambiguieren; Hotword‑Listen können die Erkennung zu Domänenbegriffen hin biasen. Sprach‑ und Sprachmodelle können Audio‑ und Text‑Kontext in einem gemeinsamen Prompt‑ oder Attention‑Framework kodieren.
Kontext kann auch ein falsches früheres Transkript verstärken oder Informationen zwischen Sitzungen lecken. Beschränken Sie den Verlauf auf den aktuellen Zweck, trennen Sie vertrauenswürdige Metadaten vom Nutzersprechen und verwenden Sie transformer‑Kontext mit expliziten Aufbewahrungs‑ und Zugriffsregeln.
Bewertung und verantwortungsvolle Bereitstellung
Berichten Sie Streaming‑Wortfehlerrate, First‑Token‑ und Finalisierungs‑Latenz, Revisionsrate, Endpoint‑Fehler, Barge‑In‑Erfolg, Sprecherzuordnung und Aufgabenerfüllung. Testen Sie mit realen Mikrofonen, Rauschen, Akzenten, Code‑Switching, Behinderungen und emotional belasteter Sprache.
Stimmdaten können sensible Informationen identifizieren oder preisgeben. Anwenden von Einwilligung, Datenminimierung, Verschlüsselung, Aufbewahrungsgrenzen und menschlicher Prüfung. Verknüpfen Sie generierte Antworten mit Chatbot‑Sicherheitskontrollen, denn ein genaues Transkript macht eine Antwort nicht automatisch korrekt oder autorisiert.
Von akustischem Input zum konversationellen Zustand
Ein konversationelles Sprachsystem erfasst Audio, wendet Signal‑Conditioning an, erkennt Sprache, transkribiert Wörter oder semantische Einheiten, identifiziert bei Bedarf Sprecher und aktualisiert den Dialogzustand. Streaming‑Systeme erzeugen Teil‑Hypothesen, bevor ein Utterance endet. Diese Hypothesen können sich ändern, sodass nachgelagerte Komponenten zwischen vorläufigen und finalen Ergebnissen unterscheiden müssen.
Voice‑Activity‑Detection und Endpointing entscheiden, wann Sprache beginnt und wann der Nutzer fertig ist. Feste Stille‑Schwellenwerte versagen bei langsamen Sprechern, Hintergrundgeräuschen und Denkpausen. Turn‑Taking‑Modelle können Wörter, Prosodie, Blickkontakt und Dialogkontext nutzen, müssen jedoch das schnelle Antworten gegen das Unterbrechen des Sprechers abwägen.
Diariesierung beantwortet, wer wann gesprochen hat; Sprechererkennung schätzt die Identität; Source‑Separation isoliert überlappende Stimmen. Dies sind unterschiedliche Aufgaben mit unterschiedlichen Risiken. In Meetings, im Gesundheitswesen und im Kundenservice kann die Zuordnung der richtigen Worte zur richtigen Person genauso wichtig sein wie die Wortfehlerrate des Transkripts.
Kontext, Überlappung, Emotion und Interaktionswiederherstellung
Konversationeller Kontext löst Pronomen, Ellipsen, Korrekturen, Domänenbegriffe und Referenzen zu früheren Turns auf. Ein System kann akustische Evidenz mit Dialoghistorie und abgerufenen Kenntnissen kombinieren, doch vorheriger Kontext kann die Erkennung auch zu einer falschen Erwartung biasen. Bewahren Sie Audio‑Evidenz und Konfidenz, damit Kontext Unsicherheit nicht stillschweigend überschreibt.
Natürlicher Dialog beinhaltet Backchannels, Unterbrechungen, Fehlstarts, Lachen, Code‑Switching und simultanes Sprechen. Ein reaktionsschneller Agent muss Barge‑In‑Handling unterstützen: Ausgabe stoppen oder absenken, neue Sprache des Nutzers erfassen, entscheiden, ob die Unterbrechung die Intention ändert, und wiederherstellen, ohne Aktionen zu duplizieren oder zu verlieren.
Prosodie und paralinguistische Signale können Betonung oder Unsicherheit anzeigen, doch das Ableiten von Emotion, Gesundheit oder Intention aus Stimme ist fehleranfällig und kulturell abhängig. Nutzen Sie solche Schätzungen sparsam, geben Sie sie dort an, wo es passend ist, und treffen Sie keine folgenreichen Entscheidungen basierend auf einem nicht validierten Emotions‑Label.
Bewertung, Datenschutz und Produktionsdesign
Wortfehlerrate bleibt nützlich, aber konversationelle Bewertung sollte zusätzlich Sprecherzuordnung, Entity‑Genauigkeit, semantischen Aufgabenerfolg, Stabilität von Teil‑Hypothesen, Endpoint‑Latenz, Unterbrechungserfolg, Wiederherstellung und Nutzer‑Korrekturrate messen. Segmentieren Sie nach Akzent, Sprache, Gerät, Rauschen, Überlappung, Sprechstil und Netzwerkbedingungen.
Streaming‑Architektur benötigt begrenzte Puffer, Back‑Pressure, Wiederverbindung, Sequenznummern und explizite Finalisierung. Halten Sie Modell‑ und Dialog‑Latenz‑Budgets getrennt, protokollieren Sie jede Stufe und testen Sie degradierte Netzwerke. Wenn ein System Aktionen auslöst, bestätigen Sie hoch‑impact‑Intentionen und machen Sie Wiederholungen idempotent, sodass wiederholtes Audio oder erneute Verbindungen Transaktionen nicht duplizieren.
Sprache enthält Identität, Inhalt, Umgebung und Mitläufer‑Informationen. Minimieren Sie Aufbewahrung, verschlüsseln Sie Transport und Speicherung, steuern Sie den Zugriff, definieren Sie Löschungen und unterscheiden Sie Audio von abgeleiteten Transkripten und Embeddings. Stellen Sie sichtbare Aufnahme‑Indikatoren bereit und Alternativen, wenn keine Einwilligung vorliegt. Ein lokales Modell kann Transfer reduzieren, erfordert aber dennoch Erlaubnis und Lebenszyklus‑Kontrollen.
Praktisches Beispiel: ein Sprachassistent, der Unterbrechungen und Korrekturen handhabt
Ein Anrufer sagt: „Buchen Sie Dienstag – nein, Mittwoch Nachmittag“, während der Agent nach „Dienstag“ zu antworten beginnt. Streaming‑Erkennung gibt sich ändernde Teil‑Transkripte aus, Endpointing erkennt fortgesetzte Sprache und Barge‑In stoppt die Ausgabe. Der Dialogzustand markiert das frühere Datum als überschrieben, anstatt zwei Anfragen zu erzeugen. Die Entity‑Bestätigung fokussiert sich auf das korrigierte Datum und die Zeit, während das System Konfidenz und Evidenz für die finale Interpretation behält.
Die Architektur trennt Audio‑Capture, Spracherkennung, Streaming‑Erkennung, Sprecher‑Handling, Dialog‑Policy, Tool‑Ausführung und Synthese. Sequenznummern und Finalisierung verhindern, dass späte Teil‑Ergebnisse das finale Transkript überschreiben. Das Buchungs‑Tool akzeptiert eine strukturierte Anfrage, prüft Autorisierung und Verfügbarkeit und nutzt einen Idempotenz‑Schlüssel. Eine bestätigte Buchung wird vorgelesen und bestätigt, bevor sie ausgeführt wird; ein erneuter Verbindungsaufbau kann sie nicht stillschweigend wiederholen.
Tests kombinieren Wort‑ und Entity‑Genauigkeit mit Endpoint‑Latenz, Unterbrechungserfolg, Korrekturlogik, Sprecherzuordnung, Aufgabenerfüllung und Duplikat‑Aktions‑Rate. Szenarien decken Rauschen, Überlappung, Akzente, Code‑Switching, langsame Sprache, Hilfstechnologien, schwache Netze und synthetische Angriffe ab. Audio‑Aufbewahrung wird minimiert und offengelegt, Mitläufer‑Daten werden explizit behandelt, und Nutzer können zu Text oder einem Menschen wechseln. Konversationelle Intelligenz wird durch sichere Wiederherstellung und Ergebnis gemessen, nicht allein durch Transkript‑Genauigkeit.
Praktische Implementierungs-Checkliste
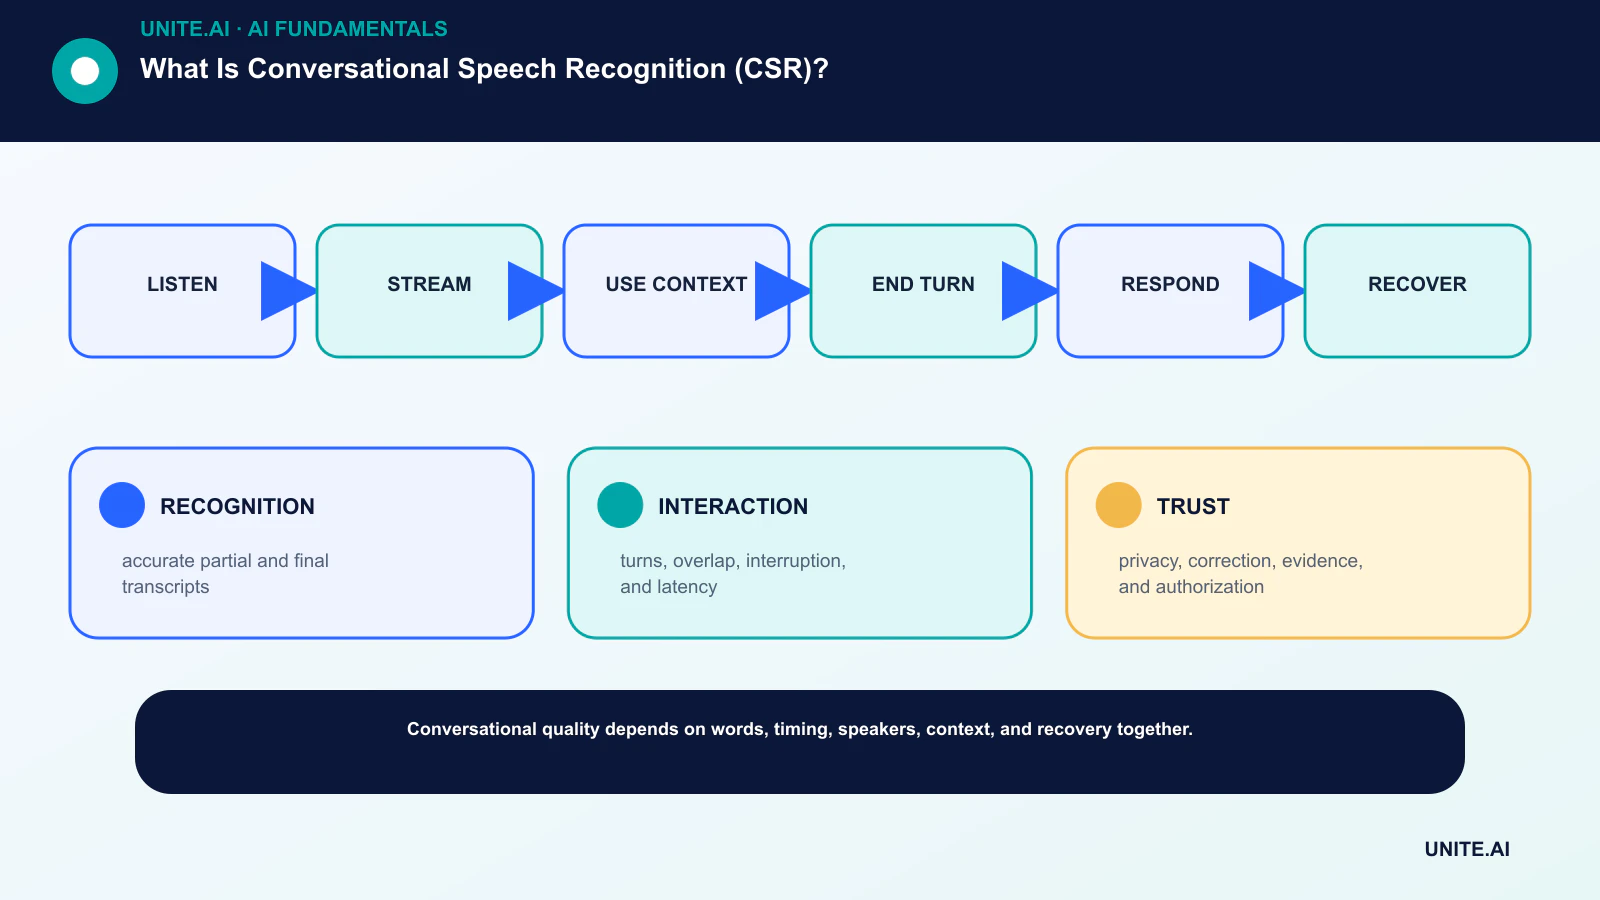
Verwandeln Sie das Konzept in einen begrenzten, testbaren Workflow: zuhören → streamen → Kontext nutzen → Turn beenden → antworten → wiederherstellen. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie Daten und Abhängigkeiten, etablieren Sie ein einfaches Baseline, setzen Sie Akzeptanz‑ und Stopp‑Kriterien, testen Sie repräsentative Fehlerszenarien und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, sodass ein anderes Team das Ergebnis reproduzieren und Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Bereitschafts‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Ausfall von Abhängigkeiten und Missbrauch; bewahren Sie Evidenz und ungelöste Risiken. Definieren Sie, wer die Veröffentlichung freigeben, Schwellenwerte ändern, Ausgaben überschreiben oder den Betrieb stoppen darf. Überarbeiten Sie die Entscheidung, wenn reale Daten eintreffen, denn ein technisch erfolgreicher Pilot garantiert keine zuverlässige Leistung im größeren Maßstab.
- ERKENNUNG: genaue Teil‑ und End‑Transkripte.
- INTERAKTION: Turns, Überlappungen, Unterbrechungen und Latenz.
- VERTRAUEN: Datenschutz, Korrektur, Evidenz und Autorisierung.
Häufig gestellte Fragen
Unterscheidet sich CSR von ASR?
ASR ist die Sprach‑zu‑Text‑Komponente. CSR nutzt ASR plus Dialogkontext, Timing, Sprecher‑ und Endpoint‑Handling sowie Interaktions‑Policies für Live‑Gespräche.
Garantiert eine niedrigere Wortfehlerrate einen besseren Sprachassistenten?
Nein. Ein System kann zwar genau transkribieren, aber Nutzer unterbrechen, langsam reagieren, Sprecher falsch zuordnen oder die falsche Aktion ausführen. End‑to‑End‑Interaktionsmetriken sind erforderlich.
Primärreferenzen












