
Grundlagen der KI
Was ist mechanistische Interpretierbarkeit? Wie Forscher KI-Modelle analysieren

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Mechanistische Interpretierbarkeit untersucht, wie gelernte Komponenten innerhalb eines neuronalen Netzwerks kausal Verhalten erzeugen. Anstatt nur Eingaben mit Ausgaben zu korrelieren, formulieren Forschende Hypothesen über Features, Attention‑Köpfe, Neuronen und Schaltkreise und intervenieren, um diese Hypothesen zu testen.
Das Feld hat detaillierte Erklärungen für ausgewählte Verhaltensweisen in kleinen und mittleren Modellen geliefert, aber eine vollständige, treue Darstellung eines Frontier‑Modells bleibt unerreichbar. Automatisierte Erklärungen und ansprechende Visualisierungen können nützliche Ausgangspunkte sein, jedoch keinen Beweis darstellen.
Wesentliche Erkenntnisse
- Features sind repräsentierte Muster; Schaltkreise sind interagierende Komponenten, die eine Berechnung implementieren sollen.
- Aktivierungs‑Patchen, Ablation und kausales Tracing testen, ob eine Komponente ein Verhalten verändert.
- Superposition bedeutet, dass ein Neuron an vielen Features teilnehmen kann; spärliche Autoencoder versuchen eine andere Feature‑Basis.
- Interpretierbarkeits‑Methoden benötigen Ground‑Truth, falsifizierbare Tests, Abdeckung und Evaluation gegenüber alternativen Erklärungen.
Von der Repräsentation zum Mechanismus
Probing fragt, ob Informationen aus einer Aktivierung dekodiert werden können. Attribution schätzt, welche Eingaben oder Komponenten wichtig sind. Mechanistische Arbeit geht weiter, indem sie eine interne Berechnung vorschlägt und prüft, ob Interventionen das erwartete Zwischen‑ und Endverhalten ändern.
Damit ist es verwandt mit, aber enger gefasst als explainable AI. Eine nachträgliche Erklärung für eine Entscheidung ist nicht notwendigerweise ein rückentwickelter Algorithmus im Modell.
Schaltkreise und kausale Interventionen
Forscher können einen mit einer Aufgabe verbundenen Attention‑Kopf oder ein Feature identifizieren, ihn ablieren, Aktivierungen aus einem anderen Durchlauf patchen oder nachverfolgen, wie Informationen über Schichten hinweg fließen. Eine gute Hypothese sagt das Verhalten bei neuen Beispielen voraus und hält Kontrollen stand.
Interventionen können Zustände außerhalb der Verteilung erzeugen, sodass eine Verhaltensänderung nicht automatisch die natürliche Berechnung offenbart. Verwenden Sie mehrere Methoden, passende Kontrollen und quantitative Effekte statt eines einzigen illustrativen Prompts.
Superposition und spärliche Features
Neuronale Netze können mehr Features darstellen als einzelne Dimensionen, indem sie sie überlagern. Ein Neuron kann daher für mehrere unverwandte Muster aktiv sein, was neuronale Labels irreführend macht.
Spärliche Autoencoder lernen ein größeres Wörterbuch von Features aus Modellaktivierungen. Sie können Muster besser trennbar machen, doch die gewählte Sparsamkeit, Trainingsdaten, Rekonstruktionsfehler und automatisierte Labels beeinflussen, was wiederhergestellt wird. Neural‑network-Features erfordern weiterhin kausale Validierung.
Sicherheit, Debugging und Einschränkungen
Mechanistische Werkzeuge können helfen, memorisierte Fakten, Vorurteile, täuschende Strategien oder fehlerhafte Schaltkreise zu finden und können das Bearbeiten oder Überwachen unterstützen. Dieselben Werkzeuge können verteilte, seltene oder kontextabhängige Berechnungen übersehen.
Betrachten Sie Befunde als abgegrenzte Evidenz: Modellversion, Aufgabe, Datensatz, Schicht, Intervention, Effekt und Unsicherheit. Verknüpfen Sie Interpretation mit Verhaltensbewertungen, Red‑Teaming und responsible‑AI-Governance, anstatt sie als allgemeines Sicherheitszertifikat zu verwenden.
Repräsentationen, Schaltkreise und kausale Evidenz
Mechanistische Interpretierbarkeit untersucht, wie interne Berechnungen das Modellverhalten erzeugen. Forschende inspizieren Aktivierungen, Gewichte, Attention und Zwischen‑Features und formulieren dann Hypothesen über Repräsentationen und Schaltkreise. Eine Repräsentation ist nicht zwingend in einem einzelnen Neuron gespeichert; sie kann über Richtungen, Schichten, Tokens und kontextabhängige Kombinationen verteilt sein.
Spärliche Autoencoder versuchen, dichte Aktivierungen in eine größere Menge von Features zu zerlegen, die selektiv aktivieren. Feature‑Labels sind menschliche Interpretationen beobachteter Beispiele, nicht Ground‑Truth. Rekonstruktionsfehler, Sparsamkeit, Feature‑Aufspaltung, Absorption und tote Features beeinflussen, was die Zerlegung offenbart und was sie verpasst.
Korrelation ist für einen mechanistischen Anspruch unzureichend. Aktivierungs‑Patchen, Ablation, kausales Tracing, Steering und gezielte Gewicht‑Interventionen testen, ob eine Komponente das Verhalten wie vorhergesagt ändert. Interventionen können auch Zustände außerhalb der Verteilung erzeugen, sodass Ergebnisse Kontrollen, Dosis‑Wirkungs‑Analysen, alternative Erklärungen und Replikation über Prompts und Modelle hinweg benötigen.
Ein rigoroser Interpretierbarkeits‑Workflow
Beginnen Sie mit einem präzise gemessenen Verhalten und einem Datensatz, der konkurrierende Hypothesen trennt. Lokalisieren Sie relevante Schichten, Positionen, Komponenten oder Features; inspizieren Sie Kandidaten‑Mechanismen; intervenieren Sie; und testen Sie, ob der vorgeschlagene Schaltkreis neue Fälle vorhersagt. Halten Sie explorative Beispiele von bestätigenden Bewertungen getrennt, um Selektionsbias zu reduzieren.
Automatisierte Werkzeuge können Neuronen, Features, Köpfe oder Pfade ranken, während Sprachmodelle Beschreibungen vorschlagen können. Automatisierung erhöht die Abdeckung, kann jedoch plausible Geschichten erzeugen. Bewerten Sie Erklärungen anhand von zurückgehaltenen Aktivierungsbeispielen und kausalen Vorhersagen, protokollieren Sie Unsicherheit und machen Sie Artefakte reproduzierbar mit Modellversion, Tokenizer, Prompts und Code.
Mechanismen können polysemant, redundant, nichtlinear und verteilt sein. Das Entfernen einer Komponente kann durch andere kompensiert werden, während ein Feature an mehreren Verhaltensweisen teilnehmen kann. Negative Befunde sind informativ: ein scheinbarer Schaltkreis, der außerhalb kuratierter Beispiele scheitert, sollte eingegrenzt oder verworfen werden, anstatt mit einer zunehmend vagen Erklärung gerettet zu werden.
Anwendungen, Einschränkungen und Sicherheitsbehauptungen
Interpretierbarkeit kann helfen, Halluzinationen, Vorurteile, Memorierung, Jailbreak‑Verhalten oder unerwartete Generalisierung zu debuggen; Modelle zu vergleichen; und wissenschaftliche Hypothesen zu generieren. Sie kann auch Features für Monitoring oder Intervention identifizieren. Diese Anwendungen erfordern aufgabenspezifische Validierung, da eine nützliche Forschungsvisualisierung nicht automatisch eine zuverlässige Produktionskontrolle darstellt.
Das Fehlen eines erkannten Features beweist nicht das Fehlen einer Fähigkeit oder Absicht, und ein lesbares Feature beweist nicht, dass das Modell es in einer bestimmten Antwort nutzt. Werkzeuge beobachten eine Projektion der Berechnung mit begrenzter Abdeckung. Sicherheitsbehauptungen müssen Detektionssensitivität, Fehlalarme, Verteilung, Angreifer und bekannte blinde Stellen angeben.
Nutzen Sie Interpretierbarkeit zusammen mit Verhaltensbewertungen, Red‑Teaming, Daten‑Governance, Zugriffskontrollen, Monitoring und Incident‑Response. Veröffentlichen Sie Methoden und Gegenbeispiele, wenn möglich. Das Feld entwickelt sich schnell, aber aktuelle Techniken liefern keine vollständige, treue Erklärung des Denkens von Frontier‑Modellen oder eine allgemeine Garantie für Alignment.
Durchgeführtes Beispiel: Testen eines vorgeschlagenen Modell‑Schaltkreises
Angenommen, ein Modell scheint eine Reihe von Attention‑Köpfen und Features zu verwenden, um ein indirektes Objekt in einem Satz zu lösen. Forschende definieren einen kontrollierten Datensatz mit variierenden Namen, Positionen, Störfaktoren und Gegenbeispielen und messen dann das Verhalten. Die Aktivierungsinspektion identifiziert Kandidaten‑Komponenten, aber die Hypothese wird vor der Intervention formuliert: welche Information jede Komponente trägt, wohin sie sich bewegt und wie ihre Änderung die Ausgabe verändern sollte.
Aktivierungs‑Patchen und Ablation testen Notwendigkeit und Hinreichung über zurückgehaltene Beispiele. Eine gezielte Änderung, die das vorhergesagte Token in die erwartete Richtung verschiebt, unterstützt den Mechanismus; ein breiter Leistungsabfall nicht. Kontrollen patchen nicht verwandte Positionen und Komponenten, variieren die Interventionsstärke und vergleichen alternative Schaltkreise. Das Team veröffentlicht negative Fälle, in denen die Erklärung scheitert, und vermeidet es, allein aus Korrelation einen menschenlesbaren Zweck zuzuweisen.
Um eine Sicherheitsanwendung zu beanspruchen, muss die Methode das relevante Verhalten mit bekannter Sensitivität unter realistischen Prompts und adversarialer Anpassung erkennen. Feature‑Monitore werden auf Fehlalarme, Umgehung, Modell‑Updates und kausale Relevanz evaluiert. Interpretierbarkeits‑Belege können Debugging und weitere Tests leiten, aber die Durchsetzung bleibt in externen Kontrollen und Verhaltens‑Monitoring. Ein überzeugendes Schaltkreis‑Diagramm ist eine wissenschaftliche Hypothese mit Evidenz – keine vollständige Erklärung eines Modells oder Garantie für unbekanntes Verhalten.
Praktische Checkliste zur Umsetzung
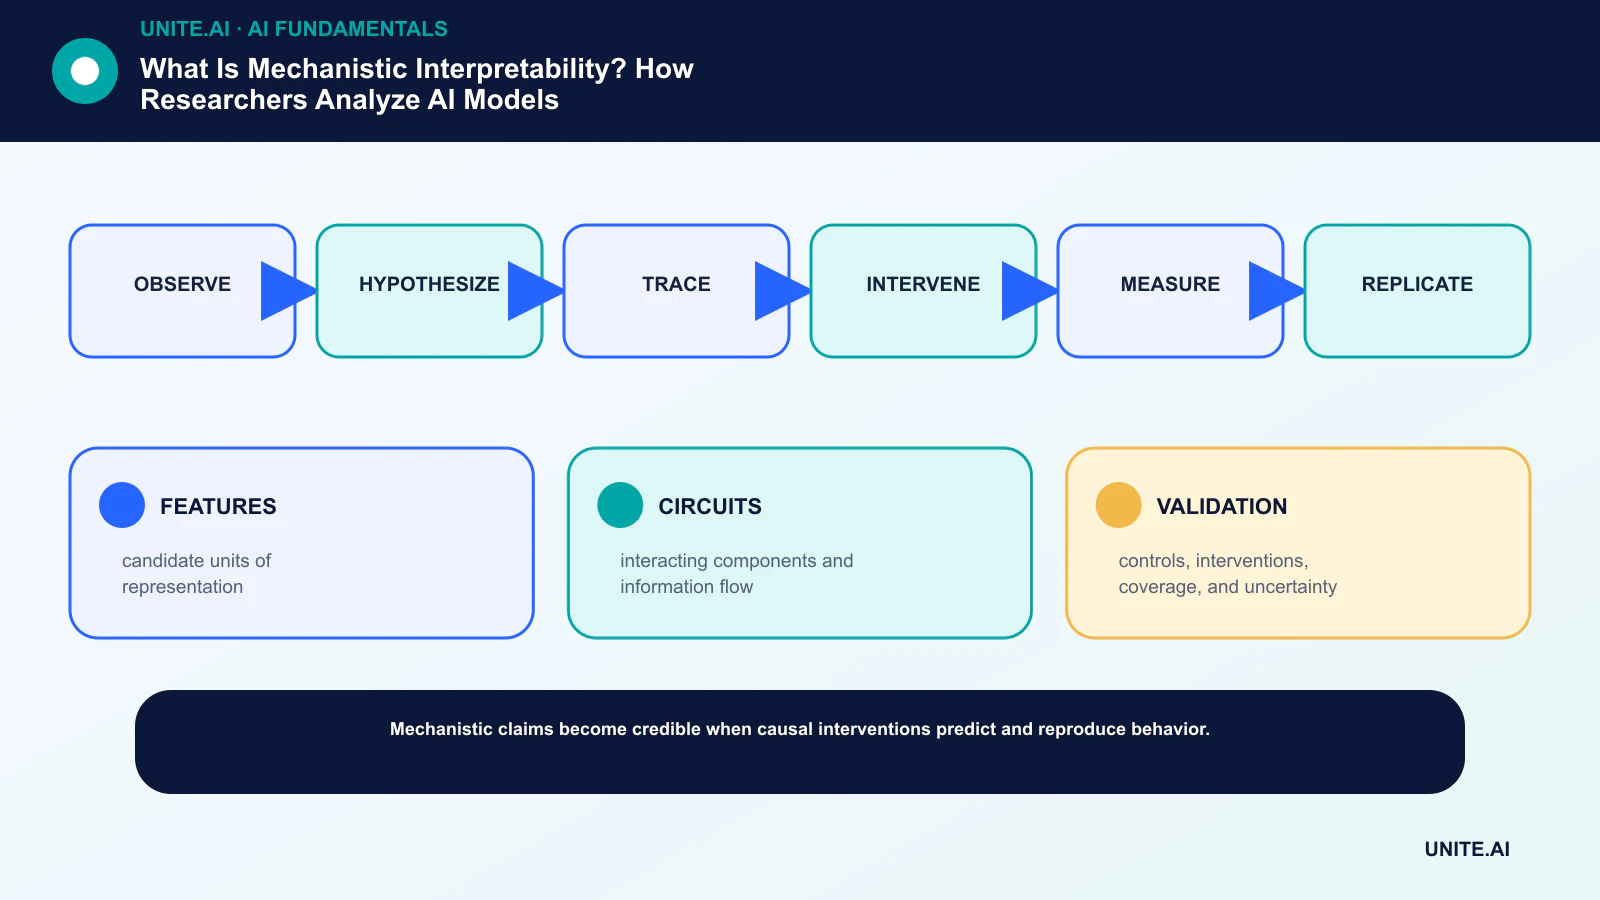
Verwandeln Sie das Konzept in einen begrenzten, testbaren Workflow: beobachten → hypothesieren → nachverfolgen → intervenieren → messen → replizieren. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, setzen Sie Akzeptanz‑ und Abbruchkriterien, testen Sie repräsentative Fehlfälle und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und verstehen kann, was sich geändert hat.
Vor dem Start führen Sie eine dokumentierte Bereitschafts‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Abhängigkeits‑Fehler und Missbrauch; bewahren Sie die Evidenz und ungelöste Risiken. Definieren Sie, wer die Veröffentlichung genehmigen, einen Schwellenwert ändern, eine Ausgabe überschreiben oder den Betrieb stoppen kann. Überprüfen Sie die Entscheidung erneut, sobald reale Daten vorliegen, da ein technisch erfolgreicher Pilot nicht automatisch zuverlässige Leistung im größeren Maßstab garantiert.
- MERKMALE: Kandidierende Repräsentationseinheiten.
- SCHALTKRÄFTE: interagierende Komponenten und Informationsfluss.
- VALIDIERUNG: Kontrollen, Interventionen, Abdeckung und Unsicherheit.
Häufig gestellte Fragen
Ist mechanistische Interpretierbarkeit dasselbe wie das Lesen von Modellgewichten?
Nein. Rohgewichte erklären sich nicht von selbst. Forschende analysieren Aktivierungen, Features, Komponenten und Interventionen, um kausale Hypothesen zu erstellen und zu testen.
Können spärliche Autoencoder ein LLM vollständig erklären?
Nein. Sie bieten eine Kandidaten‑Feature‑Basis und können die Schaltkreis‑Analyse unterstützen, aber Abdeckung, Treue, Rekonstruktion, Beschriftung und Skalierbarkeit bleiben offene Probleme.
Primärreferenzen












