
Grundlagen der KI
Was ist Reinforcement Learning aus menschlichem Feedback (RLHF)?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
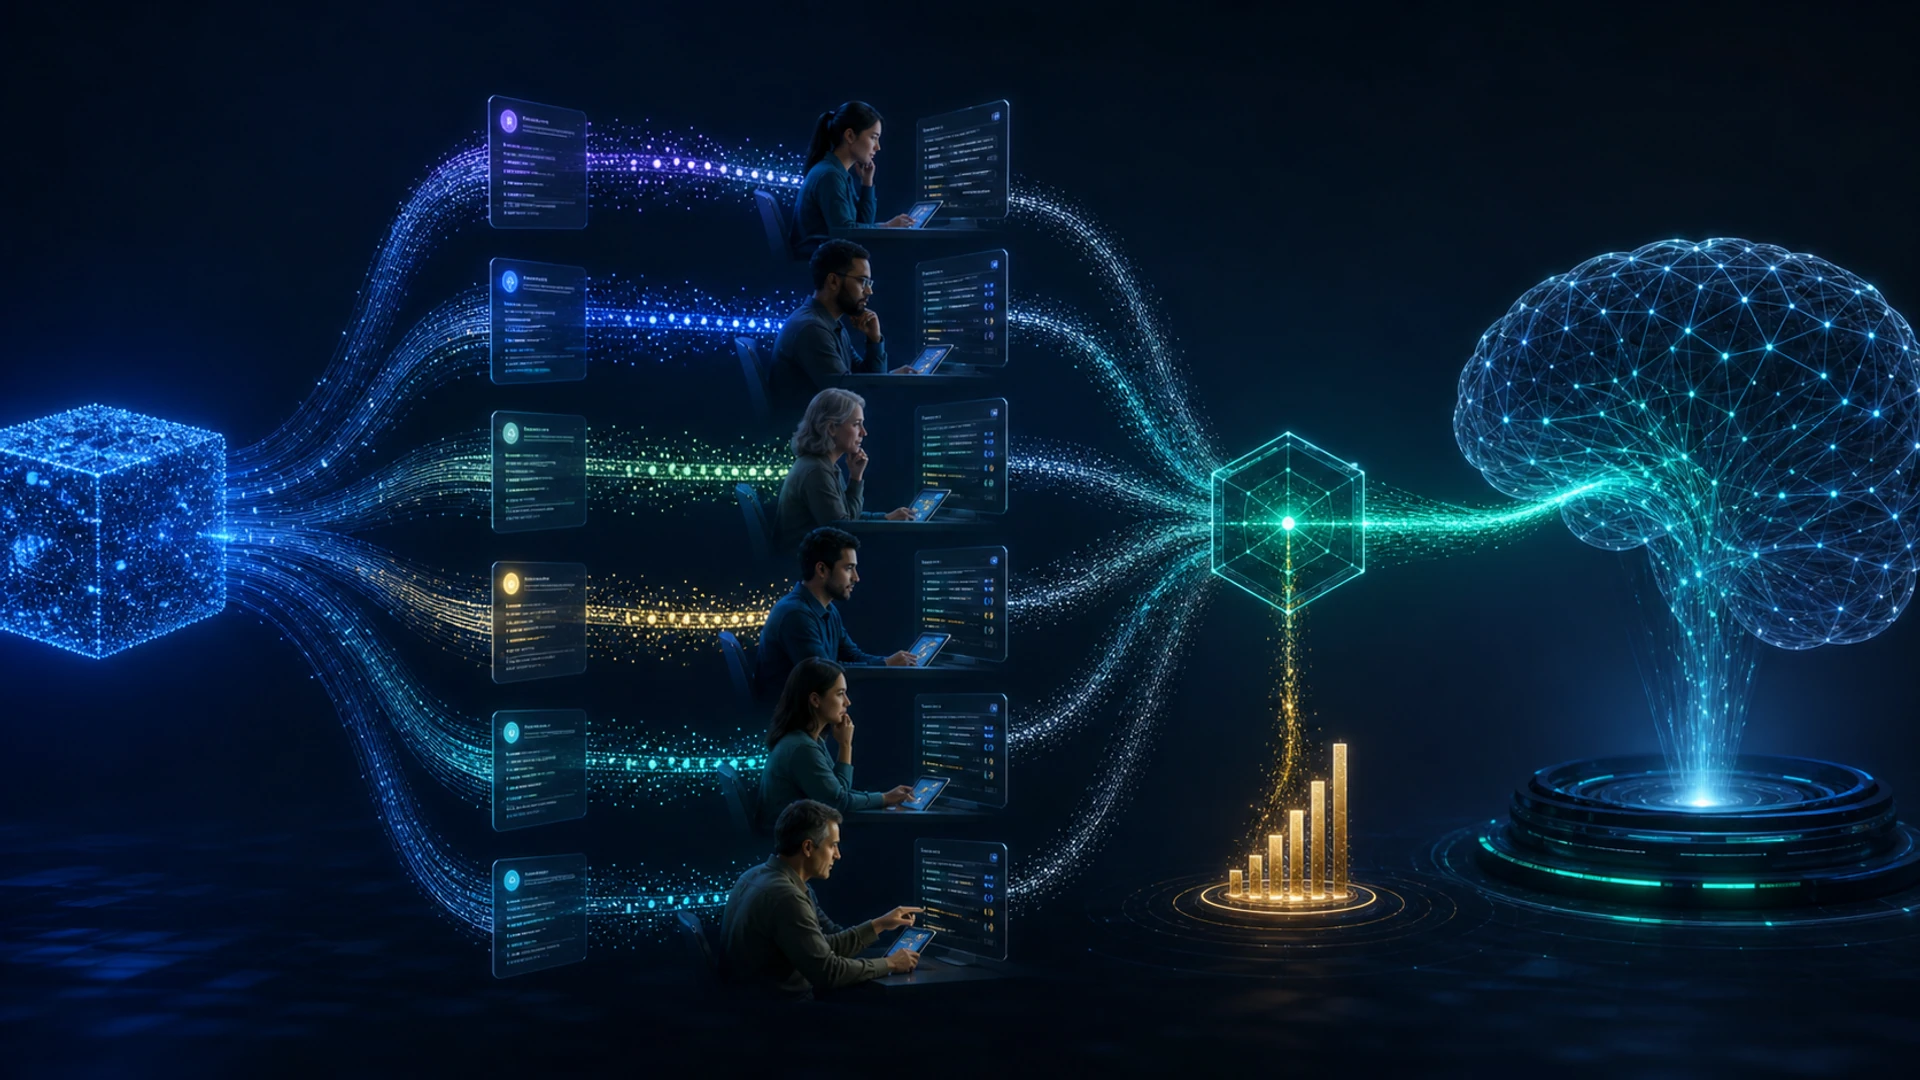
Reinforcement Learning aus menschlichem Feedback (RLHF) ist eine Gruppe von Verfahren, die menschliche Urteile nutzen, um ein Modell zu optimieren, wenn das gewünschte Verhalten schwer mit einer einfachen automatischen Belohnung zu spezifizieren ist. Bei Sprachmodellen vergleichen Menschen häufig Kandidatenantworten, und ein erlerntes Präferenzmodell wandelt diese Vergleiche in ein Trainingssignal um.
RLHF kann ein vortrainiertes Modell hilfreicher oder besser an eine schriftliche Richtlinie angepasst machen, beweist jedoch weder Wahrhaftigkeit noch eine Ausrichtung auf jeden Nutzer. Das Ergebnis hängt davon ab, wer das Feedback liefert, wie Eingabeaufforderungen ausgewählt werden, was das Belohnungsmodell darstellen kann und wie die Optimierung eingeschränkt wird.
Wesentliche Erkenntnisse
- RLHF folgt in der Regel dem Vortraining und dem überwachten Instruktions‑Tuning.
- Paarweise Präferenzen trainieren ein Belohnungs‑ oder Präferenzmodell; die Policy‑Optimierung bevorzugt anschließend Ausgaben mit höheren Punktzahlen.
- Belohnungs‑hacking, Uneinigkeit der Annotatoren, Verteilungsverschiebungen und Überoptimierung bleiben bedeutende Risiken.
- Bewerten Sie die endgültige Policy direkt hinsichtlich Aufgabenqualität, Sicherheit, Kalibrierung und Effekte auf Untergruppen.
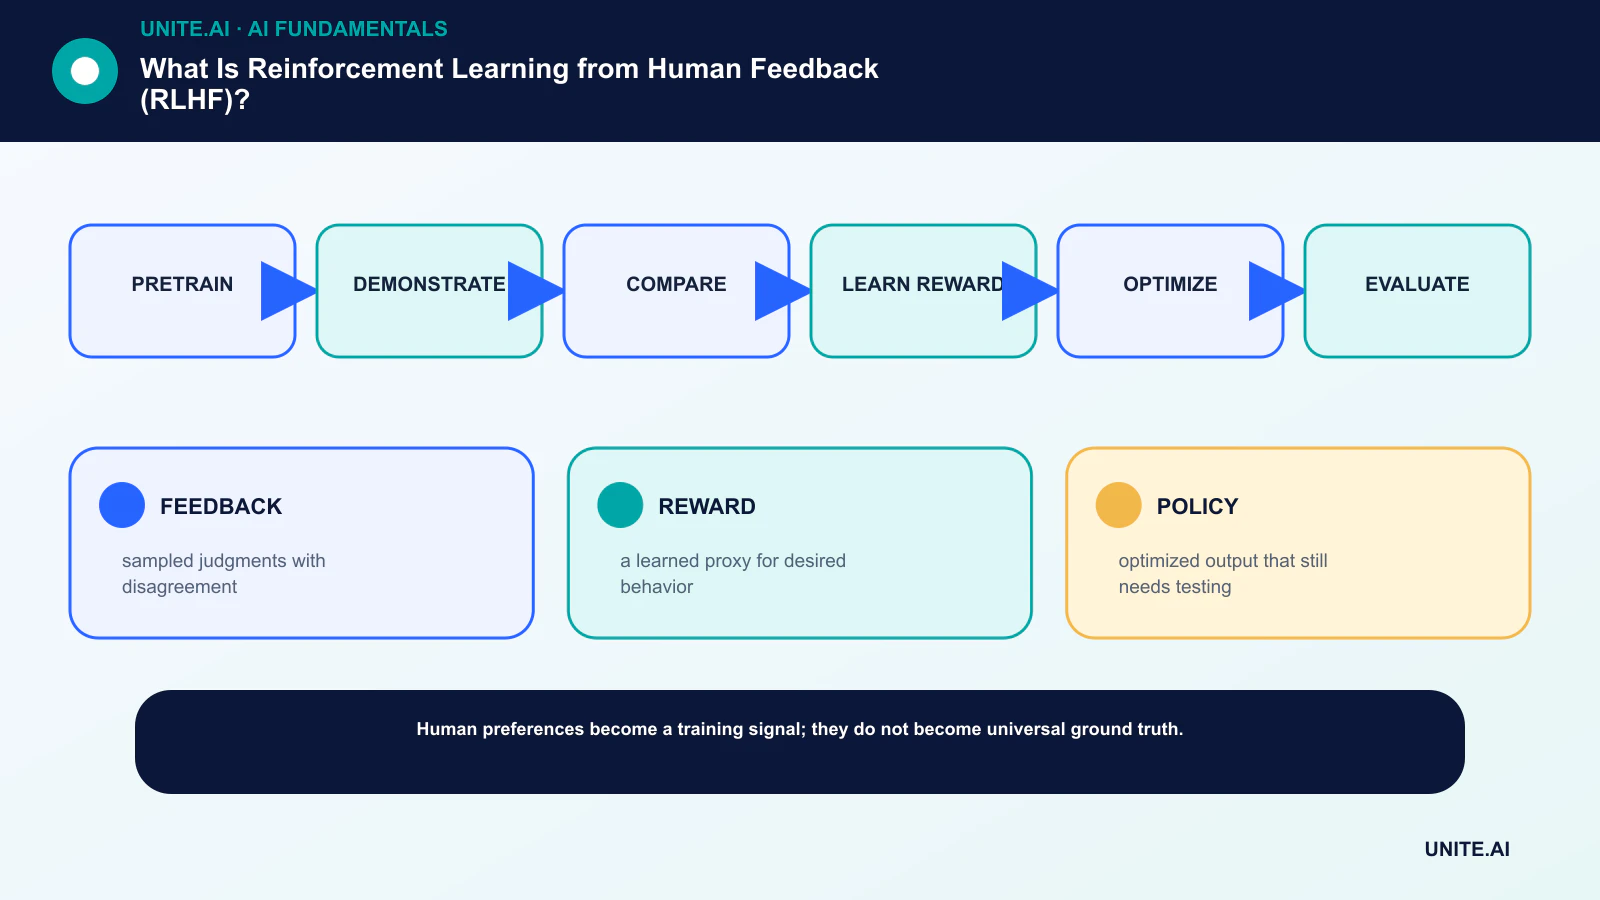
Die gängige RLHF‑Pipeline
Ein Sprachmodell lernt zunächst durch Vortraining die breite statistische Struktur. Anschließend nutzt das überwachte Feintuning Demonstrationen gewünschter Antworten. Für die Sammlung von Präferenzen bewerten oder wählen Annotatoren zwischen Ausgaben für dieselbe Eingabeaufforderung.
Ein Belohnungsmodell lernt, diese Vergleiche vorherzusagen. Ein reinforcement-learning-Algorithmus wie PPO kann das Sprachmodell gegen diese erlernte Belohnung optimieren, während eine Strafe verhindert, dass es zu stark von der Referenz‑Policy abweicht.
Feedback ist Messung, nicht Grundwahrheit
Annotatoren können uneinig sein, weil Anweisungen mehrdeutig sind, Fachwissen variiert oder Werte tatsächlich im Konflikt stehen. Position, Wortreichtum, Selbstvertrauen und Stil können Präferenzen verzerren. Ein hochwertiges Programm schult Bewerter, misst Übereinstimmung, prüft Beispiele und bewahrt Unsicherheit.
Auch die Stichprobenauswahl ist wichtig. Wenn das Präferenzset schwierige Sprachen, Domänen oder schädliche Inhalte ausschließt, kann das Belohnungsmodell sie nicht zuverlässig überwachen. Die Disziplin Data‑Science ist ebenso wichtig wie der Optimierer.
Fehlermodi
Die Policy kann Schwächen der erlernten Belohnung ausnutzen und Ausgaben erzeugen, die gut bewertet werden, ohne die zugrunde liegende Absicht zu erfüllen. Übermäßige Optimierung kann die Vielfalt verringern, einen bevorzugten Stil verstärken oder das Modell zu selbstsicherer Zustimmung verleiten.
Das Belohnungsmodell selbst kann außerhalb seiner Trainingsverteilung versagen. Teams sollten adversarielle Eingabeaufforderungen, faktische Aufgaben, Ablehnungsgrenzen, Kalibrierung und das Verhalten bei unterschiedlichen Optimierungsstärken testen, anstatt sich nur auf eine aggregierte Präferenz‑Gewinnrate zu verlassen.
Alternativen und Ergänzungen
Direct Preference Optimization lernt aus Präferenzpaaren, ohne eine separate Policy über einen Online‑Reinforcement‑Learning‑Loop anzupassen. Rejection‑Sampling, überwachte Präferenz‑Feinabstimmung, regelbasiertes Feedback und Prozess‑Supervision bieten weitere Kompromisse.
Keine Methode eliminiert die Notwendigkeit von Prompt‑, Retrieval‑, Tool‑ und Anwendungsebene‑Kontrollen. Das Post‑Training formt das Verhalten; eingesetzte Systeme benötigen weiterhin fundierte Evidenz, Berechtigungen, Überwachung und menschliche Eskalation.
Wie Präferenzmodelle trainiert werden
Für einen Prompt x und zwei Antworten y₁ und y₂ weist ein Präferenzmodell skalare Werte zu und wird so trainiert, dass die bevorzugte Antwort die höhere Punktzahl erhält. Ein gängiger Verlust basiert auf der Wahrscheinlichkeit, dass ein Wert den anderen übertrifft. Dadurch werden zahlreiche paarweise Urteile in eine Funktion umgewandelt, die neu generierte Ausgaben bewerten kann.
Das Modell lernt alle Signale, die die gesammelten Entscheidungen vorhersagen. Wenn Bewerter selbstbewusste Prosa, längere Antworten, bestimmte kulturelle Normen oder vertraute Standpunkte bevorzugen, können diese Korrelationen zu Belohnungsmerkmalen werden. Ausgewogene Anweisungen, Gegenbeispiele, Experten‑Reviews und Audits für oberflächliche Präferenzen reduzieren das Problem, beseitigen es jedoch nicht.
Präferenzdaten können Unentschieden, Ranglisten, Kritiken, skalare Labels oder Demonstrationen enthalten. Die Auswahl der Paare ist wichtig: Vergleiche zwischen offensichtlich unterschiedlichen Antworten vermitteln weniger über subtile Qualitätsgrenzen, während nur schwierige Paare das Training instabil machen können. Aktives Sampling kann informative Meinungsverschiedenheiten anvisieren, kann aber die Datenverteilung verändern.
Policy‑Optimierung und Regularisierung
PPO‑basiertes RLHF entnimmt der aktuellen Policy Antworten, bewertet sie mit dem Belohnungsmodell und aktualisiert die Policy, um die erwartete Belohnung zu steigern. Eine Kullback‑Leibler‑Strafe oder eine verwandte Beschränkung hält die Policy nahe an der überwachten Referenz, begrenzt destruktives Drift und verhindert die Ausnutzung schmaler Schwächen des Belohnungsmodells.
Die Optimierungsstärke ist eine Produkteinstellung. Zu wenig lässt das gewünschte Verhalten unverändert; zu viel kann zu Belohnungs‑Hacking, repetitiver Formulierung, Unterwürfigkeit oder verringerter Vielfalt führen. Visualisieren Sie Qualitäts‑ und Sicherheitsmetriken gegenüber Belohnung und Divergenz während des Trainings, anstatt einen Checkpoint ausschließlich nach Belohnung auszuwählen.
Direkte Präferenz‑Methoden leiten ein Ziel aus Präferenzpaaren und einem Referenzmodell ab, ohne einen expliziten Online‑RL‑Loop. Sie können das Training vereinfachen, erben jedoch weiterhin die Qualität, Abdeckung und Annahmen der Präferenzen sowie der Referenz‑Policy. Verfassungs‑ oder KI‑generiertes Feedback ändert, wer Labels liefert; es beseitigt nicht die Notwendigkeit, Werte und Fehler mit Menschen zu validieren.
Evaluierung und Daten‑Governance
Verwenden Sie blinde Vergleiche, aufgaben‑spezifische Tests, adversarielle Prompts, Faktizitäts‑Checks, Präzision und Recall bei Ablehnungen sowie Untergruppen‑Reviews. Trennen Sie Evaluatoren nach Möglichkeit von den Trainingsdaten. Eine Gewinnrate gegenüber einem älteren Modell kann absolute Fehler verbergen, wenn beide Kandidaten schwach sind.
Dokumentieren Sie die Rekrutierung von Annotatoren, Vergütung, Fachwissen, Geografie, Sprache, Anweisungen, Exposition gegenüber schädlichen Inhalten, Uneinigkeit, Schlichtung und Qualitätskontrollen. Feedback‑Arbeit kann psychologische Risiken bergen, und verantwortungsvolle Datenoperationen umfassen Unterstützung für die Arbeiter sowie das Recht, belastende Aufgaben abzulehnen.
Nach dem Einsatz sollten Sie Präferenz‑Drift und Über‑Generalisierung überwachen. Eine für lockere Unterstützung abgestimmte Policy kann in medizinischen oder rechtlichen Kontexten problematisch reagieren. Halten Sie Domänengrenzen, Retrieval, Berechtigungen und Eskalation außerhalb der RLHF‑Annahme und trainieren Sie nur neu, wenn neue Evidenz die Änderung rechtfertigt.
Eine konkrete RLHF‑Trainings‑ und Evaluations‑Pipeline
Ein typisches Projekt beginnt mit einem vortrainierten Sprachmodell und einem Instruktions‑Datensatz, der für das überwachte Feintuning verwendet wird. Anschließend vergleichen Annotatoren Kandidatenantworten anhand einer schriftlichen Rubrik, die Korrektheit, Relevanz, Stil, Sicherheit und Unsicherheit abdeckt. Paarweise Präferenzen trainieren ein Belohnungsmodell oder optimieren die Policy direkt. Das Sampling muss gewöhnliche Aufgaben, schwierige Randfälle, adversarielle Prompts, mehrere Sprachen und Bereiche, in denen Annotatoren berechtigt uneinig sind, einschließen.
Die Genauigkeit des Belohnungsmodells bei gehaltenen Vergleichen ist notwendig, aber nicht hinreichend. Die optimierte Policy kann Fehler im erlernten Reward ausnutzen, übermäßig wortreich werden, harmlose Anfragen ablehnen oder Fähigkeiten verlieren. Verfolgen Sie Aufgaben‑Benchmarks, menschliche Präferenzen, Kalibrierung, Sicherheit, Vielfalt und Divergenz vom Referenzmodell während des Trainings. Sammeln Sie periodisch neue Vergleiche von der sich ändernden Policy, damit die Präferenzdaten die tatsächlich vom Modell erzeugten Ausgaben abdecken.
Dokumentieren Sie, wer die Präferenzen geliefert hat, deren Anweisungen, Vergütung, Uneinigkeit, Qualitätskontrollen und kulturelle oder domänenspezifische Grenzen. Nutzen Sie Experten‑Reviewer, wenn Fehler spezialisierte Schäden verursachen können. Führen Sie Red‑Team‑Tests sowohl für das Belohnungsmodell als auch für die endgültige Policy durch, erhalten Sie Verhaltens‑Regressionstests und planen Sie die Bereitstellung. RLHF formt das Verhalten anhand gemessener Präferenzen; es beweist weder Wahrhaftigkeit, beseitigt Vorurteile, noch löst das umfassendere Problem, zu spezifizieren, was ein Modell in jedem Kontext tun soll.
Praktische Implementierungs‑Checkliste
Verwandeln Sie das Konzept in einen begrenzten, testbaren Workflow: Vortraining → Demonstration → Vergleich → Belohnung lernen → Optimierung → Evaluation. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie die Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, legen Sie Akzeptanz‑ und Abbruchkriterien fest, testen Sie repräsentative Fehlermodi und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Bereitschafts‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Ausfälle von Abhängigkeiten und Missbrauch; bewahren Sie die Evidenz und ungelöste Risiken. Definieren Sie, wer die Freigabe genehmigen, Schwellenwerte ändern, eine Ausgabe überschreiben oder den Betrieb stoppen kann. Überprüfen Sie die Entscheidung erneut, sobald reale Daten vorliegen, da ein technisch erfolgreicher Pilot keine zuverlässige Leistung im größeren Maßstab garantiert.
- FEEDBACK: gesampelte Urteile mit Uneinigkeit.
- REWARD: ein erlerntes Proxy für gewünschtes Verhalten.
- POLICY: optimierte Ausgabe, die noch getestet werden muss.
Häufig gestellte Fragen
Ist RLHF dasselbe wie Feintuning?
RLHF ist eine Form des Post‑Trainings, das präferenzbasierte Belohnungen nutzt. Überwachtes Feintuning trainiert direkt auf Zielausgaben; viele Pipelines verwenden beides.
Macht RLHF ein Modell wahrhaftig?
Es kann das durch den Feedback‑Prozess gemessene Verhalten verbessern, aber ein Modell kann weiterhin falsch, überzeugend oder das Belohnungssystem strategisch ausnutzen. Wahrhaftigkeit erfordert direkte Evaluierung und Fundierung.
Primärreferenzen












