
Grundlagen der KI
Was ist föderiertes Lernen?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
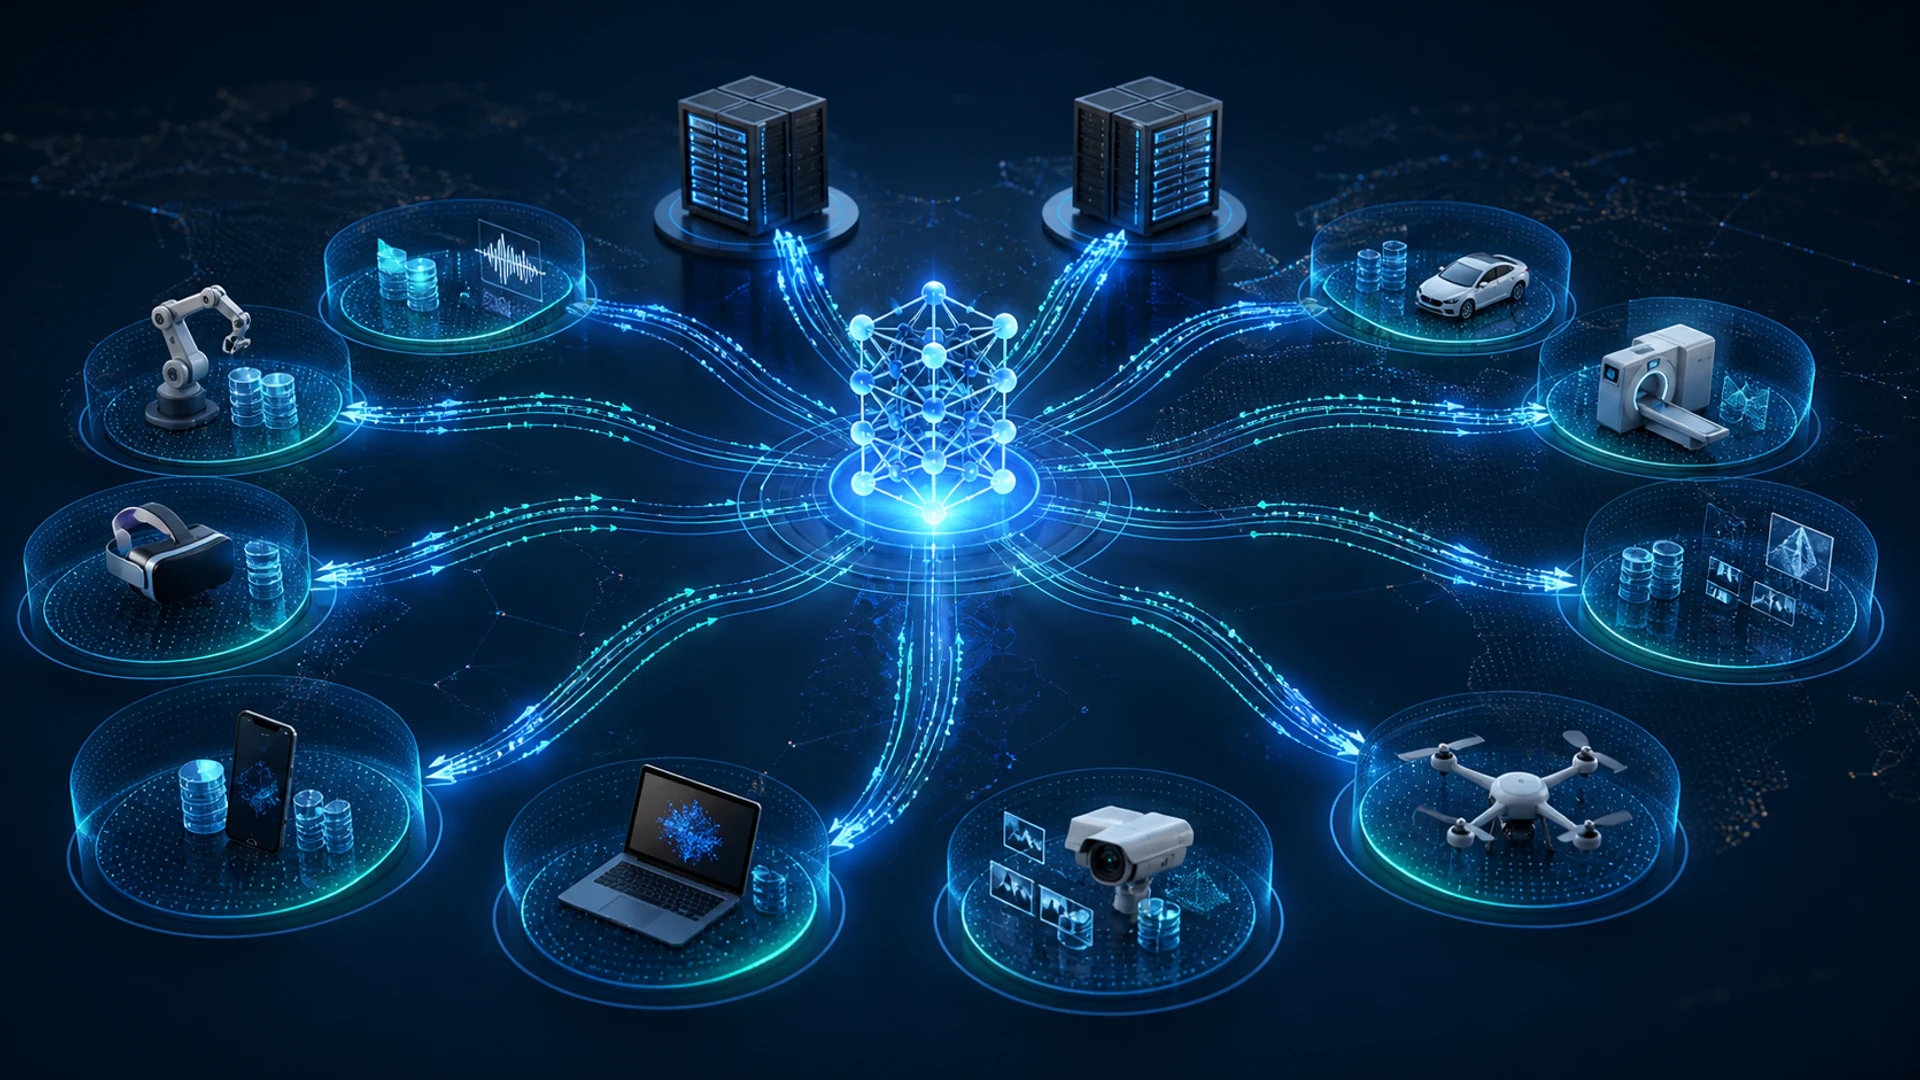
Föderiertes Lernen trainiert ein gemeinsames Modell über mehrere Geräte oder Organisationen hinweg, wobei die Roh‑Trainingsdaten jedes Teilnehmers lokal bleiben. Ein Koordinator verteilt Modellparameter, Clients berechnen Updates auf ihren eigenen Datensätzen, und ein Aggregationsschritt kombiniert diese Updates.
Lokale Speicherung von Datensätzen ist nützlich, aber sie ist nicht gleichbedeutend mit Datenschutz oder Sicherheit. Modell‑Updates können Informationen preisgeben, kompromittierte Clients können das Training vergiften, und der Koordinator benötigt dennoch Authentifizierung, Transport‑Sicherheit, Zugriffskontrollen und ein definiertes Vertrauensmodell.
Wesentliche Erkenntnisse
- Föderiertes Lernen verlagert die Berechnung zu verteilten Daten; es verschiebt nicht den Rohdatensatz zu einem zentralen Trainer.
- Cross‑Device‑Systeme umfassen viele intermittierende Geräte, während Cross‑Silo‑Systeme weniger, dafür stabilere Organisationen einbeziehen.
- Sichere Aggregation und differentielle Privatsphäre adressieren unterschiedliche Risiken und können kombiniert werden.
- Nicht‑IID‑Daten, begrenzte Bandbreite, unzuverlässige Teilnahme und bösartige Updates sind zentrale Design‑Constraints.
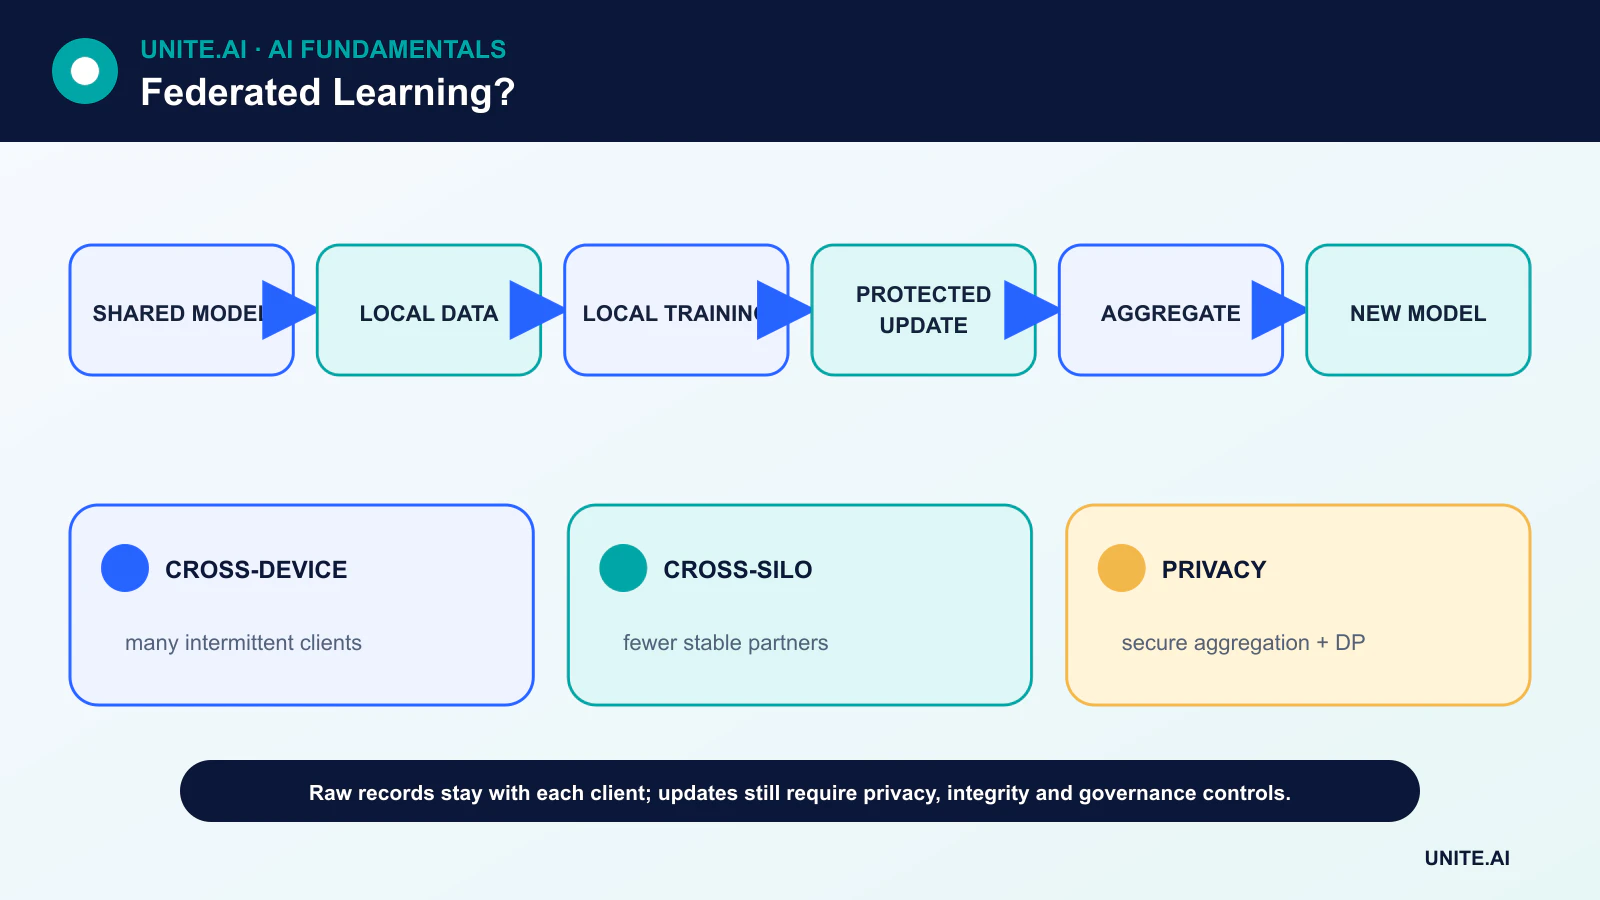
Der Lebenszyklus des föderierten Mittelwerts
Eine typische Runde beginnt, wenn ein Koordinator geeignete Clients auswählt und das aktuelle Modell sendet. Jeder Client trainiert lokal für eine begrenzte Anzahl von Schritten und erzeugt ein Parameter‑ oder Gradient‑Update. Der Koordinator aggregiert die zulässigen Updates – häufig gewichtet nach der lokalen Beispielzahl – und veröffentlicht das neue gemeinsame Modell.
Nur ein Bruchteil der Clients kann in jeder Runde teilnehmen. Das Protokoll muss abgebrochene Verbindungen, Versionskonflikte und Geräte, die nicht trainieren können, während sie laden, beschäftigt oder offline sind, tolerieren. Kommunikation kann die Berechnung dominieren, sodass Update‑Kompression und weniger Rundendurchläufe oft wichtiger sind als die rohe Beschleunigergeschwindigkeit.
Cross‑Device gegenüber Cross‑Silo
Cross‑Device‑föderiertes Lernen kann Handys, Sensoren oder Browser umfassen, die vielen Einzelpersonen gehören. Die Clients sind zahlreich, nur schwach vertrauenswürdig und intermittierend verfügbar. Cross‑Silo‑föderiertes Lernen verbindet in der Regel eine kleinere Gruppe von Krankenhäusern, Banken oder Geschäftsbereichen mit stabiler Infrastruktur und vertraglicher Governance.
Die beiden Szenarien erfordern unterschiedliche Annahmen zu Identität, Audits und Ausfällen. Ein Cross‑Silo‑Projekt kann ein gemeinsames Schema und Validierungsverfahren aushandeln; ein Cross‑Device‑Dienst muss möglicherweise Millionen von Software‑Versionen und stark unausgewogene lokale Datensätze handhaben.
Sichere Aggregation, differentielle Privatsphäre und Verschlüsselung
Sichere Aggregation ist ein kryptografisches Protokoll, das dem Server ermöglicht, ein Aggregat wiederherzustellen, ohne jedes Client‑Update zu lesen. Differentielle Privatsphäre begrenzt, wie stark das veröffentlichte Ergebnis von einem einzelnen Datensatz oder Teilnehmer abhängen kann, indem Beiträge beschnitten und kalibrierter Rauschen hinzugefügt werden.
Keiner der beiden Mechanismen eliminiert jedes Risiko. Sichere Aggregation macht das Aggregat nicht harmlos, und differentielle Privatsphäre erzwingt einen Genauigkeits‑Privatsphäre‑Kompromiss, der mit einem expliziten Datenschutzbudget berücksichtigt werden muss. Verschlüsselung schützt Daten während der Übertragung oder Speicherung; sie verhindert jedoch nicht von selbst Inferenz aus einem Modell.
Nicht‑IID‑Daten und Modellqualität
Client‑Daten sind selten unabhängig und identisch verteilt. Ein Tastaturmodell sieht den Wortschatz jeder Person; Krankenhäuser versorgen unterschiedliche Bevölkerungsgruppen; Fabriken nutzen verschiedene Geräte. Diese Unterschiede können die Konvergenz verlangsamen und schlechte Leistungen bei kleinen Client‑Gruppen verdecken.
Die Bewertung sollte globale Metriken, pro‑Client‑ oder Kohorten‑Verteilungen, Kalibrierung und Fehlermeldungsanalyse umfassen. Ein zentraler Testdatensatz kann praktisch, aber unzureichend sein. Dies verbindet föderiertes Lernen mit Maschinelles Lernen-Datenqualität und strukturierter und unstrukturierter Daten-Governance.
Bedrohungen und betriebliche Kontrollen
Bösartige Clients können vergiftete Updates einreichen, Sybil‑Clients können die Aggregation verzerren, und ein kompromittierter Server kann ein gezieltes Modell verteilen. Abwehrmaßnahmen umfassen authentifizierte Registrierung, Anomalieerkennung, robuste Aggregation, Update‑Validierung, Ratenbegrenzungen und reproduzierbare Software‑Attestierung, wo praktikabel.
Föderiertes Lernen ist Teil eines umfassenderen Cybersicherheit-Programms. Teams sollten dokumentieren, wer den Koordinator steuert, welche Metadaten gesammelt werden, wie Teilnehmer austreten können, wie Modelle zurückgerollt werden und was geschieht, wenn Datenschutz‑ oder Qualitätstests fehlschlagen.
Föderierte Optimierung und Datenheterogenität
Föderiertes Lernen sendet ein Modell oder eine Update‑Aufgabe an teilnehmende Clients, trainiert lokal und aggregiert Updates, ohne rohe Beispiele zu zentralisieren. Beim föderierten Mittelwert führen ausgewählte Clients mehrere lokale Optimierungsschritte aus und der Server berechnet einen gewichteten Mittelwert, üblicherweise nach Beispielzahl. Kommunikationsrunden, lokale Epochen, Auswahl und Lernraten tauschen Bandbreite gegen Konvergenz aus. Cross‑Device‑Umgebungen umfassen viele unzuverlässige Handys oder Sensoren; Cross‑Silo‑Umgebungen umfassen weniger Organisationen mit stärkerer Rechenleistung, Identität und Governance.
Client‑Daten sind in der Regel nicht unabhängig und unausgewogen: Nutzer unterscheiden sich in Verhalten, Label‑Verteilung, Volumen und Verfügbarkeit. Lokales Training kann in unvereinbare Richtungen abdriften, wodurch ein einfacher Mittelwert instabil oder zugunsten aktiver, hochvolumiger Clients verzerrt wird. Algorithmen können proximale Terme, adaptive Server‑Optimierung, Clustering, Personalisierung oder Kontrollvariablen verwenden. Die Bewertung sollte globale und client‑spezifische Leistung, Rand‑Clients, Teilnahmehäufigkeit, Konvergenz, Kommunikation und Energie berichten. Ein guter Mittelwert kann verbergen, dass kleine oder seltene Client‑Populationen ein schlechteres Modell erhalten.
Privatsphäre, Sicherheit und Systemtechnik
Lokale Speicherung von Daten garantiert nicht per se Datenschutz. Gradienten und Updates können Mitgliedschaft oder Merkmale preisgeben, während das finale Modell Beispiele memorisieren kann. Sichere Aggregation verbirgt einzelne Updates vor dem Server, und differentielle Privatsphäre begrenzt den Informationsbeitrag durch Beschneiden und Hinzufügen von Rauschen, jedoch verändern beide die Nützlichkeit und betriebliche Komplexität. Definieren Sie das Bedrohungsmodell, die Datenschutzeinheit, das Budget und vertrauenswürdige Komponenten. Verschlüsselung während der Übertragung ist notwendig, verhindert jedoch keinen bösartigen Client, vergiftetes Update, kompromittierten Koordinator oder Inferenzangriff.
Abwehrmaßnahmen umfassen authentifizierte Clients, robuste Aggregation, Anomalie‑Checks, Update‑Begrenzungen, sichere Enklaven in einigen Designs und Validierung gegen saubere Daten. Sybil‑Angreifer können viele Clients erzeugen; Hintertüren können das Averaging überleben; das Verwerfen verdächtiger Updates kann ebenfalls legitimes seltenes Verhalten ausschließen. Versionieren Sie den Client‑Code, unterstützen Sie unterbrochene Runden, verhindern Sie Wiederholungen und planen Sie für Nachzügler und Geräteeinschränkungen. Zustimmung, Aufbewahrung, regionale Vorschriften und Löschung gelten weiterhin für lokale Daten und abgeleitete Updates.
Beispiel für Bereitstellung und Governance
Eine mobile Tastatur kann lokale Verbesserungen für das nächste Wort trainieren, doch die Ausrollung sollte eine Population nutzen, die nach Gerätefähigkeit und Zustimmung berechtigt ist, geschützte, beschnittene Updates sammeln und mit einer eingefrorenen Basis vergleichen. Validieren Sie Sprach‑ und Dialekt‑Leistung, Akku, Datenverbrauch und Memorierungsrisiko vor der Veröffentlichung. Clients benötigen signierte Trainingsaufgaben und Modell‑Updates; der Server benötigt eine auditierbare Rundenkonfiguration und Rollback. Föderiertes Lernen ist eine Architektur für verteiltes Lernen unter Einschränkungen, kein Ersatz für repräsentative Daten, Datenschutz‑Engineering oder Verantwortlichkeit.
Praktisches Beispiel: Föderiertes Lernen über Krankenhäuser hinweg
Krankenhäuser trainieren ein gemeinsames Bildqualitäts‑Modell, ohne Scans zu bündeln. Ein gemeinsames Protokoll definiert Geräte‑Metadaten, Labels, Vorverarbeitung, Client‑Eignung, lokale Epochen, Beschneidung und sichere Aggregation. Standorte behalten Patientendaten und senden geschützte Updates, während ein Koordinator jede Runde anhand lokaler Hold‑out‑Sätze bewertet. Die Ergebnisse berichten über standortbezogene und Rand‑Leistung, nicht nur einen volumengewichteten Mittelwert, da sonst kleine Krankenhäuser und Gerätetypen übersehen würden.
Das Bedrohungsmodell umfasst bösartige Updates, Mitgliedschafts‑Leckagen, kompromittierte Clients und Zugriff des Koordinators. Differentielle Privatsphäre wird mit einem dokumentierten Budget und getesteter Nützlichkeit konfiguriert. Modell‑ und Aufgaben‑Pakete sind signiert; Standorte können sich zurückziehen und Updates sind auditierbar. Eine vergiftete oder instabile Runde ersetzt das bereitgestellte Modell nicht automatisch. Das Projekt behält lokale Baselines und klinische Prüfungen bei und betrachtet die föderierte Architektur als eine Datenschutz‑Kontrolle innerhalb breiterer Einwilligungs‑, Sicherheits‑ und Governance‑Verpflichtungen.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Missbrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und eindeutige Evidenz von einem ansprechenden Prototyp unterscheiden kann.
Vor dem Start sollten Sie die Zuständigkeit für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung festlegen. Verwenden Sie eine gestufte Ausrollung, bewahren Sie ein sicheres Fallback und überprüfen Sie das Monitoring mit bewusst eingesetzten Fehlfunktionen. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und prüfen Sie dann Evidenz aus der Praxis nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung bestehen bleibt. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Zeitpunkt, zu dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Garantiert föderiertes Lernen, dass private Daten nicht preisgegeben werden können?
Nein. Es reduziert die Bewegung von Rohdaten, aber Updates und finale Modelle können weiterhin Informationen preisgeben. Datenschutz erfordert ein Bedrohungsmodell sowie zusätzliche technische und organisatorische Kontrollen.
Wann ist zentrales Training einfacher?
Wenn Daten rechtmäßig und sicher zentralisiert werden können, ist zentrales Training oft einfacher zu debuggen, reproduzieren und zu überwachen. Föderiertes Lernen ist dann gerechtfertigt, wenn die Verteilung eine echte Anforderung ist und nicht lediglich ein Marketing‑Ziel.
Primärreferenzen












