
Grundlagen der KI
Was ist ein Data Fabric?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Ein Data Fabric ist ein Architektur‑Muster zum Entdecken, Verbinden, Steuern und Bereitstellen von Daten über verteilte Systeme hinweg. Es stellt eine gemeinsame Metadaten‑ und Steuerungsebene bereit, sodass Personen und Anwendungen vertrauenswürdige Daten finden können, ohne jeden Datensatz in einem physischen Speicher zu erzwingen.
Ein Data Fabric ist kein einzelnes Produkt und verwischt nicht die Unterschiede zwischen Quellsystemen. Sein Nutzen hängt von genauen Metadaten, klarer Eigentümerschaft, durchsetzbaren Richtlinien, zuverlässiger Integration und dem Nachweis ab, dass die Nutzer Daten erhalten, die für ihren Zweck geeignet sind.
Wesentliche Erkenntnisse
- Eine metadatenreiche Steuerungsebene verbindet Kataloge, Datenherkunft, Qualität, Richtlinien und Zugriff.
- Daten können verteilt bleiben und je nach Arbeitslast kopiert, gestreamt, transformiert oder virtualisiert werden.
- Data Fabric ist technikorientiert; Data Mesh betont Domänen‑Eigentümerschaft und Daten‑als‑Produkt.
- Automatisierung unterstützt die Skalierung der Governance, doch verantwortliche Eigentümer definieren weiterhin Bedeutung, Qualität und zulässige Nutzung.
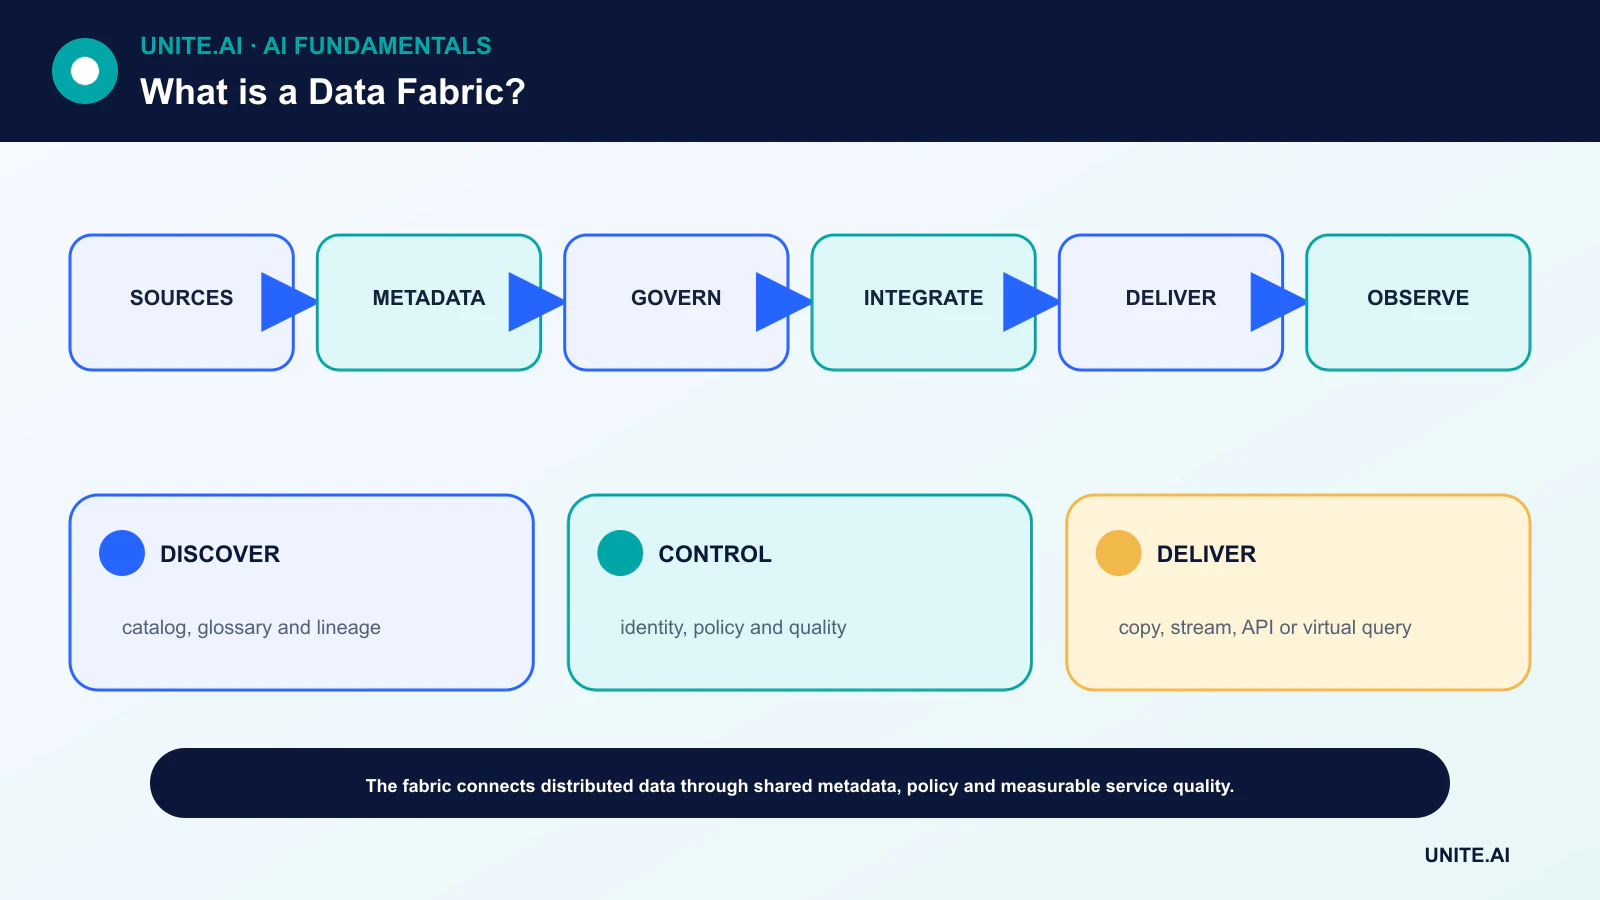
Die Steuerungsebene und die Datenebene
Die Datenebene umfasst Datenbanken, Dateien, Streams, APIs und die Pipelines, die sie bewegen oder abfragen. Die Steuerungsebene erfasst technische und geschäftliche Metadaten: Schemata, Eigentümer, Klassifikationen, Qualitätsmaße, Herkunft, Richtlinien und Nutzung.
Ein Katalog oder Wissensgraph kann diese Fakten verknüpfen, sodass ein Nutzer einen Datensatz entdecken und dessen Kontext verstehen kann. Das Fabric nutzt dann Metadaten, um Zugriff, Transformation, Beobachtbarkeit und Richtlinien‑Durchsetzung über heterogene Plattformen hinweg zu steuern.
Integration ohne einen verpflichtenden Speicher
Einige Arbeitslasten kopieren Daten mittels ETL; andere nutzen Change‑Data‑Capture, Ereignis‑Streams, APIs oder Abfrage‑Virtualisierung. Das passende Muster hängt von Aktualität, Leistung, Konsistenz, Souveränität, Kosten und den Grenzen des Quellsystems ab.
Virtueller Zugriff kann Duplizierung reduzieren, kann jedoch Nutzer der Latenz und Verfügbarkeit der Quelle aussetzen. Physische Materialisierung verbessert Leistung und Reproduzierbarkeit, erzeugt jedoch Synchronisations‑ und Lebenszyklus‑Verantwortungen.
Governance, Semantik und Qualität
Ein Business‑Glossar verleiht Begriffen wie Kunde, Auftrag oder aktivem Konto eine gemeinsame Bedeutung. Die Herkunft (Lineage) zeigt, wo ein Feld entstanden ist und wie es sich verändert hat. Klassifizierung und Richtlinien bestimmen, wer auf sensible Datensätze zugreifen darf und zu welchem Zweck.
Qualitätsregeln sollten an konkrete Anwendungsfälle geknüpft werden. Eine Vollständigkeit, die für ein Dashboard ausreichend ist, kann für automatisierte Entscheidungen unsicher sein. Ein Fabric sollte Aktualität, Validierungshistorie und bekannte Einschränkungen sichtbar machen, anstatt ein Asset lediglich als zertifiziert zu kennzeichnen.
Data Fabric, Mesh und Lakehouse
Data Mesh ist ein soziotechnischer Ansatz, der Domänenteams die Verantwortung für interoperable Datenprodukte überträgt. Ein Data Fabric betont gemeinsame technische Services und Metadaten‑Automatisierung. Organisationen können beides kombinieren: Domänen‑Eigentümerschaft kann über ein gemeinsames Fabric funktionieren.
Ein Lakehouse verbindet die Flexibilität eines Data Lakes mit dem Management und den Abfragefunktionen eines Data Warehouses. Es kann eine beteiligte Plattform sein, ist jedoch nicht das gesamte systemübergreifende Fabric. Ebenso bietet ein Warehouse oder Katalog allein nicht alle Integrations‑ und Richtlinien‑Funktionen.
Implementierung und Bewertung
Beginnen Sie mit einem wertvollen, systemübergreifenden Anwendungsfall und erfassen Sie die minimalen Quellen, Eigentümer, Richtlinien und Service‑Level‑Erwartungen. Etablieren Sie Identität, Metadaten‑Standards, Verträge, Tests und Beobachtbarkeit, bevor Sie automatisierte Empfehlungen hinzufügen.
Messen Sie die Entdeckungszeit, die Genehmigungszeit für den Zugriff, Vorfallraten, Datenaktualität, Wiederverwendung und das Vertrauen der Nutzer. Verknüpfen Sie das Fabric mit der Governance für strukturierte und unstrukturierte Daten sowie mit der Cybersicherheit; Konnektivität ohne Kontrolle kann die Angriffsfläche vergrößern.
Data‑Fabric‑Architektur und Metadaten‑Ebene
Ein Data Fabric ist ein architektonischer Ansatz zum Verbinden verteilter Daten über gemeinsame Metadaten, Governance, Integration und Zugriffs‑Services. Es ist nicht eine einzelne Datenbank oder ein Produkt. Quellen können in Warehouses, Lakes, operativen Systemen, Streams und SaaS‑Plattformen verbleiben, während Kataloge Datensätze beschreiben, die Herkunft Transformationen nachverfolgt, Richtlinien den Zugriff steuern und semantische Definitionen Konzepte wiederverwendbar machen. Virtualisierung, Replikation, APIs und Pipelines sind komplementäre Bereitstellungsmethoden, die nach Latenz, Skalierung, Quell‑Fähigkeiten und Konsistenzanforderungen gewählt werden.
Aktive Metadaten erfassen Schemata, Eigentümerschaft, Nutzung, Qualität, Klassifikationen, Herkunft, Abfragemuster und operative Ereignisse und können Automatisierung antreiben. Ein Wissensgraph kann Geschäftskonzepte mit physischen Feldern und Richtlinien verbinden. Automatisierung kann Joins vorschlagen, Drift erkennen, Klassifikationen verbreiten oder Vorfälle routen, doch inferierte Metadaten benötigen Vertrauen und Stewardship. Ein Katalog, der nicht mit Lieferung und Kontrollen verknüpft ist, wird zu Dokumentations‑Schulden; automatisierte Integration ohne semantische Eigentümerschaft erzeugt schneller Inkonsistenzen.
Integration, Governance und Datenprodukte
Batch‑ETL, Change‑Data‑Capture, Streams, Federation und Reverse‑ETL besitzen unterschiedliche Aktualitäts‑ und Fehlersemantiken. Definieren Sie autoritative Quellen, Identifier, Verträge, Ereigniszeit, späte Daten, Löschungen und Rekonsiliation. Virtuelle Abfragen vermeiden Kopien, hängen jedoch von Quell‑Leistung und Verfügbarkeit ab; Materialisierung erhöht Geschwindigkeit, erzeugt jedoch Verpflichtungen hinsichtlich Aktualität und Aufbewahrung. Sensible Richtlinien müssen für abgeleitete Daten, Caches, Embeddings und Exporte folgen oder neu bewertet werden.
Behandeln Sie wertvolle Datensätze als Produkte mit Eigentümern, Nutzern, Dokumentation, Service‑Erwartungen, Tests und Support. Föderierte Eigentümerschaft lässt Domänen Bedeutung managen, während gemeinsame Standards Interoperabilität bewahren. Zentrale Teams liefern Plattform‑Fähigkeiten und Governance, nicht das Eigentum an jedem Feld. Messen Sie Entdeckungszeit, Wiederverwendung, Datenqualität, Zugriffs‑Lead‑Time, Vorfalls‑Lösung, Adoption vertrauenswürdiger Metriken und Kosten. Die Anzahl von Katalog‑Einträgen oder Connectors beweist nicht, dass Menschen zuverlässige Daten finden und nutzen können.
Implementierungsstrategie
Starten Sie mit einer bereichsübergreifenden Journey, deren Verzögerungen und Risiken bekannt sind. Inventarisieren Sie Quellen und Verträge, etablieren Sie Identität und Klassifizierung, verknüpfen Sie Herkunft und Qualität und automatisieren Sie wiederkehrende Kontrollen. Vermeiden Sie einen mehrjährigen Versuch, das gesamte Unternehmen zu modellieren, bevor Wert geliefert wird. Testen Sie Quell‑Ausfall, Schema‑Änderungen, entzogenes Zugriffsrecht, späte Ereignisse und Disaster‑Recovery. Ein Data Fabric gelingt, wenn verteilte Daten leichter zu steuern und zu nutzen sind, ohne die betrieblichen Realitäten und Verantwortlichkeiten der Ursprungssysteme zu verwischen.
Praxisbeispiel: ein Customer‑Data‑Fabric
Ein Unternehmen verbindet Commerce, Support, Marketing und Produktdaten, lässt jedoch operative Systeme autoritativ. Ein gemeinsamer Katalog verknüpft Kunden-, Konto‑, Auftrags‑, Einwilligungs‑ und Interaktions‑Definitionen mit physischen Feldern. Change‑Data‑Capture speist gesteuerte Produkte, während Virtualisierung niedrige Volumen‑Lookups bedient und materialisierte Tabellen Analysen unterstützen. Identität, Herkunft, Qualität und Richtlinien werden implementiert, bevor eine KI‑Personalisierungsschicht die Daten nutzen darf.
Ein Widerruf der Einwilligung propagiert durch Warehouse‑Tabellen, Such‑Indizes, Embeddings und Aktivierungssysteme, mit Nachweis der Vollendung. Schema‑Verträge und Rekonsiliations‑Tests erkennen Quell‑Änderungen. Eigentümer veröffentlichen Erwartungen an Aktualität und Qualität, und Nutzungs‑Metadaten helfen, ungenutzte Kopien zu retireieren. Der Pilot misst Zugriffs‑Lead‑Time, Wiederverwendung vertrauenswürdiger Metriken, Vorfalls‑Lösung und Datenschutz‑Compliance. Das Fabric gilt als erfolgreich, weil eine bereichsübergreifende Journey zuverlässig und steuerbar wird – nicht weil ein Anbieter die größte Anzahl an Quellen verbunden hat.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluations‑Set vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungs‑Shift, Ausfall von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie Aufgaben‑Qualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototypen unterscheiden kann.
Vor dem Roll‑out weisen Sie Autorität für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Nutzen Sie ein gestuftes Roll‑out, bewahren Sie ein sicheres Fallback und verifizieren Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabe‑Qualität, Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für Reaktionen, prüfen Sie dann reale Evidenz nach dem Deployment, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Vorfalls‑Lern‑, Lösch‑ und Aufbewahrungs‑Prozeduren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Verschiebt ein Data Fabric alle Daten an einen Ort?
Nein. Es kann Daten koordinieren, die verteilt bleiben, und je nach Arbeitslast physische Bewegung oder Virtualisierung wählen.
Ist ein Data Fabric dasselbe wie ein Data Mesh?
Nein. Das Fabric beschreibt hauptsächlich eine aktivierende Architektur und Automatisierung; das Mesh beschreibt hauptsächlich dezentrale Domänen‑Eigentümerschaft und Daten‑Produkt‑Verantwortlichkeiten. Sie können koexistieren.
Primärreferenzen











