
Grundlagen der KI
Was ist TinyML? Maschinelles Lernen auf Mikrocontrollern

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
TinyML ermöglicht das Durchführen von Machine‑Learning‑Inference auf stark eingeschränkten Geräten wie Mikrocontrollern, kleinen Digital‑Signal‑Prozessoren und energiearmen Sensoren. Diese Systeme verfügen möglicherweise nur über Kilobytes oder Megabytes Speicher, strenge Energiebudgets, keine permanente Netzwerkverbindung und Echtzeit‑Fristen.
Der Nutzen besteht nicht nur in einem kleineren Modell. Die Verarbeitung in Nähe des Sensors kann Latenz, Bandbreite und die Offenlegung Rohdaten reduzieren und gleichzeitig Produkte ermöglichen, die über lange Zeiträume mit Batterien oder Energiegewinnung betrieben werden.
Wesentliche Erkenntnisse
- TinyML wird durch das gesamte Hardware‑ und Softwarebudget definiert, nicht durch eine einzelne Modellgrößen‑Schwelle.
- Quantisierung, kompakte Architekturen, optimierte Kernel und sorgfältiges Puffer‑Management ermöglichen die Bereitstellung.
- Inference auf dem Gerät kann die Privatsphäre verbessern, doch sichere Updates und Daten‑Governance bleiben wichtig.
- Benchmark‑Genauigkeit zusammen mit Latenz, Spitzen‑Speicher, Energieverbrauch, Duty‑Cycle und Robustheit.
Der TinyML‑Stack
Ein Sensor erfasst Audio, Bewegung, Vibration, Bildmaterial oder ein anderes Signal. Die Firmware verarbeitet es zu Merkmalen oder Tensoren; ein kompaktes Modell läuft in einer eingebetteten Laufzeitumgebung; die Anwendungslogik entscheidet, ob ein größeres System geweckt oder lokal agiert wird.
Dies ist eine eingeschränkte Form von edge AI. Die Hardware kann einen MCU, Speicher, Sensor‑Schnittstellen und manchmal einen neuronalen Beschleuniger umfassen. Jeder Puffer, Operator und jede Kopie konkurrieren um begrenzte Ressourcen.
Modell anpassen
Quantisierung ersetzt hochpräzise Werte durch kleinere Ganzzahl‑Darstellungen. Pruning, Distillation, Feature‑Engineering und Architektursuche können Berechnungen oder Speicherbedarf reduzieren. Die Unterstützung von Operatoren in der Ziel‑Runtime begrenzt, welche Modelle praktikabel sind.
Das Training erfolgt häufig auf leistungsstärkerer Hardware, danach wird das Modell für das Gerät konvertiert und kompiliert. Transfer‑Learning kann den Datenbedarf senken, doch das endgültige Artefakt muss nach der Konvertierung evaluiert werden, da numerische Änderungen die Genauigkeit beeinflussen können.
Daten‑ und Umweltverschiebung
Laboraufnahmen spiegeln selten jedes Mikrofon, jede Montageposition, Temperatur, Vibrationsmuster, Akzent oder Hintergrundbedingungen wider. Sammeln Sie Daten von repräsentativen Geräten und Umgebungen, halten Sie Trainings‑ und Testquellen unabhängig und schließen Sie ‚keine der genannten‘‑Fälle ein.
Ein Fehlalarm kann Energie verschwenden oder den Nutzer stören; ein übersehenes Anomalie‑Ereignis kann kostspielig sein. Wählen Sie Schwellenwerte anhand der tatsächlichen Fehlkosten und überwachen Sie die Feld‑Performance mittels datenschutzfreundlicher Zusammenfassungen oder gestreuter Diagnosen, wo dies sinnvoll ist.
Gesamtes Gerät messen
Die Anzahl der Modell‑Operationen entspricht nicht der Produktleistung. Geben Sie Aufwach‑Frequenz, Vorverarbeitungszeit, Inferenz‑Latenz, Spitzen‑RAM, Flash‑Nutzung, durchschnittlichen und Spitzen‑Stromverbrauch, thermisches Verhalten und den Einfluss auf die Batterie unter einem expliziten Duty‑Cycle an.
Planen Sie signierte Firmware‑ und Modell‑Updates, Rollbacks, Geräte‑Identität und Reaktionen auf Schwachstellen. Tiny‑Geräte können über Jahre im Einsatz bleiben, daher ist Wartbarkeit ein Teil der Modellqualität. Cybersecurity-Kontrollen können nicht aufgeschoben werden, weil das Gerät klein ist.
Speicher‑ und Rechenbudgetierung
Flash speichert Firmware, Modell‑Gewichte und Konstanten; RAM hält Sensorspeicher, Zwischenergebnisse und den Laufzeit‑Zustand. Der Spitzen‑Speicherbedarf für Aktivierungen kann die Gewichtgröße überschreiten, besonders in frühen Faltungs‑Schichten. Speicher‑Planer wiederverwenden Puffer, deren Lebenszeiten sich nicht überschneiden, während Streaming‑Features das Speichern eines gesamten Signal‑Fensters vermeiden.
Die Operationszahl ist eine erste Schätzung, doch die Kernel‑Effizienz hängt von Tensor‑Form, Ausrichtung, Instruktionsunterstützung und Speicherzugriff ab. Eine depthwise‑Faltung kann die Rechenlast reduzieren, aber auf Hardware ohne optimierten Kernel schlecht laufen. Benchmarken Sie das kompilierte Modell auf dem Ziel‑Board, nicht nur in einem Desktop‑Profiler.
Duty‑Cycling dominiert viele Produkte. Der Sensor und MCU können schlafen, bei einem günstigen Trigger aufwachen, ein kleines Modell ausführen und ein Funkmodul oder einen größeren Prozessor nur bei Bedarf aktivieren. Messen Sie den gesamten Duty‑Cycle, einschließlich Sensor, Konvertierung, Vorverarbeitung, Aufwachen, Inferenz, Kommunikation und Leckstrom im Leerlauf.
Modellentwicklung und -konvertierung
Beginnen Sie mit den Bereitstellungs‑Constraints und sammeln Sie repräsentative Sensordaten. Die im Training verwendete Vorverarbeitung muss exakt der Fixed‑Point‑ oder Embedded‑Implementierung entsprechen. Unterschiede bei Abtastrate, Fensterung, Farbumwandlung, Normalisierung oder Feature‑Extraktion können dazu führen, dass ein Modell trotz erfolgreicher Konvertierung fehlschlägt.
Post‑Training‑Quantisierung kalibriert Bereiche anhand repräsentativer Stichproben; quantisierungs‑bewusstes Training simuliert während des Lernens niedrigere Präzision. Gewichts‑Skalen pro Kanal erhalten häufig die Konvolutions‑Qualität besser als eine einheitliche Skala. Nicht unterstützte Operationen können umgeschrieben, approximiert oder in ein langsameres Fallback verschoben werden, was jeweils eine neue Bewertung erfordert.
Kompression sollte hypothesenbasiert sein. Das Pruning unstrukturierter Gewichte beschleunigt einen dichten Embedded‑Kernel möglicherweise nicht; das Entfernen strukturierter Kanäle ist für die Hardware leichter nutzbar. Distillation überträgt das Verhalten eines größeren Lehrers, kann jedoch dessen Vorurteile und Fehler übernehmen. Vergleichen Sie mit Signal‑Processing‑ und Schwellenwert‑Baselines.
Anwendungen, Feldtests und Wartung
Typische TinyML‑Aufgaben umfassen Keyword‑Spotting, Wake‑Word‑Erkennung, Gestenerkennung, Vibrations‑Anomalie‑Erkennung, Belegungs‑Erkennung, akustische Ereignisse und einfache Bildverarbeitung. Das Modell kann als Gate fungieren statt als endgültige Entscheidung, wodurch Bandbreite gespart wird, während unsichere oder wichtige Fälle an ein leistungsfähigeres System weitergeleitet werden.
Feldtests sollten die Gerätestoleranzen, Sensoralterung, Montage, Batteriezustand, Temperatur, Wetter, Nutzer und Hintergrundinterferenzen abdecken. Verfolgen Sie Fehlalarme pro Stunde oder verpasste Ereignisse pro Betriebszyklus, nicht nur die ausgeglichene Test‑Genauigkeit. Ein im Labor gewählter Schwellenwert kann eine produktspezifische Kalibrierung erfordern.
Planen Sie signierte Over‑The‑Air‑Updates, Rollbacks, Telemetrie der Modell‑Versionen und lange Support‑Zeiträume. Wenn Updates unmöglich sind, verwenden Sie konservative Modelle und dokumentieren Sie den erwarteten Umweltdrift. Die Stilllegung muss Geräte‑Zugangsdaten widerrufen und gespeicherte Daten adressieren, nicht nur den Verkauf des Produkts einstellen.
Praktisches Beispiel: ein TinyML‑Vibrationsmonitor
Ein kleiner Beschleunigungssensor an einem Motor erfasst Vibrationen bei normalen Lasten und bekannten Fehlbedingungen. Das Gerät segmentiert das Signal, entfernt den Offset, berechnet kompakte Zeit‑ oder Frequenz‑Domain‑Features und führt einen Anomalie‑Detektor oder Klassifikator aus. Die Abtastrate muss relevante Lager‑ und Wellenfrequenzen erfassen, ohne Speicher oder Energie zu überlasten. Labels sollten aus verifizierten Inspektionen stammen, nicht nur aus einem Alarm, der selbst fehlerhaft sein kann.
Das Training erfolgt auf einer Workstation, gefolgt von Quantisierung, Konvertierung und Kompilierung für den Ziel‑Mikrocontroller. Messen Sie Modell‑Flash, Spitzen‑RAM, Ausführungszeit, Energieverbrauch und Genauigkeit auf dem physischen Gerät. Ganzzahl‑Arithmetik und die Verfügbarkeit von Operatoren können die Ausgaben des Trainingsmodells verändern. Testen Sie Sensor‑Orientierung, Montage, Temperatur, Spannung, Bauteil‑Variationen und reale Hintergrundvibrationen, nicht nur kuratierte Labor‑Dateien.
Das bereitgestellte Gerät benötigt Kalibrierung, sichere Firmware‑Updates, Versionsberichte, ausfallsichere Verhaltensweisen und einen Plan für Drift. Es kann nur einen Gesundheits‑Score oder ausgewählte Features übertragen, um Energie zu sparen und Rohdaten zu schützen, doch lokale Fehlalarme verursachen weiterhin Wartungskosten. Verwenden Sie einen gestuften Schwellenwert, verlangen Sie Persistenz und kombinieren Sie Modell‑Beweise mit dem Betriebszustand. TinyML ist am wertvollsten, wenn lokale Latenz, Privatsphäre, Konnektivität oder Energie‑Constraints seine ingenieurtechnischen Grenzen rechtfertigen.
Produktions‑Tests sollten die Wiederherstellung nach einem Power‑Cycle, Clock‑Drift, Sensor‑Trennungen, beschädigte Eingaben, Speicher‑Erschöpfung und unterbrochene Updates umfassen. Definieren Sie, was geschieht, wenn das Modell nicht laufen kann oder das Vertrauen zusammenbricht: ein sicherer Standard, ein expliziter Fehlermelder oder eine konventionelle Regel kann einer stillen Schätzung vorzuziehen sein. Verfolgen Sie die Hardware‑ und Firmware‑Versionen der Flotte, sodass ein neu beobachteter Fehler einer Geräte‑Revision, Umgebung oder Modell‑Veröffentlichung zugeordnet werden kann.
Praktische Implementierungs‑Checkliste
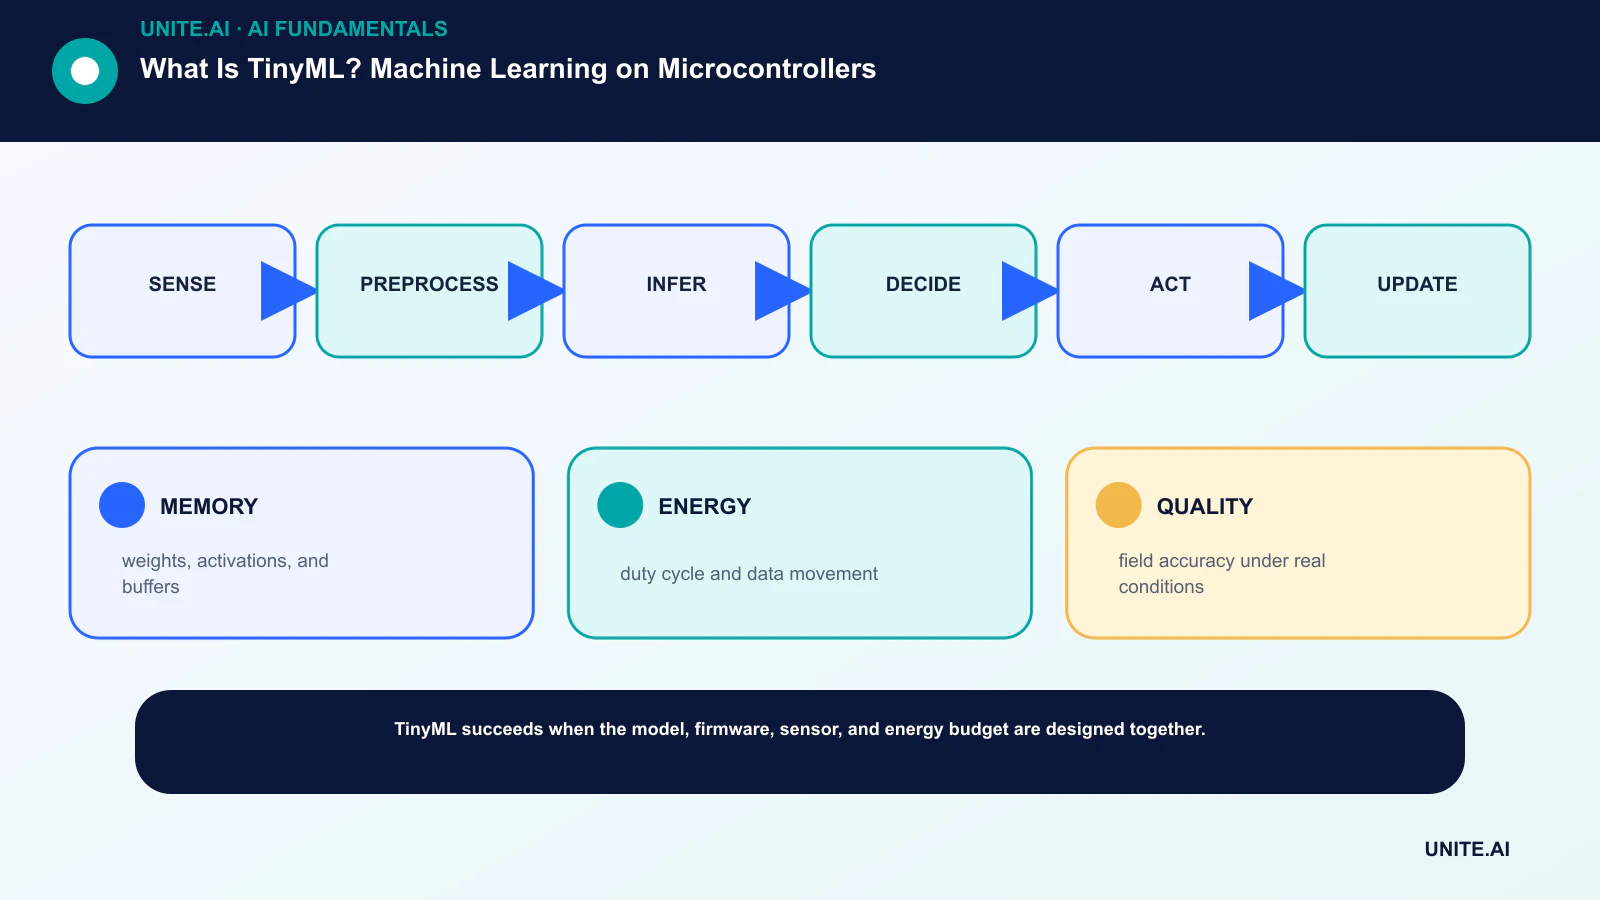
Verwandeln Sie das Konzept in einen abgegrenzten, testbaren Workflow: erfassen → vorverarbeiten → inferieren → entscheiden → handeln → aktualisieren. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie die Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, setzen Sie Akzeptanz‑ und Abbruchkriterien, testen Sie repräsentative Fehlfunktionen und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Readiness‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Abhängigkeits‑Fehler und Fehlgebrauch; bewahren Sie die Beweise und offenen Risiken. Definieren Sie, wer die Freigabe genehmigen, einen Schwellenwert ändern, ein Ergebnis überschreiben oder den Betrieb stoppen kann. Überprüfen Sie die Entscheidung erneut, sobald reale Daten vorliegen, da ein technisch erfolgreicher Pilot nicht automatisch eine zuverlässige Leistung im größeren Maßstab garantiert.
- MEMORY: Gewichte, Aktivierungen und Puffer.
- ENERGY: Duty‑Cycle und Datenbewegung.
- QUALITY: Feld‑Genauigkeit unter realen Bedingungen.
Häufig gestellte Fragen
Ist TinyML dasselbe wie Mobile AI?
Nicht ganz. Mobile Geräte sind Edge‑Systeme mit vergleichsweise großen Prozessoren und viel Speicher. TinyML konzentriert sich auf deutlich engere eingebettete und Mikrocontroller‑Klassen‑Constraints.
Können TinyML‑Modelle auf dem Gerät lernen?
Die meisten Deployments werden extern trainiert und führen Inferenz auf dem Gerät aus. Eine begrenzte Anpassung ist möglich, doch Speicher, Energie, Stabilität, Privatsphäre und Rollback erschweren das Training direkt auf dem Gerät.
Primärreferenzen












