
Grundlagen der KI
Was ist Albumentations? Bildaugmentation für Computer Vision

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
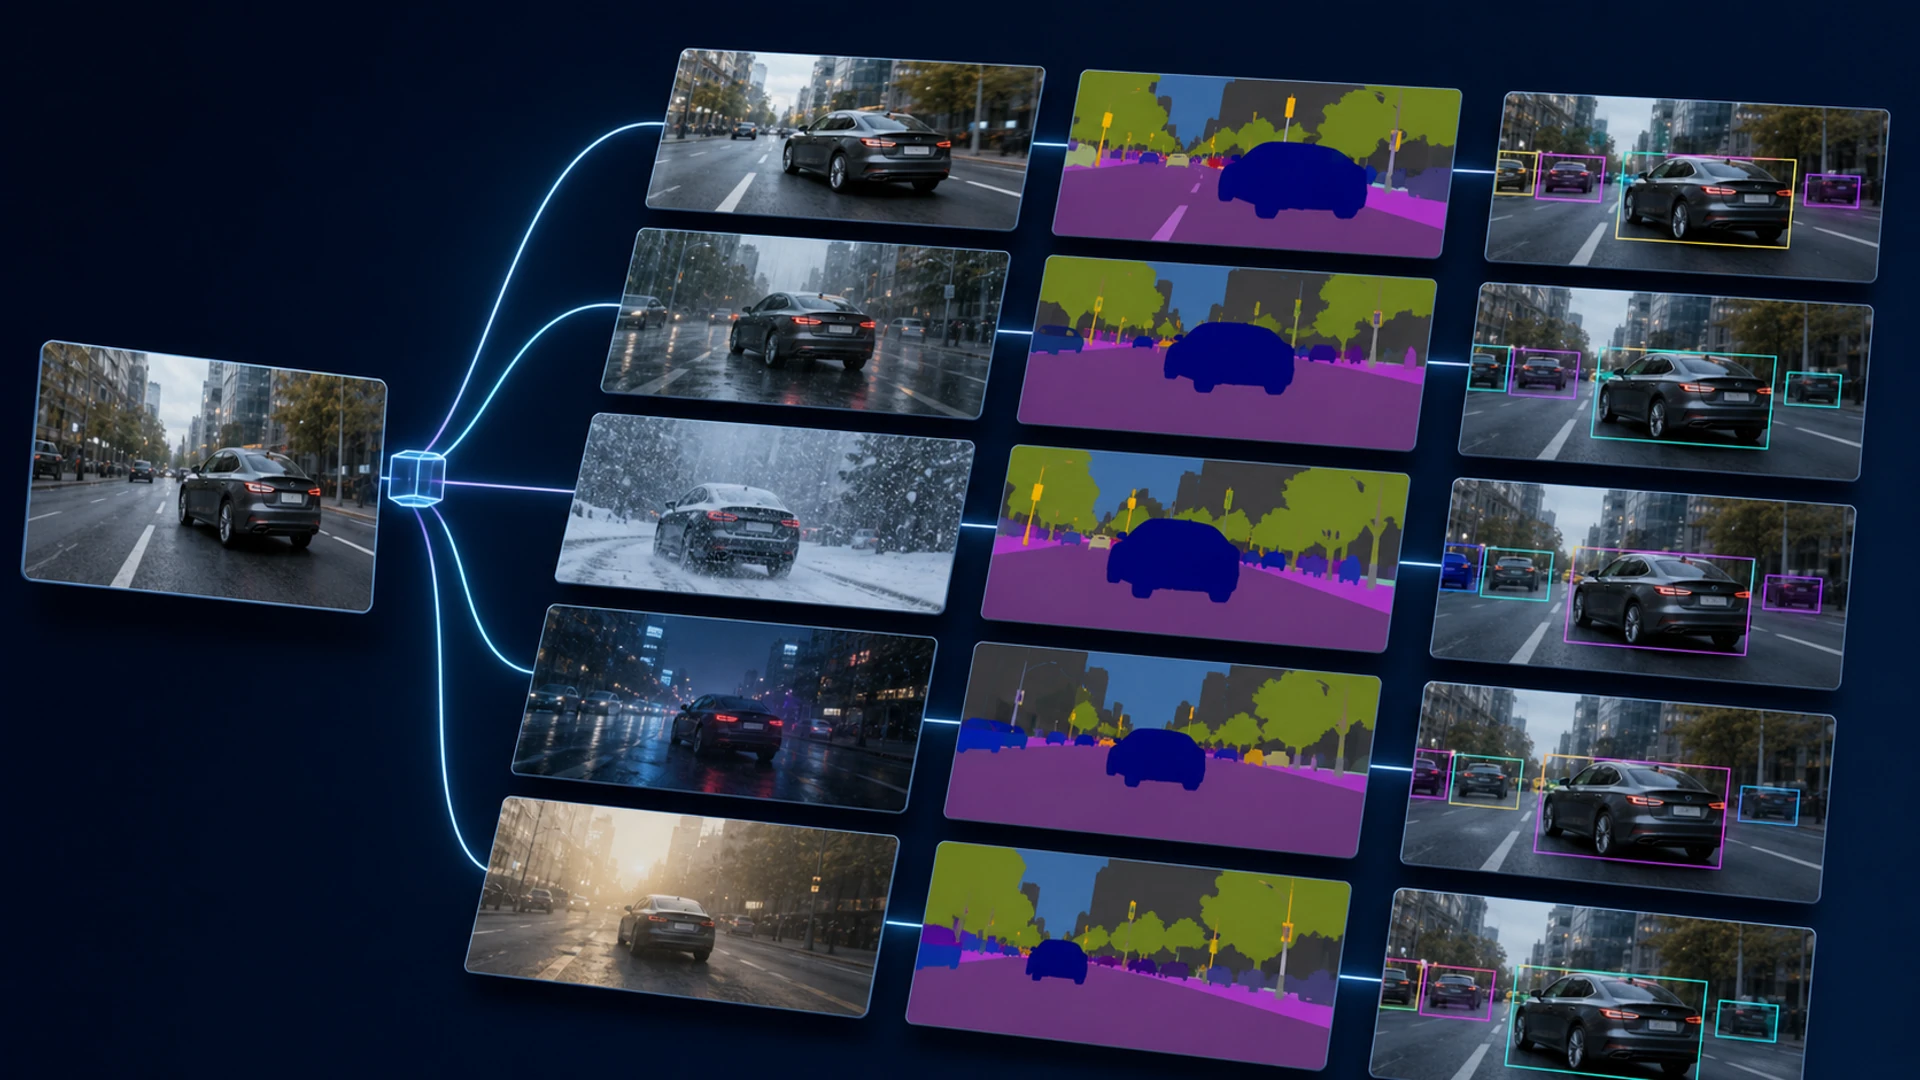
Albumentations ist eine Open‑Source‑Python‑Bibliothek für Bildaugmentation. Sie wendet zufällige geometrische und photometrische Transformationen an, während verwandte Ziele – wie Segmentierungs‑Masken, Begrenzungs‑Boxen und Schlüsselpunkte – mit dem Bild ausgerichtet bleiben.
Augmentation ist eine Annahme über Invarianz: Sie teilt einem Modell mit, dass ausgewählte Änderungen das Aufgabenlabel nicht verändern dürfen. Eine schnelle Bibliothek erleichtert Experimente, doch nur Fachwissen und Validierung können bestimmen, ob eine Transformation zulässig ist.
Wesentliche Erkenntnisse
- Stelle probabilistische Transformationen zu einer reproduzierbaren Trainingspipeline zusammen.
- Transformiere Bilder und räumliche Ziele gemeinsam; prüfe Box‑ und Schlüsselpunkt‑Konventionen explizit.
- Wende zufällige Augmentation auf Trainingsdaten an, nicht auf die unveränderte Validierungs‑ oder Testverteilung.
- Miss Klassen‑ und Untergruppen‑Effekte, da stärkere Augmentation in einem Fall helfen und in einem anderen schaden kann.
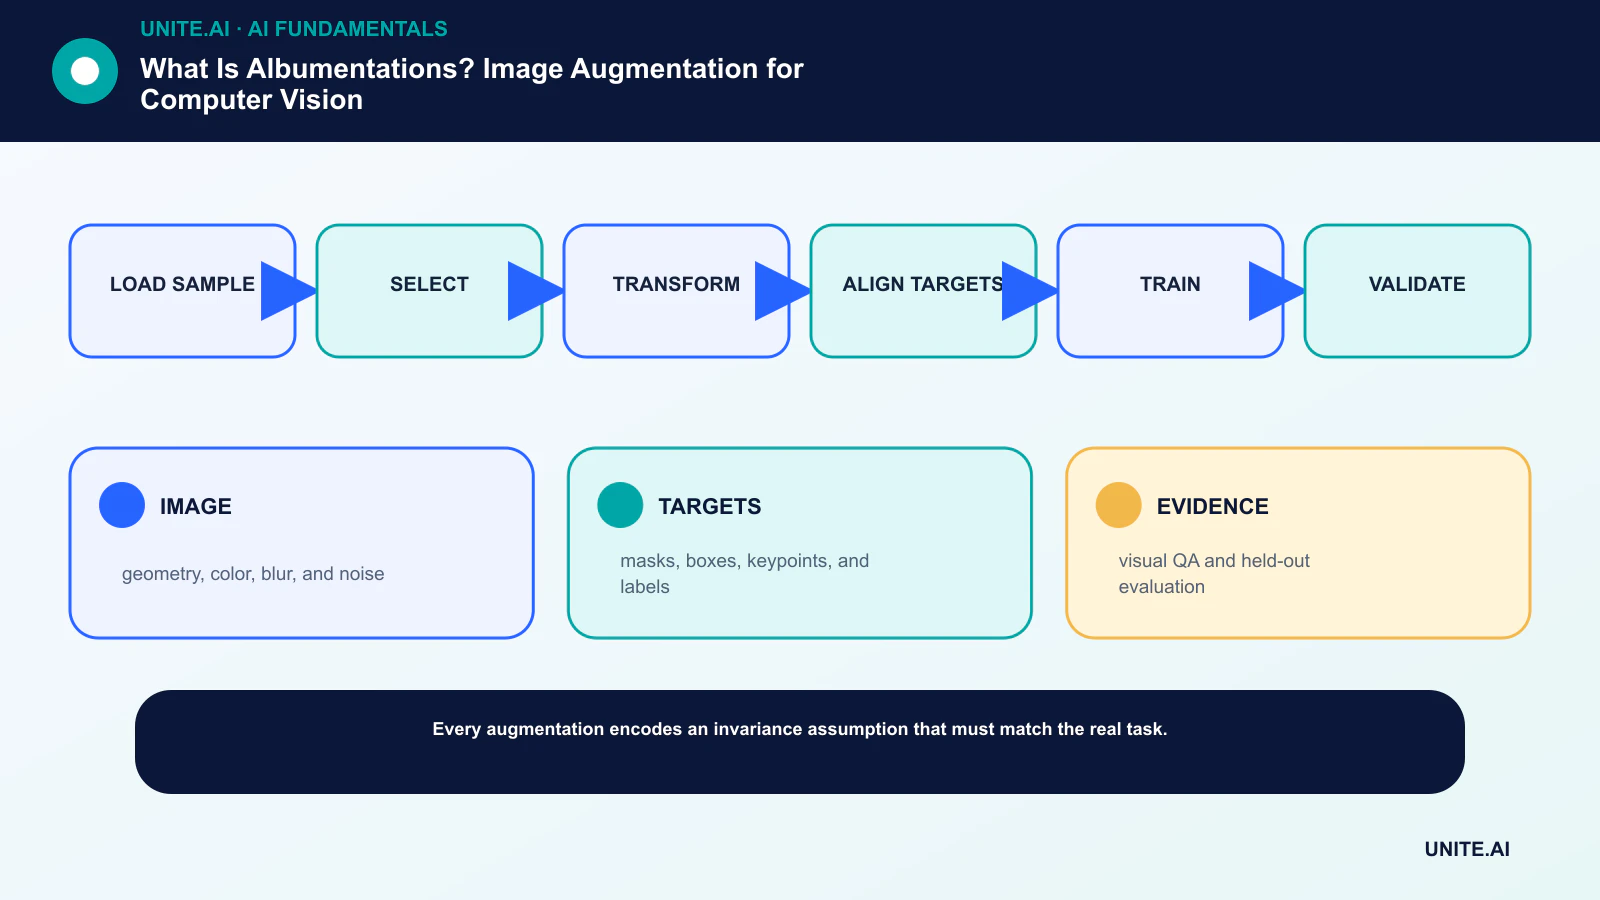
Wie eine Albumentations‑Pipeline funktioniert
Eine Pipeline erhält ein Bild und benannte Ziele, wählt Transformationen gemäß ihrer Wahrscheinlichkeiten aus und gibt ein Wörterbuch mit aktualisierten Ausgaben zurück. Geometrische Transformationen können zuschneiden, rotieren, spiegeln oder verzerren; photometrische Transformationen können Farbe, Kontrast, Unschärfe oder Rauschen verändern.
Die Bibliothek lässt sich in Trainings‑Stacks integrieren, bleibt dabei aber auf Augmentation fokussiert. Für Computer Vision ermöglicht diese Trennung, Daten‑Richtlinien unabhängig vom Modell‑Framework zu benchmarken.
Behalte Labels geometrisch korrekt
Ein Zuschnitt, der ein Bild verändert, muss auch die zugehörige Maske zuschneiden und betroffene Boxen sowie Schlüsselpunkte aktualisieren oder entfernen. Konfiguriere das Koordinatenformat, die Beschriftungsfelder, minimale Sichtbarkeit, Clipping‑ und Filterregeln und visualisiere anschließend die Batches vor dem Training.
Die Interpolation variiert je nach Ziel: Ein Bild kann bilineare Interpolation verwenden, während eine Klassen‑Maske in der Regel nearest‑neighbor‑Interpolation benötigt, um das Erzeugen von Kategorienwerten zu vermeiden. Eine falsche Ziel‑Handhabung kann das Datenset stillschweigend beschädigen.
Wähle Transformationen aus der Einsatzwelt
Ein horizontaler Flip kann für Wildtier‑Fotos gültig sein, jedoch für Text, Verkehrsschilder, medizinische Lateralisierung oder asymmetrische Geräte ungeeignet. Farbänderungen können die Robustheit gegenüber Beleuchtung erhöhen, aber ein diagnostisches Merkmal entfernen, wenn die Farbe eine Bedeutung trägt.
Beginne mit plausibler Störungs‑Variation, füge jeweils eine Familie hinzu und prüfe schwierige Beispiele. Verknüpfe Entscheidungen mit Overfitting-Hypothesen, anstatt anzunehmen, dass mehr synthetische Vielfalt immer besser ist.
Reproduzierbarkeit und Evaluation
Protokolliere Bibliotheksversion, Pipeline‑Konfiguration, Wahrscheinlichkeiten, Zufalls‑Seed‑Strategie, Vorverarbeitungsreihenfolge und Normalisierung. Zufälligkeit sollte die Trainingsbeispiele variieren, während Experimente auf Lauf‑Ebene reproduzierbar bleiben.
Halte Validierungs‑ und Testbilder repräsentativ und unverändert, abgesehen von deterministischer Vorverarbeitung. Vergleiche Genauigkeit, Kalibrierung, Klassen‑Fehler und Robustheit. Verwirrungsmatrizen können aufzeigen, wann eine Augmentation den Fehler verschiebt, anstatt ihn zu reduzieren.
Komposition, Wahrscheinlichkeiten und Ziele
Compose wendet eine Sequenz von Transformationen an, jede mit einer Wahrscheinlichkeit. OneOf‑ oder SomeOf‑Konstrukte wählen zwischen Alternativen, und verschachtelte Wahrscheinlichkeiten bestimmen die tatsächliche Verteilung. Die effektive Augmentations‑Policy ist daher ein stochastisches Programm; protokolliere sie und prüfe die gesampelten Häufigkeiten, anstatt jede Wahrscheinlichkeit isoliert zu betrachten.
Zusätzliche Ziele ermöglichen mehreren Bildern oder Masken, Geometrie zu teilen, was für Stereo‑Paare, Vor‑und‑Nach‑Aufnahmen oder mehrere Annotationen nützlich ist. Die Unterstützung von Begrenzungs‑Boxen erfordert ein deklariertes Format wie Pascal VOC, COCO, YOLO oder Albumentations‑Koordinaten. Schlüsselpunkt‑Formate können Winkel oder Skalierung enthalten, und Transformationen müssen diese Semantik bewahren.
Zuschneide‑Operationen können jedes Ziel entfernen. Entscheide, ob du neu sampelst, ein Hintergrund‑Beispiel behältst oder es filterst, da jede Wahl die Klassenverteilung ändert. Erkennungs‑ und Segmentierungs‑Pipelines sollten verworfene Boxen, sichtbare Anteile und leere Proben protokollieren, um stillschweigende Beschriftungs‑Schäden aufzudecken.
Policy‑Design nach Aufgabe
Bei der Klassifikation sind Zuschnitte, Farbänderungen, Unschärfe und Verdeckung oft tolerierbar, solange die Klasse sichtbar bleibt. Die Erkennung benötigt Objekte und Boxen, die gemeinsam transformiert werden. Segmentierung erfordert exakte Masken‑Geometrie. Pose‑Estimation muss Schlüsselpunkte bewahren und kann nach einem Flip Links‑Rechts‑Label‑Tauschen erfordern.
Medizinische Bildgebung kann Flips, aggressive Farbänderungen oder Interpolation, die quantitative Intensität verändert, verbieten. Fernerkundung muss Orientierung, Jahreszeit, Sensorspektren und geospatiale Skala berücksichtigen. Dokumentenanalyse muss Lesbarkeit und Layout erhalten. Das Fachgebiet definiert die Invarianz; die Bibliothek führt sie lediglich aus.
Mischmethoden wie MixUp, CutMix, Mosaic oder Copy‑Paste erzeugen zusammengesetzte Labels und können im Data‑Loader oder Framework stattfinden, nicht in Albumentations. Ihre Wechselwirkung mit Basis‑Transformationen, Normalisierung und Batching sollte getestet werden. Starke Policies können die Konvergenz verlangsamen oder die Kalibrierung ändern, selbst wenn die End‑Genauigkeit steigt.
Performance, Debugging und Versuchsdesign
Augmentation läuft auf der CPU, sofern kein anderer Pfad verwendet wird. Miss den Durchsatz des Data‑Loaders, die Anzahl der Worker, Dekodierkosten, Speicher‑Kopien und GPU‑Leerlaufzeit. Schnellere Transformationen sind nur dann wertvoll, wenn sie die Semantik nicht verändern. Cache unveränderliche Dekodier‑ oder Vorverarbeitungs‑Stufen, wenn Speicher und Reproduzierbarkeit dies zulassen.
Visualisiere Raster aus Original‑ und transformierten Stichproben mit allen Ziel‑Overlays. Ergänze automatisierte Tests für Koordinaten‑Rundwege, Maskenwerte, Form, Datentyp und deterministisches Replay. Setze Seeds im richtigen Geltungsbereich; identische Augmentation über alle Worker hinweg kann unbeabsichtigt die Vielfalt reduzieren.
Führe Ablationsstudien gegen einen festen Basis‑Fall durch: keine Augmentation, plausible Basis‑Transformationen, dann stärkere Policies. Wiederhole Seeds und berichte die Varianz. Evaluieren Sie saubere Daten, relevante Korruptionen und Untergruppen separat. Behalte eine Policy nur bei, wenn ihr Nutzen im Hold‑out‑Test besteht und die transformierten Bilder für Fachexperten glaubwürdig bleiben.
Entwurf und Validierung einer Albumentations‑Pipeline
Beginne mit den nach dem Einsatz erwarteten Variationen: Kamerawinkel, Zuschnitt, Skalierung, Beleuchtung, Kompression, Unschärfe, Wetter, Verdeckung und Sensors‑Rauschen. Wähle Transformationen, die das Label erhalten und zu diesen Mechanismen passen. Ein horizontaler Flip kann für Tiere gültig, für Text, Verkehrs‑Orientierung oder asymmetrische Anatomie jedoch ungültig sein. Starke Farbänderungen können diagnostisch relevante Informationen zerstören, selbst wenn das Bild noch plausibel wirkt.
Albumentations komponiert Transformationen und wendet räumliche Änderungen konsistent auf Bilder, Masken, Begrenzungs‑Boxen und Schlüsselpunkte an, wenn korrekt konfiguriert. Deklariere Koordinatenformate, minimale Sichtbarkeit, Interpolation und Masken‑Handhabung explizit. Visualisiere Hunderte augmentierter Stichproben mit überlagerten Annotationen, teste leere und Randfälle und speichere die zufälligen Parameter zur Fehlersuche. Teile Daten nach Subjekt oder Szene vor der Augmentation, damit verwandte Bilder nicht zwischen Training und Test lecken.
Vergleiche keine Augmentation, einfache Augmentation und die vorgeschlagene Policy auf einem unveränderten Testset und realistischen Stress‑Sets. Verfolge klassen‑spezifische Genauigkeit, Lokalisierung, Kalibrierung und Fehlbeispiele, nicht nur den Trainingsverlust. Übermäßige Augmentation kann die reale Verteilung unterfitten, während schwache Augmentation Shortcut‑Lernen fördern kann. Versioniere die Pipeline zusammen mit dem Modell, den Seed‑Evaluationsläufen und vermeide das Anwenden zufälliger Trainings‑Transformationen während Validierung oder Inferenz, es sei denn, Test‑Time‑Augmentation wird gezielt evaluiert.
Für Erkennung und Segmentierung prüfe das Clipping von Koordinaten, minimale Box‑Fläche, Sichtbarkeit von Schlüsselpunkten und die für kategoriale Masken verwendete Interpolation. Nearest‑neighbor‑Interpolation ist typischerweise für Klassen‑IDs erforderlich, während bilineare Interpolation ungültige Labels erzeugen kann. Profiliere zudem den Data‑Loader: aggressive Transformationen können die CPU‑Augmentation zum Engpass im Training machen. Cache nur Transformationen, die deterministisch sind und die beabsichtigte Zufälligkeit über Epochen und Worker hinweg bewahren.
Praktische Implementierungs‑Checkliste
Wandle das Konzept in einen abgegrenzten, testbaren Workflow um: Probe laden → auswählen → transformieren → Ziele ausrichten → trainieren → validieren. Benenne einen verantwortlichen Eigentümer, dokumentiere die Daten und Abhängigkeiten, etabliere eine einfache Basislinie, definiere Akzeptanz‑ und Stopp‑Kriterien, teste repräsentative Fehlfälle und lege Monitoring, Rollback und Review fest, bevor der Umfang erweitert wird. Protokolliere Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen nachvollziehen kann.
Vor dem Start führe ein dokumentiertes Readiness‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Teste Normalfälle, Randbedingungen, Abhängigkeits‑Fehler und Fehlgebrauch; bewahre die Beweise und offenen Risiken. Definiere, wer die Freigabe genehmigen, Schwellenwerte ändern, Ausgaben überschreiben oder den Betrieb stoppen darf. Überprüfe die Entscheidung erneut, sobald Real‑World‑Daten vorliegen, denn ein technisch erfolgreicher Pilot garantiert keine zuverlässige Leistung im größeren Maßstab.
- IMAGE: Geometrie, Farbe, Unschärfe und Rauschen.
- TARGETS: Masken, Boxen, Schlüsselpunkte und Labels.
- EVIDENCE: visuelle QA und Hold‑out‑Evaluation.
Häufig gestellte Fragen
Erzeugt Bildaugmentation neue Ground Truth?
Nein. Sie erzeugt transformierte Trainingsbeispiele unter der Annahme, dass die Labels gültig bleiben. Eine unrealistische oder falsch beschriftete Transformation führt zu Rauschen.
Sollten Validierungsbilder augmentiert werden?
Verwende deterministisches Resizing und Normalisierung, die das Modell benötigt, aber halte die Evaluationsverteilung unverändert. Test‑Time‑Augmentation ist eine separate Inferenz‑Methode und sollte explizit berichtet werden.
Primäre Referenzen












