
Grundlagen der KI
Was ist ein NPU? Neural Processing Units erklärt

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Ein Neural Processing Unit (NPU) ist ein spezialisierter Beschleuniger, der entwickelt wurde, um gängige neuronale Netzwerkoperationen effizient auszuführen. In Telefonen, PCs, Fahrzeugen, Kameras und eingebetteten Systemen kann er unterstützte KI‑Arbeitslasten mit geringerem Energieverbrauch ausführen oder CPU und GPU für andere Aufgaben freigeben.
NPU ist ein breit gefasster Branchenausdruck und keine einheitliche Architektur. Die Leistung hängt von unterstützten Operatoren, numerischen Formaten, Speicher, Compiler und Laufzeit, thermischen Grenzen sowie davon ab, wie viel einer Anwendung auf dem Beschleuniger verbleiben kann.
Wesentliche Erkenntnisse
- NPUs legen Wert auf Matrix-, Vektor- und Tensoroperationen mit hoher Datenwiederverwendung und geringem Stromverbrauch.
- Der Spitzen‑TOPS‑Wert ist kein End‑zu‑End‑Anwendungsbenchmark und kann eine bestimmte Präzision oder Sparsität voraussetzen.
- Ein Modell muss möglicherweise konvertiert, quantisiert, graphisch partitioniert und für nicht unterstützte Operationen ein Fallback eingerichtet werden.
- Vergleichen Sie Latenz, Durchsatz, Energieverbrauch, Speicher, Qualität, Datenschutz und Portabilität anhand der realen Arbeitslast.
Rollen von CPU, GPU und NPU
CPUs überzeugen bei allgemeinem Kontrollfluss und breiter Kompatibilität. GPUs bieten programmierbaren Parallel‑Durchsatz und umfangreiche Software‑Ökosysteme. NPUs spezialisieren sich auf wiederholte Tensoroperationen und können lokalen Speicher, Multiply‑Accumulate‑Arrays und für Inferenz optimierten Datenfluss enthalten.
Heterogene Systeme planen unterschiedliche Teile dort ein, wo sie am besten passen. Das ist wichtig für Edge‑KI, bei der anhaltender Energieverbrauch und Reaktionsfähigkeit wichtiger sein können als der Spitzen‑Durchsatz von Rechenzentren.
Modellkompilierung und -ausführung
Ein Framework‑Graph wird in eine Zwischendarstellung konvertiert, optimiert, bei Bedarf quantisiert und für unterstützte Operatoren kompiliert. Die Laufzeit kann den Graphen partitionieren, sodass nicht unterstützte Schichten auf CPU oder GPU ausgeführt werden.
Transfers zwischen Prozessoren können die Vorteile des Beschleunigers zunichte machen. Statische Formen, Layout, Präzision, Batch‑Verarbeitung und Speicherwiederverwendung beeinflussen die Leistung. Testen Sie das kompilierte Artefakt, da die Qualität von Deep‑Learning‑Modellen nach der Konvertierung variieren kann.
TOPS und Effizienzbehauptungen verstehen
TOPS gibt die Anzahl von Billionen Operationen pro Sekunde unter definierten Annahmen an. Anbieter können Multiplikation und Addition separat zählen, Low‑Bit‑Ganzzahl‑Präzision verwenden oder Sparsität annehmen. Eine höhere Zahl garantiert nicht geringere Latenz für ein bestimmtes Modell.
Messen Sie Kalt‑ und Warmstart, Latenz pro Anfrage, Durchsatz, Energieverbrauch, maximalen Speicher, thermisches Drosseln, unterstützte Kontext‑ oder Bildgrößen und den Anteil des beschleunigten Graphen. Verwenden Sie gleichwertige Genauigkeit und Software‑Versionen.
Kompromisse bei KI auf dem Gerät
Lokale Ausführung kann die Netzwerkabhängigkeit verringern und Rohdaten auf dem Gerät behalten, doch heruntergeladene Modelle, Protokolle, Backups und Cloud‑Fallbacks erzeugen weiterhin Datenflüsse. Eine sichere Modellbereitstellung und Plattform‑Updates bleiben erforderlich.
NPUs können Vision‑, Audio‑, Sprach‑ und Sensor‑Anwendungen unterstützen, einschließlich TinyML-naher Arbeitslasten. Entwickler sollten ein elegantes Fallback‑Design entwerfen und kommunizieren, wenn die Verarbeitung das Gerät verlässt.
NPU‑Architektur und unterstützte Operationen
Ein NPU beschleunigt Tensoroperationen durch den Einsatz von Arrays aus Multiply‑Accumulate‑Einheiten, lokalem Speicher, Datenfluss‑Scheduling und spezialisierten numerischen Formaten. Das Halten von Gewichten und Aktivierungen in Nähe der Berechnung reduziert teure Datenbewegungen. Reale Geräte unterscheiden sich in der Unterstützung von Operatoren, Speicherhierarchie, Präzision, Sparsität, Programmierbarkeit und der Art, wie Arbeit mit CPU und GPU geteilt wird.
Spitzenleistung wird häufig in TOPS beworben, doch TOPS gibt keine Auskunft über Präzision, Auslastung, Speichergrenzen, Operatorabdeckung oder End‑zu‑End‑Latenz. Zwei Prozessoren mit derselben Überschriftenzahl können bei demselben Modell unterschiedlich performen. Benchmarken Sie das kompilierte Modell, realistische Batch‑ und Sequenzgrößen, Vorverarbeitung, Transfers und den Energiemodus.
NPUs sind effektiv für unterstützte neuronale Arbeitslasten wie Vision, Sprache, Rauschunterdrückung, Hintergrundeffekte und kompakte Sprachmodelle. Nicht unterstützte Operatoren können auf CPU oder GPU ausweichen, was Transfers und unvorhersehbare Latenz erzeugt. Prüfen Sie Compiler‑Berichte und Laufzeit‑Traces, um die Platzierung zu bestätigen, anstatt anzunehmen, dass der gesamte Graph den Beschleuniger nutzt.
Modellkonvertierung, Quantisierung und Bereitstellung
Die Bereitstellung erfolgt in der Regel vom Trainings‑Framework über Export, Graph‑Optimierung, Quantisierung, herstellerspezifische Kompilierung bis hin zur Laufzeit‑Integration. Statische Formen und gängige Operatoren lassen sich am einfachsten beschleunigen. Dynamischer Kontrollfluss, benutzerdefinierte Kernel, große Zwischentensoren und nicht unterstützte Normalisierungs‑ oder Aufmerksamkeitsmuster können Graph‑Änderungen oder hybride Ausführung erfordern.
Ganzzahl‑ und niedrigpräzise Formate reduzieren Modellgröße, Bandbreite, Energieverbrauch und Latenz, jedoch müssen Kalibrierdaten reale Eingaben repräsentieren. Vergleichen Sie die Nach‑Training‑Quantisierung mit quantisierungsbewusstem Training, wenn die Qualität empfindlich ist. Bewerten Sie das Verhalten pro Klasse und im schlimmsten Fall, da die durchschnittliche Genauigkeit Degradierungen in seltenen oder sicherheitsrelevanten Fällen verbergen kann.
Inference auf dem Gerät verbessert Latenz, Offline‑Betrieb und Datenschutz, indem Datenübertragungen begrenzt werden, doch das Gerät benötigt weiterhin sichere Modelle, berechtigungsbewussten Datenzugriff und Aktualisierungsmechanismen. Schützen Sie Modelldateien, wo es angemessen ist, signieren Sie Updates, geben Sie Cloud‑Fallbacks offen und stellen Sie sicher, dass Telemetrie die Datenschutz‑Exposition, die die lokale Architektur reduzieren soll, nicht wieder einführt.
Leistungsbewertung und systembezogene Kompromisse
Messen Sie Kaltstart‑ und Dauer‑Latenz, Durchsatz, Energie pro Inferenz, Speicher, thermisches Verhalten, Genauigkeit und Batteriewirkung. Lange Tests zeigen Drosselungen, die kurze Benchmarks übersehen. Beziehen Sie Vor‑ und Nachverarbeitung ein, da Größenänderung, Tokenisierung, Dekodierung oder Datenkopien einen sonst schnellen Beschleuniger dominieren können.
Scheduling ist ein Systemproblem. Die CPU verwaltet die Anwendungslogik, die GPU kann rendern oder nicht unterstützte Schichten ausführen, und das NPU verarbeitet kompatible Graphen. Gleichzeitige Kamera‑, Audio‑, Anzeige‑ und KI‑Arbeitslasten konkurrieren um Speicherbandbreite und Energie. Testen Sie das komplette Nutzungsszenario statt eines isolierten Modells in einem Hersteller‑Tool.
Portabilität bleibt über Compiler und Laufzeiten hinweg begrenzt. Bevorzugen Sie standardisierte Modellrepräsentationen, wo sie funktionieren, isolieren Sie herstellerspezifischen Code hinter Schnittstellen, bewahren Sie Referenzausgaben und erhalten Sie die Geräte‑Testabdeckung. Wählen Sie Hardware basierend auf validierten Arbeitslasten, Software‑Support, Update‑Horizont und Gesamtsystemkosten – nicht nach einer einzelnen Beschleuniger‑Spezifikation.
Praktisches Beispiel: Bereitstellung eines Vision‑Modells auf einem NPU‑Laptop
Ein Team trainiert ein Segmentierungsmodell für Hintergrundeffekte, exportiert es in ein unterstütztes Austauschformat, ersetzt nicht unterstützte Operatoren und kalibriert die Ganzzahl‑Quantisierung mit repräsentativen Kameras, Beleuchtungen, Hauttönen, Kleidung und Hintergründen. Der herstellerspezifische Compiler meldet, welche Knoten auf dem NPU laufen und welche ausweichen. Das Team betrachtet jedes Fallback‑Ereignis als Systemkosten, da Tensor‑Transfers einen schnellen einzelnen Kernel dominieren können.
Benchmarking misst die Kameravorverarbeitung, Modellausführung, Compositing, Speicher, Kaltstart, Dauer‑Latenz, Bildstabilität, Energieverbrauch und thermisches Drosseln während eines echten Videoanrufs. Die Ergebnisse werden mit CPU‑ und GPU‑Pfade bei gleicher Ausgabequalität verglichen. Die Anwendung nutzt Fähigkeits‑Erkennung und ein getestetes Fallback, anstatt anzunehmen, dass der Beschleuniger existiert oder nach einem Treiber‑Update denselben Graphen unterstützt.
Release‑Tests umfassen Geräte‑Modelle, Betriebssystem‑ und Treiber‑Versionen, gleichzeitige Arbeitslasten, Batteriemodi und fehlerhafte Eingaben. Modellpakete werden signiert und versioniert; Telemetrie protokolliert Leistung und Fehler, ohne unnötige Videos zu sammeln. Das Produkt erklärt, wann die Verarbeitung auf dem Gerät bleibt und wann Cloud‑Funktionen genutzt werden. Das NPU verdient seinen Platz, indem es das Gesamterlebnis unter realistischen Einschränkungen verbessert, nicht indem es einen isolierten TOPS‑ oder Kernel‑Benchmark erreicht.
Praktische Implementierungs‑Checkliste
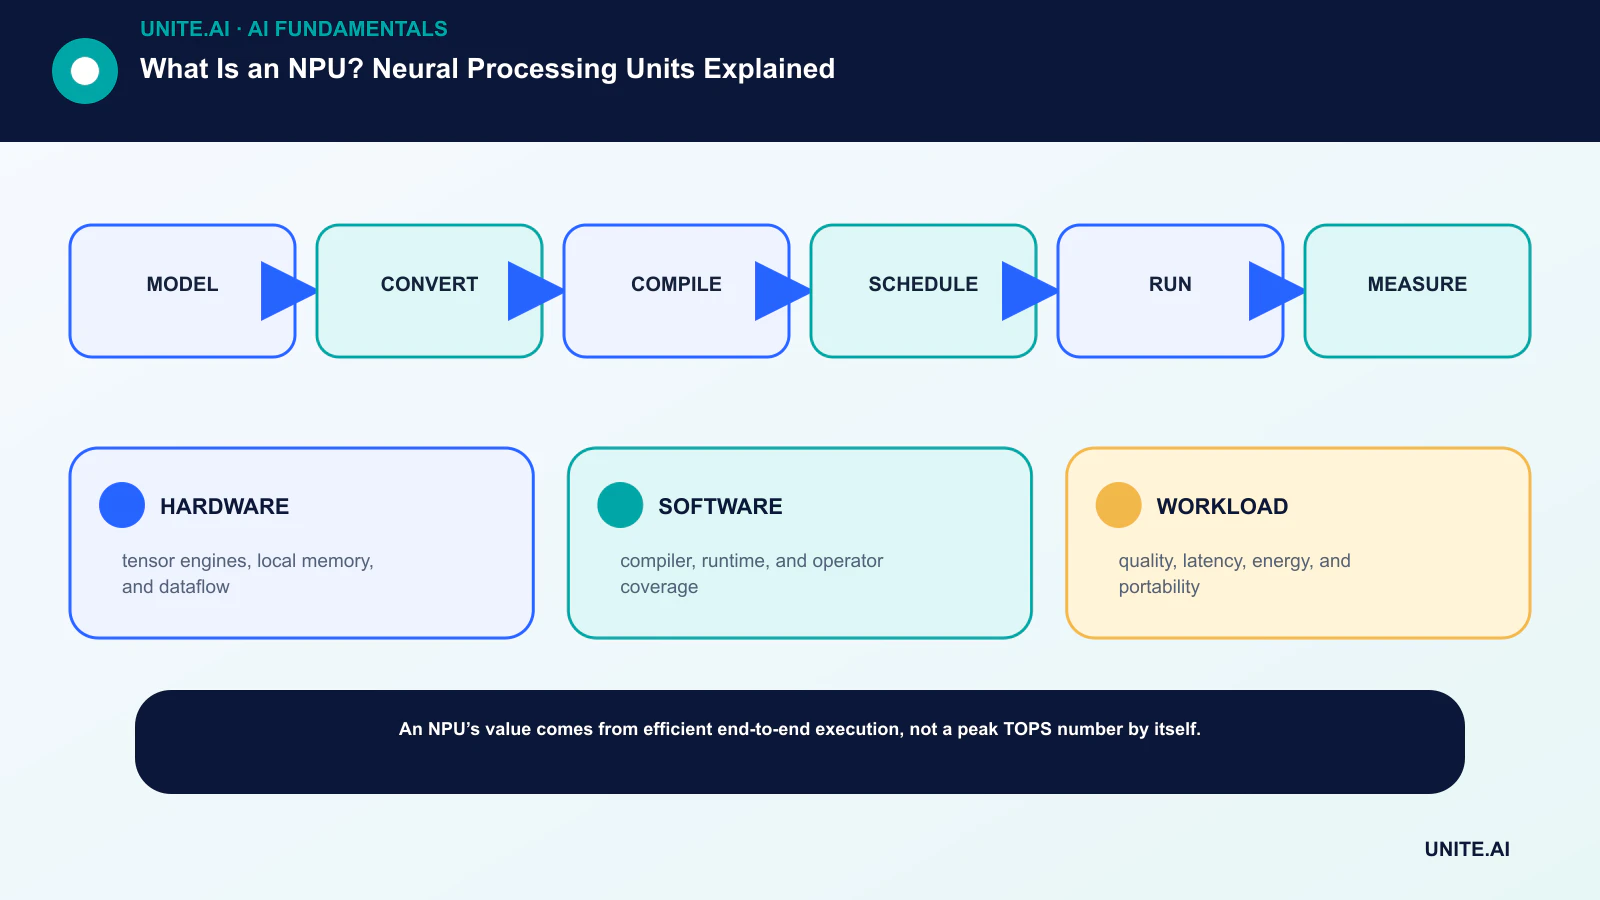
Verwandeln Sie das Konzept in einen abgegrenzten, testbaren Workflow: Modell → konvertieren → kompilieren → planen → ausführen → messen. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, setzen Sie Akzeptanz‑ und Abbruchkriterien, testen Sie repräsentative Fehlerszenarien und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und Änderungen nachvollziehen kann.
Führen Sie vor dem Start eine dokumentierte Bereitschafts‑Review mit den Personen durch, die das System bauen, betreiben, sichern und davon betroffen sind. Testen Sie Normalfälle, Grenzbedingungen, Abhängigkeits‑Fehler und Missbrauch; bewahren Sie die Beweise und offenen Risiken. Definieren Sie, wer die Veröffentlichung freigeben, Schwellenwerte ändern, Ausgaben überschreiben oder den Betrieb stoppen kann. Überarbeiten Sie die Entscheidung, sobald reale Daten vorliegen, da ein technisch erfolgreicher Pilot nicht automatisch zuverlässige Leistung im größeren Maßstab garantiert.
- HARDWARE: Tensor‑Engines, lokaler Speicher und Datenfluss.
- SOFTWARE: Compiler, Laufzeit und Operator‑Abdeckung.
- WORKLOAD: Qualität, Latenz, Energie und Portabilität.
Häufig gestellte Fragen
Ist ein NPU schneller als eine GPU?
Das hängt vom Modell, der Präzision, der Operatorunterstützung, der Batch‑Größe, dem Leistungs‑Limit und der Software ab. Ein NPU kann für eine unterstützte On‑Device‑Arbeitslast effizienter sein, während eine GPU andernorts schneller oder flexibler ist.
Behält ein NPU alle KI‑Daten privat?
Nein. Er ermöglicht lokale Verarbeitung, aber die Anwendung kann Daten oder Ausgaben weiterhin an Cloud‑Dienste senden. Der Datenschutz hängt von der gesamten Architektur und den Richtlinien ab.
Primäre Referenzen












