
Grundlagen der KI
Was ist generative KI?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Generative KI bezieht sich auf Modelle, die Muster in Daten erlernen und neuen Text, Bilder, Audio, Video, Code oder andere Darstellungen erzeugen, wenn sie anhand von Anweisungen oder Beispielen konditioniert werden. Die Ausgabe wird aus einem Wahrscheinlichkeitsmodell synthetisiert; sie wird nicht unverändert aus einer Datenbank abgerufen, obwohl Retrieval‑Werkzeuge externe Evidenz liefern können.
Verschiedene Modellfamilien generieren auf unterschiedliche Weise. Autoregressive Transformer sagen eine Sequenz Token für Token voraus, Diffusionsmodelle entrauschen ein Sample iterativ, und generative adversariale Netze lernen durch einen Wettstreit zwischen Generator und Diskriminator.
Wesentliche Erkenntnisse
- Generierung ist bedingtes Sampling aus einer erlernten Verteilung, nicht garantiertes faktisches Abrufen.
- Transformer, Diffusionsmodelle, GANs und Variationale Autoencoder setzen unterschiedliche Kompromisse.
- Retrieval und Werkzeuge können ein System verankern, aber deren Ausgaben und Berechtigungen müssen weiterhin validiert werden.
- Risikomanagement erstreckt sich über Daten, Modell, Schnittstelle, Bereitstellung, Überwachung und Herkunft von Inhalten.
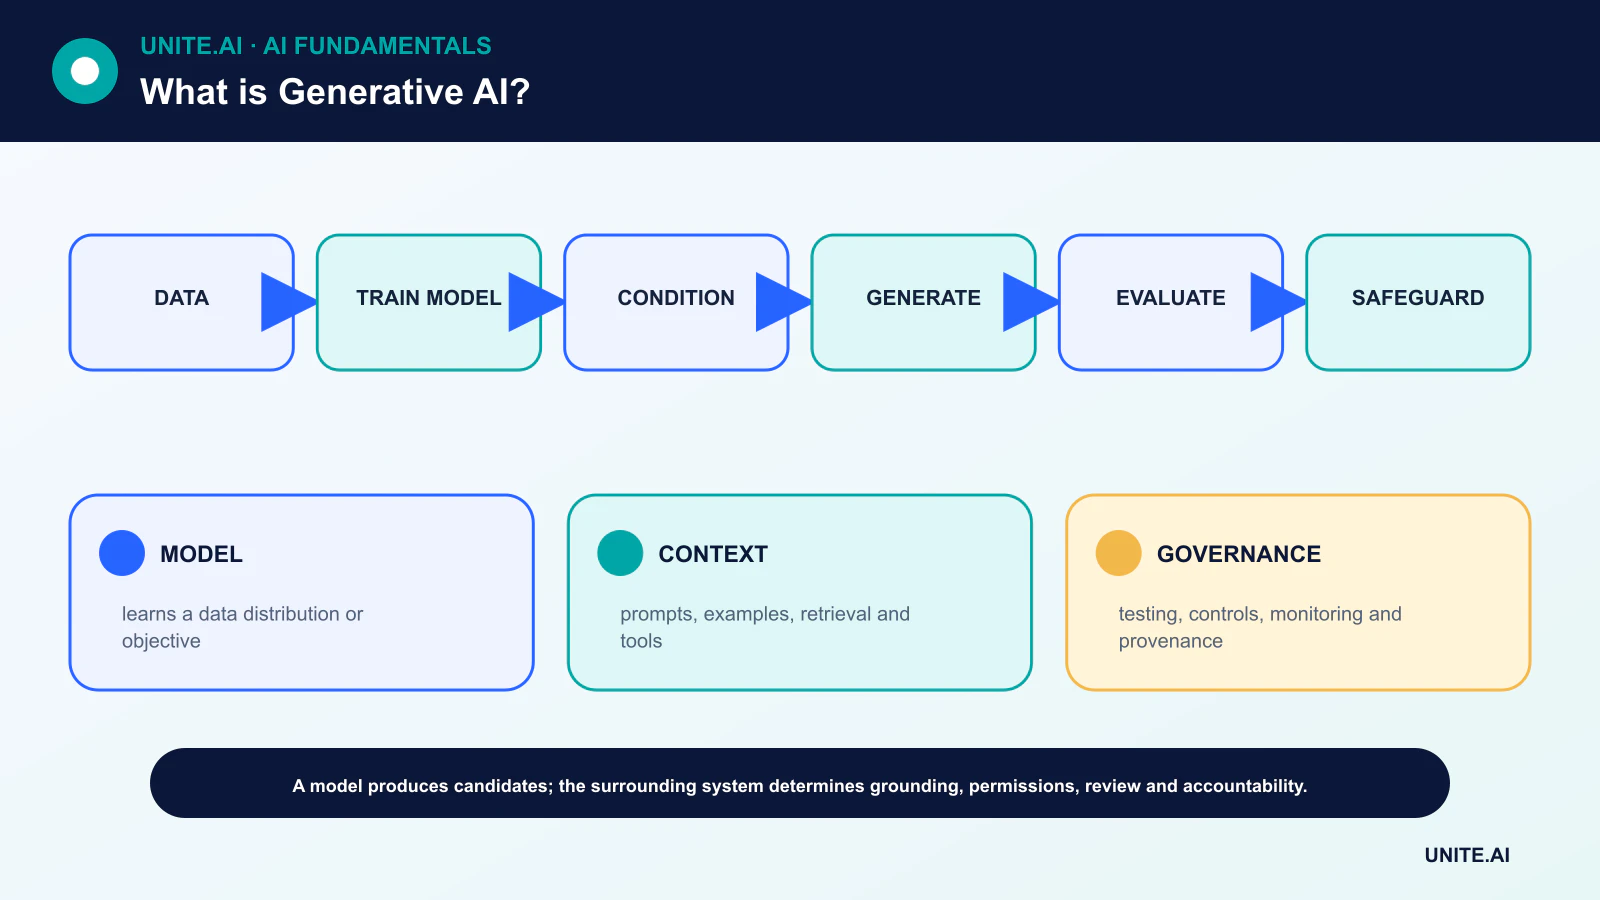
Wie generative Modelle lernen
Trainingsziele belohnen ein Modell dafür, Muster in Beispielen vorherzusagen oder zu rekonstruieren. Ein Sprachmodell schätzt das nächste Token; ein Diffusionsmodell lernt, einen Rauschprozess umzukehren; ein variationaler Autoencoder lernt eine strukturierte latente Verteilung und einen Decoder.
Dieses Training erzeugt statistische Generalisierung, kann jedoch auch Vorurteile reproduzieren, seltene Sequenzen memorisieren oder außerhalb der Datenverteilung versagen. Datensatzdokumentation, Duplikatentfernung, Datenschutzkontrollen und Hold‑out‑Evaluation sind daher vor der Bereitstellung wichtig.
Wichtige Architekturfamilien
Autoregressive Transformer dominieren Text und unterstützen multimodale Sequenzen. Diffusionsmodelle werden häufig für hochqualitative Bild‑ und Audio‑Generierung eingesetzt. GANs können scharfe Samples und steuerbare Bildsysteme erzeugen, sind jedoch schwer zu trainieren.
Variationale Autoencoder bieten latente Variablenmodellierung und effiziente Darstellungen, manchmal innerhalb größerer generativer Pipelines. Reale Produkte kombinieren häufig mehrere Modelle mit Retrieval, Filtern, Werkzeugen und deterministischem Code.
Konditionierung, Sampling und Steuerung
Ein Prompt, Klassenlabel, Bild, Audioclip oder strukturierter Datensatz kann die Generierung konditionieren. Sampling‑Parameter verändern Diversität und Determinismus. Eine niedrigere Temperatur kann Token‑Wahrscheinlichkeiten konzentrieren, macht jedoch eine falsche Antwort nicht wahr.
Steuerung verbessert sich, wenn das System explizite Schemata, eingeschränktes Decoding, Referenzmaterial und Validierung nutzt. Prompt‑Engineering ändert den Kontext; Feinabstimmung ändert Parameter; Retrieval liefert externe Informationen. Jeder Ansatz adressiert einen anderen Fehlermodus.
Bewertung ist anwendungsabhängig
Textsysteme benötigen möglicherweise Faktenhaftigkeit, Aufgabenerfüllung, Zitationsunterstützung, Toxizitäts‑ und Kalibrierungstests. Bild‑ oder Audiosysteme benötigen möglicherweise Treue, semantische Ausrichtung, Diversität, Identitätssicherheit und perceptuelle Überprüfung. Kombinieren Sie automatisierte Metriken mit repräsentativer menschlicher Bewertung.
Erstellen Sie ein versioniertes Evaluationsset, das gewöhnliche, seltene, adversarielle und politikrelevante Fälle umfasst. Verfolgen Sie Latenz, Kosten und Ablehnungsverhalten sowie die Ausgabequalität. Eine vom Ersteller ausgewählte Demo ist kein Beleg für Zuverlässigkeit auf Populationsebene.
Risiken, Schutzmaßnahmen und Herkunft
Wichtige Risiken umfassen Halluzinationen, Prompt‑Injection, schädliche Inhalte, Identitätsmissbrauch, unsichere Werkzeugnutzung, Datenschutzlecks, Urheberrechtsstreitigkeiten, Automatisierungsbias und undurchsichtige Lieferketten. Das Generative‑AI‑Profil von NIST organisiert Maßnahmen über Governance, Herkunft von Inhalten, Tests vor dem Einsatz und Offenlegung von Vorfällen.
Verwenden Sie Werkzeuge mit minimalen Rechten, Eingabe‑/Ausgabekontrollen, menschliche Überprüfung für folgenschwere Entscheidungen, Protokollierung, Rollback und Nutzer‑Reporting. Wasserzeichen oder Inhaltsnachweise können Signale hinzufügen, aber kein einzelner Detektor oder Hinweis etabliert die Wahrheit. Der breitere synthetische‑Medien-Workflow muss Kontext und Verantwortlichkeit bewahren.
Modellfamilien und Generierungsmechanismen
Generative‑KI‑Modelle schätzen oder lernen einen Prozess, der neuen Text, Bilder, Audio, Video, Code oder strukturierte Daten erzeugen kann. Autoregressive Modelle sagen das nächste Token oder Element voraus; Diffusionsmodelle lernen, einen Rauschprozess umzukehren; variationale Autoencoder lernen probabilistische latente Variablen; GANs trainieren einen Generator gegen einen Diskriminator. Multimodale Systeme verbinden Darstellungen über Medien hinweg. Die Ausgabe wird aus einer erlernten statistischen Struktur, konditioniert durch Prompts, Kontext, Werkzeuge oder andere Eingaben, gesampelt – nicht als garantierte Tatsache abgerufen.
Foundation‑Modelle werden auf breiten Daten vortrainiert und durch Prompting, Retrieval, Feinabstimmung, Präferenzoptimierung, Steuerungs‑Netzwerke oder aufgabenspezifische Heads angepasst. Tokenizer, Encoder, Decoder, latente Räume und Sampling‑Einstellungen prägen die Ergebnisse. Temperatur und Kandidatenfilterung tauschen Determinismus gegen Diversität aus. Längere Prompts liefern Kontext, können jedoch konfligieren, ablenken oder bösartige Anweisungen enthalten. Retrieval kann wechselndes Wissen verankern, während deterministischer Code exakte Berechnungen und Regeln handhaben sollte.
Bewertung, Herkunft und Rechte
Bewerten Sie nach Aufgabe: faktische Korrektheit und Zitation für Antworten, Ausführung und Sicherheit für Code, Treue und Diversität für Medien sowie menschliche Ergebnisse für kreative Unterstützung. Einschließlich Ablehnung, Kalibrierung, Latenz, Kosten, Sprachen, Barrierefreiheit und adversarielle Tests. Eine flüssige oder fotorealistische Ausgabe kann falsch sein. Bewahren Sie Modell, Prompt, Seed, Quell‑Evidenz, Werkzeugaufrufe und Nachbearbeitung für Reproduzierbarkeit auf. Trennen Sie die Qualität des Retrievals von der Generierung, sodass eine polierte Antwort fehlende Evidenz nicht verbergen kann.
Training und Ausgaben werfen Fragen zu Urheberrecht, Lizenz, Einwilligung, Datenschutz, Öffentlichkeit und Vertraulichkeit auf. Etablieren Sie Herkunft und erlaubte Nutzung für Eingabedaten; verhindern Sie, dass Nutzer Geheimnisse preisgeben; testen Sie Memorierung; und bieten Sie Melde‑ und Entfernungsprozesse an. Synthetische Medien sollten, wo möglich, dauerhafte Herkunft oder Offenlegung tragen, insbesondere wenn sie mit Evidenz verwechselt werden können. Verwenden Sie kein Abbild, keine Stimme und keinen Stil in einer Weise, die Rechte verletzt oder täuscht.
Bereitstellungssteuerungen
Behandeln Sie die Modellausgabe als nicht vertrauenswürdige Eingabe. Validieren Sie Schemata, bereinigen Sie Code und Dateien, isolieren Sie die Ausführung, autorisieren Sie jedes Werkzeug extern, begrenzen Sie Kosten und Rate und verlangen Sie Bestätigung für folgenschwere Aktionen. Überwachen Sie Fehlfunktionen, Missbrauch, Drift und Nutzerkorrekturen, mit Rollback und einem nicht‑generativen Fallback. Dokumentieren Sie beabsichtigte und verbotene Nutzung. Generative KI erweitert die Schnittstelle zum Erstellen und Transformieren von Informationen, doch Zuverlässigkeit und Verantwortlichkeit stammen aus den umgebenden Daten, der Evaluation, Sicherheit, Herkunft und dem menschlichen Entscheidungsprozess.
Praktisches Beispiel: ein generativer Produktbeschreibungs‑Assistent
Ein Einzelhändler lässt Redakteure Entwurfsbeschreibungen ausschließlich aus genehmigten Produkteigenschaften und Markenrichtlinien generieren. Der Prompt enthält strukturierte Fakten, während Retrieval die aktuelle Richtlinie liefert. Die Ausgabe muss einem Schema folgen und wird gegen Quellwerte validiert; nicht unterstützte Dimensionen, Sicherheitsbehauptungen oder Zertifizierungen führen zur Ablehnung. Die Bewertung umfasst faktische Genauigkeit, Stil, Duplizierung, mehrsprachige Qualität, Barrierefreiheit, Latenz und Redakteurskorrekturen, im Vergleich zu Vorlagen und manueller Erstellung.
Redakteure genehmigen jede Veröffentlichung und können Quellfelder einsehen. Das Modell hat keine Möglichkeit, Preis, Bestand oder die Veröffentlichung selbst zu ändern. Prompts und Produktdaten sind vor Injection geschützt, und vertrauliche Lieferantenhinweise werden ausgeschlossen. Das Monitoring verfolgt nicht unterstützte Behauptungen, Änderungen, Beschwerden, Kosten und Anbieter‑Versionen. Generierter Text wird mit Herkunft gespeichert. Das System spart nur dann Zeit beim Entwurf, wenn Korrekturen und Überprüfungen den Nutzen nicht aufheben und die Produktwahrheit weiterhin von autoritativen Daten gesteuert wird.
Implementierungsnachweise und betriebliche Bereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die beabsichtigten Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Feintuning. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Missbrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabengenauigkeit zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start weisen Sie die Zuständigkeit für Freigabe, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Verwenden Sie eine gestufte Einführung, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlfunktionen. Operative Telemetrie sollte die Eingabequalität, das Ausgabeverhalten, Modell‑ oder Regelversion, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und prüfen Sie dann Evidenz aus der Praxis nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Vorfalls‑Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist generative KI dasselbe wie ein großes Sprachmodell?
Nein. LLMs sind eine Klasse generativer Modelle. Generative KI umfasst zudem Bild‑, Audio‑, Video‑ und strukturierte‑Daten‑Systeme, die mit verschiedenen Architekturen gebaut werden.
Kopiert ein Modell seine Trainingsdaten?
Es synthetisiert in der Regel aus erlernten Mustern, aber Memorierung und nahezu‑Duplikation können auftreten. Datenschutz‑ und Herkunftsrisiken müssen bewertet werden, anstatt sie zu ignorieren.
Primärreferenzen












