Grundlagen der KI
Was ist ein Autoencoder?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
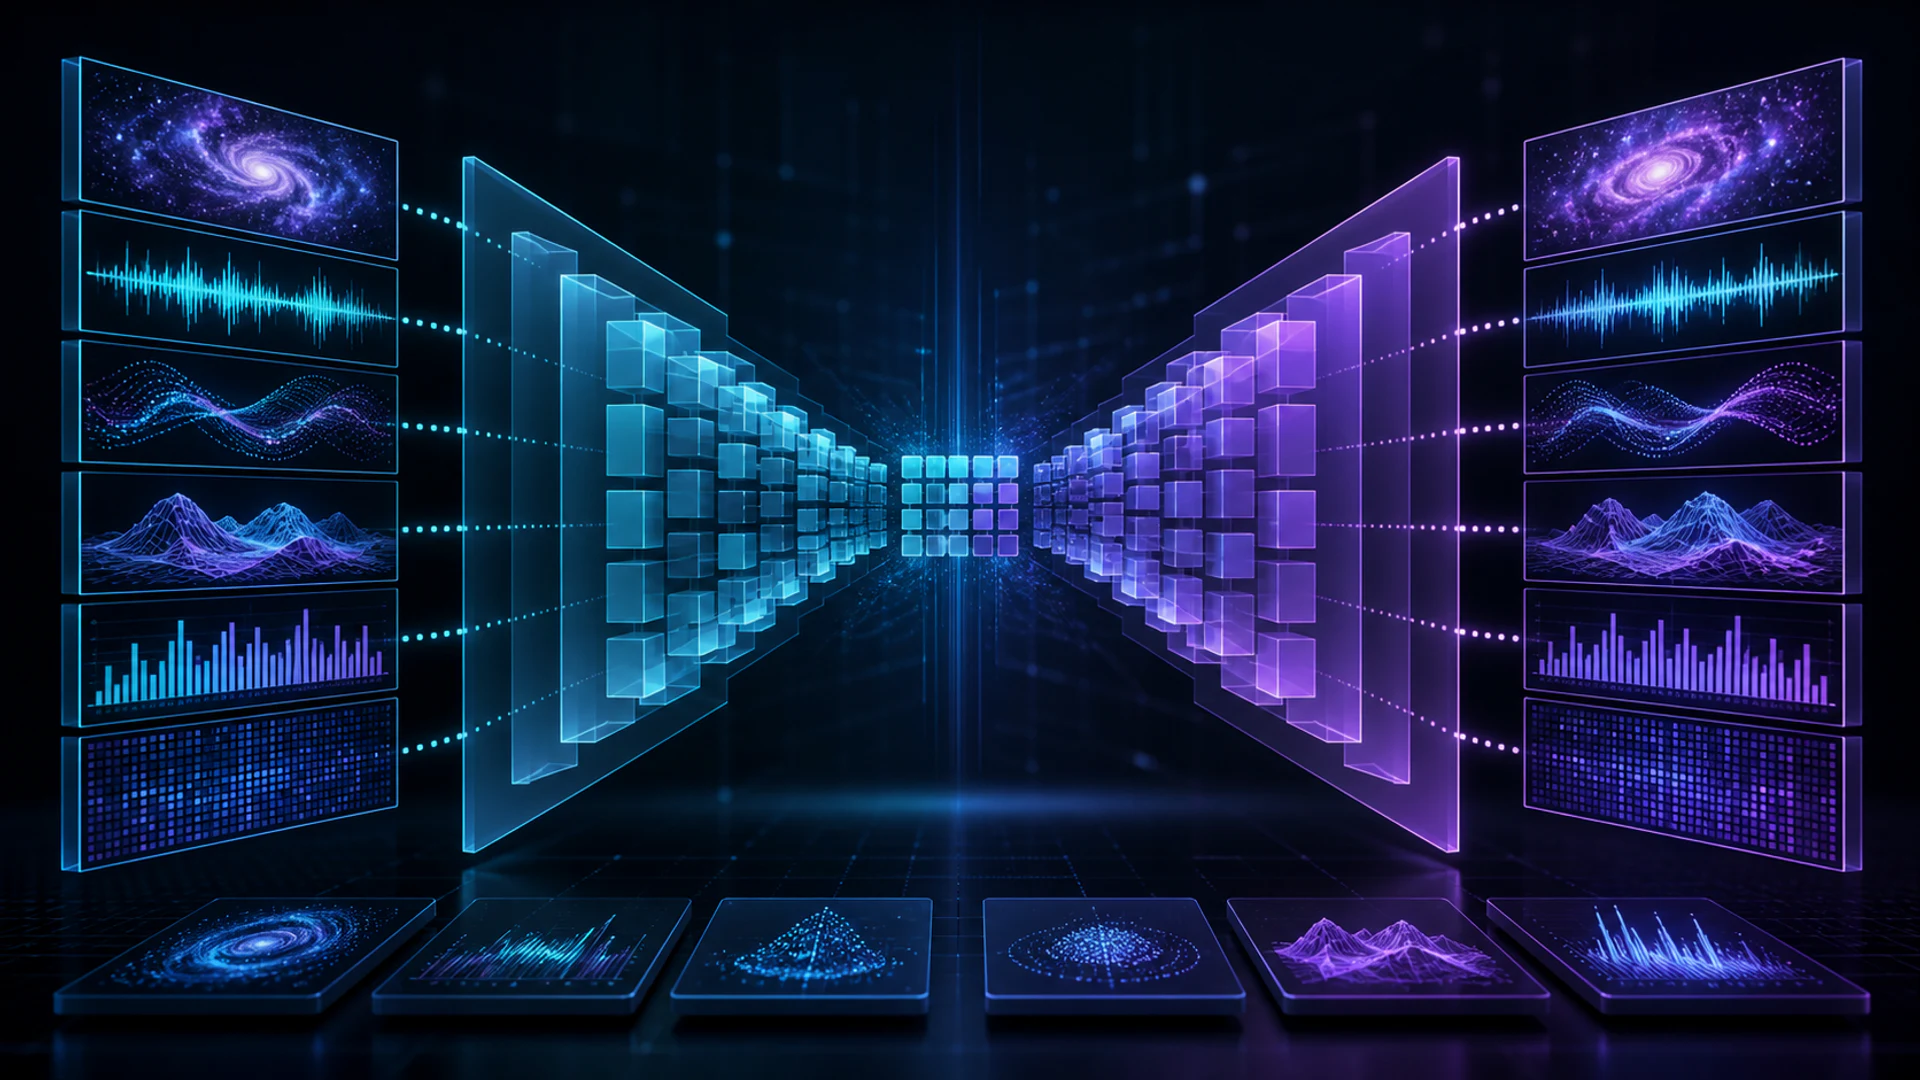
Ein Autoencoder ist ein neuronales Netzwerk, das darauf trainiert wird, seine Eingabe zu rekonstruieren. Ein Encoder bildet die Eingabe in eine latente Darstellung ab; ein Decoder wandelt diese Darstellung zurück in eine Rekonstruktion. Das Training minimiert einen Rekonstruktionsverlust, teilweise mit zusätzlichen Einschränkungen.
Das exakte Kopieren der Eingabe ist nicht automatisch nützlich. Die Architektur oder das Ziel muss einen Engpass erzeugen, Rauschen hinzufügen, Sparsamkeit auferlegen oder anderweitig eine triviale Identitätsabbildung verhindern, sodass der latente Code nützliche Strukturen erfasst.
Wichtige Erkenntnisse
- Der Encoder komprimiert oder transformiert eine Eingabe; der Decoder rekonstruiert sie aus einem latenten Code.
- Ein unterkompletter Engpass, Rauschen oder Regularisierung ermutigt das Modell, Strukturen zu lernen statt zu kopieren.
- Der Rekonstruktionsfehler kann die Anomalieerkennung unterstützen, aber Anomalien weisen nicht zwingend einen hohen Fehler auf.
- Variationale Autoencoder lernen ein probabilistisches latentes Modell und unterscheiden sich von deterministischen Autoencodern.
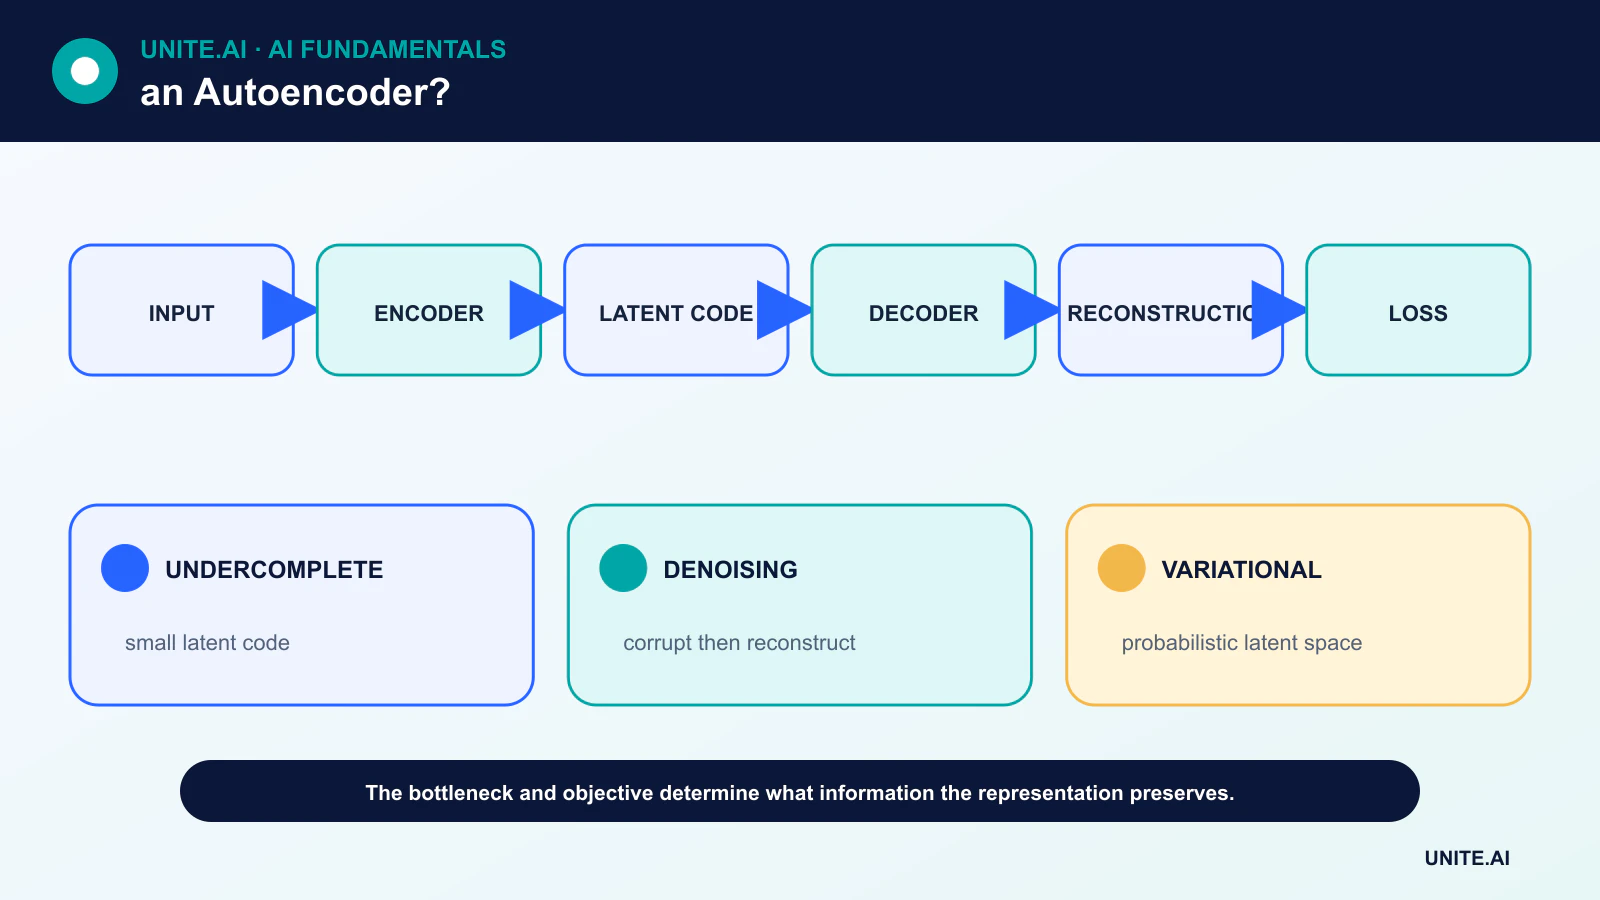
Encoder, latenter Raum und Decoder
Für die Eingabe x erzeugt der Encoder den latenten Code z = f(x) und der Decoder die Rekonstruktion x̂ = g(z). Der Verlust vergleicht x und x̂, zum Beispiel mittels mittlerem quadratischem Fehler für kontinuierliche Werte oder einer zur Datenverteilung passenden Likelihood.
Die latente Dimension kann kleiner als die Eingabe sein, wodurch ein unterkompletter Autoencoder entsteht. Ein tiefes Netzwerk kann zudem nichtlineare Darstellungen lernen und damit die Idee der Dimensionsreduktion erweitern.
Gängige Autoencoder-Varianten
Ein spärlicher Autoencoder bestraft weit verbreitete Aktivierung. Ein denoising Autoencoder erhält eine beschädigte Eingabe und rekonstruiert die saubere Version. Ein kontraktiver Autoencoder bestraft die Empfindlichkeit des Codes gegenüber kleinen Eingabeveränderungen.
Ein variational Autoencoder (VAE) kodiert Parameter einer Wahrscheinlichkeitsverteilung, sampelt einen latenten Wert und balanciert die Rekonstruktion mit einem Regularisierungsterm, der den latenten Raum formt. Das ermöglicht Stichproben, verändert jedoch Ziel und Interpretation.
Training und Vermeidung trivialer Lösungen
Autoencoder nutzen Backpropagation wie andere neuronale Netze. Ein Netzwerk mit übermäßiger Kapazität kann Trainingsbeispiele auswendig lernen oder eine nahezu identische Funktion erlernen. Engpassgröße, Rauschen, Strafterm und Validierung mit ungesehenen Daten begrenzen dies.
Die Wahl des Verlusts ist wichtig. Pixelweise Verluste können unscharfe Bildrekonstruktionen erzeugen, während perzeptuelle Verluste Annahmen eines anderen Netzwerks übernehmen. Das beste Rekonstruktionsmaß ist nicht zwangsläufig das beste Maß für semantische Ähnlichkeit.
Anwendungen und Grenzen
Autoencoder können Merkmale lernen, Signale entrauschen, Daten komprimieren, Modelle initialisieren und latente Variablen für Visualisierungen erzeugen. Für die Anomalieerkennung kann ein auf normalen Daten trainiertes Modell bei ungewöhnlichen Eingaben einen höheren Rekonstruktionsfehler zuweisen.
Dieser Ansatz kann scheitern, wenn der Autoencoder Anomalien ebenfalls gut rekonstruiert oder wenn harmlose Variationen schwerer zu rekonstruieren sind als die Zielanomalie. Schwellenwerte benötigen gelabelte oder sorgfältig geprüfte Validierungsdaten, und der Fehler sollte nach Untergruppen und Betriebsbedingungen überwacht werden.
Autoencoder im Vergleich zu anderen generativen Modellen
Ein deterministischer Autoencoder ist nicht automatisch ein probabilistisches generatives Modell. VAEs definieren eine strukturierte latente Verteilung; GANs trainieren einen Generator gegen einen Diskriminator; Diffusionsmodelle lernen einen Denoising‑Prozess.
Die Wahl hängt davon ab, ob das Ziel Rekonstruktion, Darstellung, Likelihood, Stichproben‑Treue, Steuerbarkeit oder Anomalie‑Scoring ist. Ein kleineres, auf die Aufgabe zugeschnittenes Modell ist häufig praktikabler als ein großer Bildgenerator.
Encoder‑Decoder‑Ziele und latente Darstellungen
Ein Autoencoder lernt einen Encoder, der die Eingabe x in einen latenten Code z abbildet, und einen Decoder, der x aus z rekonstruiert. Ist die Kapazität uneingeschränkt, kann er eine Identitätsabbildung mit wenig nützlicher Struktur erlernen. Engpässe, Regularisierung, Rauschen, Sparsamkeit oder architektonische Beschränkungen erzwingen eine Darstellung, die ausgewählte Informationen bewahrt. Der Rekonstruktionsverlust definiert, was als ähnlich gilt: Mittlerer quadratischer Fehler begünstigt durchschnittliche Pixeltreue, während perzeptuelle oder modalitätsspezifische Verluste unterschiedliche Merkmale betonen. Ein niedriger Verlust garantiert keine semantische Bedeutung.
Unterkomplette Autoencoder beschränken die latente Dimension. Denoising‑Autoencoder rekonstruieren saubere Daten aus einer beschädigten Eingabe. Spärliche Varianten bestrafen Aktivierung; kontraktive Varianten bestrafen Empfindlichkeit. Variationale Autoencoder lernen eine probabilistische latente Verteilung, indem sie Rekonstruktion mit einem Divergenzterm kombinieren, was Stichproben ermöglicht, aber das Ziel ändert. Convolutional‑, Sequenz‑, Graph‑ und Transformer‑Autoencoder kodieren die Struktur der Modalität. Wählen Sie die latente Größe und Regularisierung anhand von nachgelagerter Validierung, nicht nur anhand attraktiver zweidimensionaler Plots.
Anomalieerkennung, Kompression und Bewertung
Zur Anomalieerkennung trainiert man auf repräsentativen Normaldaten und bewertet den Rekonstruktionsfehler oder die latente Likelihood, wobei Anomalien manchmal gut rekonstruiert werden können und seltene Normalfälle schlecht. Schwellenwerte werden anhand gelabelter oder geprüfter Validierungsfälle gewählt, Ereignis‑Recall und Fehlalarme werden berichtet, und Änderungen im Betriebszustand werden getestet. Vergleichen Sie mit einfachen statistischen und One‑Class‑Baseline‑Modellen. Für die Kompression zählen Sie den gesamten Codec – einschließlich Modellgröße, Quantisierung, Metadaten und Dekodierungsaufwand – und vergleichen die Qualität bei gleicher Bitrate mit etablierten Codecs.
Die Qualität der Darstellung kann mittels linearer Sonden, Cluster‑Stabilität, Retrieval, Rekonstruktion und nachgelagerter Aufgaben bewertet werden, wobei jede eine andere Frage beantwortet. Vermeiden Sie Datenlecks beim Lernen des Encoders und bei der Schwellenwertauswahl. Prüfen Sie, welche Merkmale der Verlust ignoriert und ob sensible Attribute weiterhin kodiert bleiben. Ein komprimierter latenter Raum ist nicht automatisch anonymisiert; Inversion und Attribut‑Inference können private Informationen wiederherstellen. Generierte Rekonstruktionen können plausibel aussehen, während kritische Details verändert werden.
Bereitstellung und Überwachung
Versionieren Sie Encoder und Decoder gemeinsam, validieren Sie numerische Änderungen nach dem Export und bewahren Sie die Eingabeskalierung. Überwachen Sie die Rekonstruktionsverteilung, latente Drift, Schwellenwert‑Alarme und bestätigte Ergebnisse. In der industriellen Überwachung konditionieren Sie das Modell auf den Betriebsmodus, sodass normale Übergänge nicht als Fehler behandelt werden. Für medizinische oder wissenschaftliche Rekonstruktionen präsentieren Sie niemals ein generiertes Detail als gemessenen Befund ohne Validierung und Herkunftsnachweis. Autoencoder sind flexible Lernende von Darstellungen, doch die Einschränkungen und der Verlust – nicht der Architekturname – bestimmen, welche Informationen erhalten, verworfen oder erfunden werden.
Praktisches Beispiel: ein Autoencoder für Pumpen‑Anomalien
Ein unterkompletter Autoencoder lernt Vibrationsfenster aus verifizierten, gesunden Pumpen‑Betriebsdaten über Last und Temperatur. Er wird mit statistischen Schwellenwerten und One‑Class‑Methoden verglichen, und sein Rekonstruktions‑Schwellenwert wird anhand geprüfter normaler Übergänge und bekannter Fehler ausgewählt. Die Bewertung nutzt Ereignis‑Recall, Vorwarnzeit, Fehlalarme pro Betriebsstunde und Ergebnisse pro Pumpe, nicht zufällige Fenster, die benachbarte Stichproben in Training und Test setzen.
Das Produktionsmodell konditioniert den Betriebszustand und stellt Restmuster den Ingenieuren zur Verfügung. Ein hoher Fehler fordert eine Inspektion an; er diagnostiziert das Bauteil nicht und stoppt die Pumpe nicht automatisch. Sensor‑Abschaltungen, Clipping und unbekannte Lasten erzeugen explizit ungültige Zustände. Das Monitoring verfolgt die Rekonstruktionsverteilung, Alarmbestätigung und Sensor‑Gesundheit. Wenn Wartung oder Hardware die Basislinie ändern, bleibt das alte Modell verfügbar, während ein Kandidat auf geprüften Daten trainiert und gegen historische Vorfälle getestet wird.
Implementierungsnachweis und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Verantwortlichen und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Feintuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und jeden Schwellenwert, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Beweise von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Sie die Zuständigkeit für Freigabe, Ausnahmen, Änderungen, Rollbacks und Stilllegung festlegen. Nutzen Sie eine gestufte Ausrollung, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingefügten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und prüfen Sie nach der Bereitstellung reale Evidenz, anstatt anzunehmen, dass die Offline‑Leistung bestehen bleibt. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Vorfalls‑Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Sind Autoencoder verlustfreie Kompression?
Nicht allgemein. Sie lernen in der Regel aufgaben- und verteilungsspezifische verlustbehaftete Darstellungen und benötigen den trainierten Decoder, um die Daten zu rekonstruieren.
Ist jeder Engpass interpretierbar?
Nein. Ein kompakter Code kann nützlich sein, ohne dass jede Dimension einem für Menschen lesbaren Konzept zugeordnet wird.
Primärreferenzen