
Grundlagen der KI
Überwachtes vs. Unüberwachtes Lernen

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
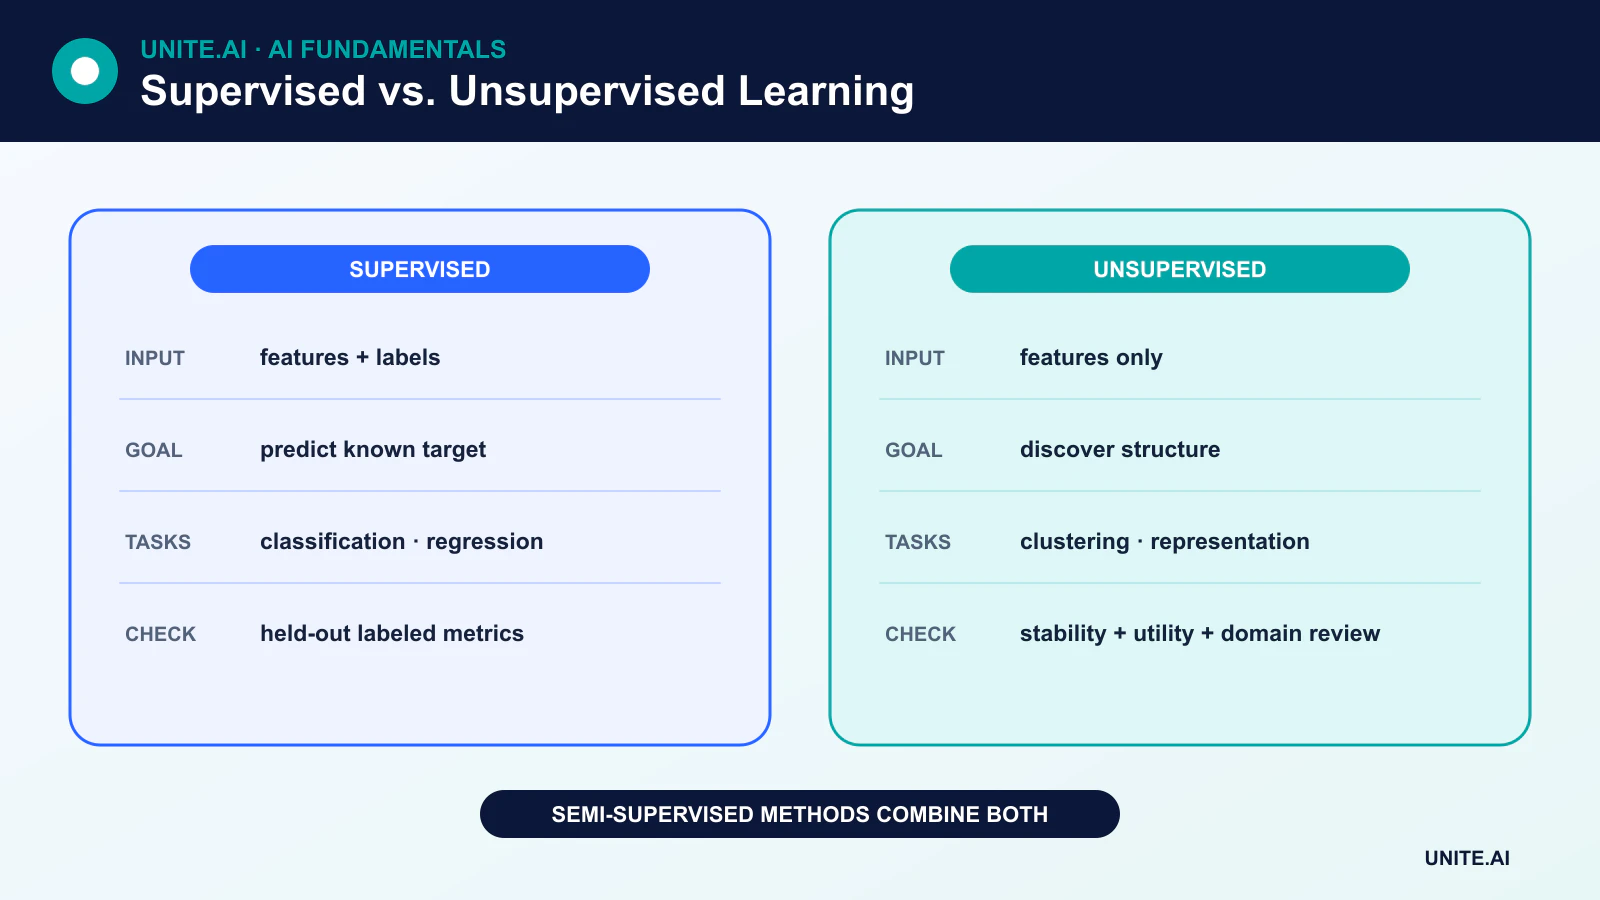
Überwachtes Lernen lernt aus Beispielen, die mit Zielantworten gekoppelt sind. Unüberwachtes Lernen sucht nach Strukturen in Daten ohne Ziel‑Labels. Der Unterschied liegt nicht darin, welcher Ansatz intelligenter oder genauer ist; sondern in der Art des verfügbaren Lernsignals und der Frage, die das System beantworten soll.
Dies sind zwei zentrale Paradigmen im Maschinellen Lernen, doch moderne Systeme nutzen ebenfalls semi‑überwachtes, selbstüberwachtes und verstärkendes Lernen.
Wesentliche Erkenntnisse
- Überwachtes Lernen sagt ein bekanntes Ziel voraus; unüberwachtes Lernen entdeckt Muster oder Repräsentationen.
- Klassifikation und Regression sind überwachte Aufgaben; Clustering, Dichteschätzung und viele Dimensionsreduktions‑Methoden sind unüberwacht.
- Unüberwachte Ausgaben entsprechen nicht automatisch realen Klassen und können schwerer zu bewerten sein.
- Rechenaufwand und Genauigkeit hängen vom Algorithmus, den Daten, der Aufgabe und der Bewertung ab – nicht allein vom Paradigma.
Wie überwachtes Lernen funktioniert
Ein überwacht‑Datensatz enthält Merkmale X und ein Ziel y. Das Training passt ein Modell an, sodass seine Vorhersagen den Zielen nahekommen. Die Bewertung nutzt zurückgehaltene, gelabelte Beispiele, um zu schätzen, wie gut das Modell verallgemeinert.
Klassifikation
Klassifikation sagt eine Kategorie voraus: Spam oder kein Spam, ein Dokumententhema unter mehreren oder ein‑ bzw. mehrere Objekte in einem Bild. Relevante Kennzahlen umfassen Präzision, Recall, F1, Kalibrierung und kosten‑sensitive Maße. Genauigkeit kann irreführend sein, wenn eine Klasse selten ist; eine Verwirrungsmatrix zeigt, welche Klassen verwechselt werden.
Regression
Regression sagt einen kontinuierlichen Wert voraus, etwa Nachfrage, Dauer oder Temperatur. Lineare Regression kann ein oder mehrere Merkmale nutzen; sie ist nicht auf die Beziehung zwischen zwei Variablen beschränkt. Regressionsmetriken umfassen mittleren absoluten Fehler, Wurzel‑Mittel‑Quadrat‑Fehler und aufgabenspezifische Kosten.
Gängige überwachte Algorithmen
Überwachte Verfahren umfassen lineare und logistische Modelle, Entscheidungsbäume, Random Forests, Gradient Boosting, Support‑Vector‑Machines, K‑Nearest‑Neighbors und neuronale Netze.
Logistische Regression liefert einen Score oder eine Wahrscheinlichkeit, die mittels eines Schwellenwerts in eine Klasse umgewandelt werden kann. Ein Blatt eines Entscheidungsbaums enthält eine Vorhersage, die auf einem Gebiet des Merkmalsraums basiert, nicht zwingend auf einer einzelnen Trainingsbeobachtung. KNN sagt basierend auf nahen, gelabelten Trainingsbeispielen voraus und erfordert dennoch ein solides Train‑/Validierungs‑/Test‑Design.
Wie unüberwachtes Lernen funktioniert
Unüberwachtes Lernen erhält Merkmale ohne Ziel‑Spalte. Das Ziel wird indirekt definiert – zum Beispiel die Distanz innerhalb von Clustern minimieren, einen Input rekonstruieren, Datendichte schätzen oder so viel Varianz wie möglich in weniger Dimensionen erhalten.
Clustering
K‑Means ordnet Punkte einer gewählten Anzahl von Clustern zu und aktualisiert die Cluster‑Zentren, um die quadratische Distanz innerhalb der Cluster zu reduzieren. Der Algorithmus entdeckt geometrische Gruppierungen unter einer bestimmten Distanz‑ und Merkmalsdarstellung. Diese Gruppen entsprechen nicht automatisch sinnvollen Kundentypen, Diagnosen oder anderen Domänen‑Labels.
Dimensionsreduktion
Dimensionsreduktion stellt Daten mit weniger Variablen dar. Die Hauptkomponentenanalyse findet orthogonale Richtungen, die unter einer linearen Projektion möglichst viel Varianz erhalten. Andere Verfahren bewahren unterschiedliche Struktur‑Notionen und können sehr unterschiedliche Visualisierungen erzeugen.
Anomalie‑ und Dichteschätzung
Unüberwachte Verfahren können schätzen, wo Daten dicht sind, und ungewöhnliche Beobachtungen markieren. Ein Anomalie‑Score beweist keinen Betrug, keinen Ausfall oder böswilliges Verhalten; er identifiziert lediglich eine Abweichung unter der gewählten Darstellung und dem Modell.
Wie unüberwachtes Lernen bewertet wird
Es gibt keinen universellen Begriff von „Genauigkeit“ im Unüberwachten. Praktiker können interne Kennzahlen wie Silhouette‑Score nutzen, die Stabilität über Stichproben vergleichen, die Nützlichkeit in einer nachgelagerten Aufgabe testen oder Domänen‑Experten fragen, ob die entdeckte Struktur sinnvoll ist. Existieren Ground‑Truth‑Labels für die Bewertung, können externe Clustering‑Metriken verwendet werden, ohne den Trainingsprozess in ein überwachtes Lernen zu verwandeln.
Jenseits des Zwei‑Wege‑Vergleichs
Semi‑überwachtes Lernen
Semi‑überwachtes Lernen kombiniert einen kleinen gelabelten Satz mit einem größeren ungelabelten Satz. Pseudo‑Labeling, Konsistenz‑Regularisierung und graph‑basierte Methoden sind Beispiele. Die ungelabelten Daten müssen dennoch der Ziel‑Verteilung ausreichend ähnlich sein, um zu helfen.
Selbstüberwachtes Lernen
Selbstüberwachtes Lernen leitet Ziele aus dem Input selbst ab, etwa das Vorhersagen maskierter Tokens oder das Abgleichen transformierter Sichten. Es bildet die Grundlage moderner Sprach‑, Bild‑ und Multimodal‑Modelle, einschließlich Transformer.
Verstärkendes Lernen
Verstärkendes Lernen optimiert Entscheidungen durch Belohnungen, die durch Interaktion entstehen. Es unterscheidet sich sowohl von gelabelter Vorhersage als auch von statischer Muster‑Entdeckung.
Die richtige Vorgehensweise wählen
Beginnen Sie mit der Entscheidung oder Einsicht, die das System liefern muss. Existieren zuverlässige Ziele und ist Vorhersage das Ziel, ist überwachtes Lernen naheliegend. Wenn das Ziel Exploration, Repräsentation oder Gruppierung ist, kann ein unüberwachtes Verfahren passen. Sind Labels knapp, kann ein selbst‑ oder semi‑überwachtes Pre‑Training gefolgt von einer überwachten Bewertung effektiver sein.
In jedem Fall können Daten‑Leakage, verzerrte Stichproben, schwache Proxy‑Variablen und Verteilungs‑Shift die Wahl des Algorithmus dominieren. Ein technisch korrektes Modell, das auf ein falsches Ziel trainiert wurde, kann dennoch scheitern.
Lernsignale, Ziele und repräsentative Methoden
Überwachtes Lernen nutzt Beispiele, die mit Ziel‑Labels oder -Werten gekoppelt sind, und minimiert den Vorhersagefehler. Klassifikation, Regression, Ranking und strukturierte Vorhersage unterscheiden sich in Output und Verlustfunktion. Unüberwachtes Lernen sucht Struktur ohne Ziel‑Labels durch Clustering, Dichteschätzung, Dimensionsreduktion, Repräsentations‑Lernen oder generatives Modellieren. Selbstüberwachtes Lernen erzeugt Vorhersage‑Ziele aus den Daten selbst, während semi‑überwachtes Lernen einen kleinen gelabelten Satz mit einem größeren ungelabelten kombiniert. Diese Kategorien beschreiben das Lernsignal; dieselbe neuronale Architektur kann unter mehreren Paradigmen trainiert werden.
Labels machen ein Ziel explizit, bringen jedoch Annotations‑Kosten, Rauschen, Annahmen über Richtlinien und zeitliche Verzögerungen mit sich. Ungelabelte Daten sind leichter zu sammeln, geben aber dem Algorithmus nicht vor, welche gefundene Struktur nützlich ist. Ein Cluster kann Beleuchtung, Dokumentenlänge oder Herkunft statt einer sinnvollen Kategorie widerspiegeln. Definieren Sie die Bewertung unabhängig: Überwachte Modelle nutzen zurückgehaltene gelabelte Ergebnisse, während unüberwachte Modelle Stabilität, Rekonstruktion, Likelihood, Retrieval, downstream‑Nützlichkeit oder Experten‑Validierung benötigen. Visuelle Trennung allein beweist keine gültige Struktur.
Ein Paradigma wählen und häufige Fehler vermeiden
Setzen Sie überwachte Lernverfahren ein, wenn ein stabiles Ziel und repräsentative Labels vorhanden sind. Nutzen Sie unüberwachte Exploration, um zusammenzufassen, Neuheiten zu entdecken, zu komprimieren oder Hypothesen zu generieren, behandeln Sie die Outputs jedoch als vorläufig. Selbstüberwachtes Pre‑Training ist wertvoll, wenn Rohdaten im Überfluss vorhanden sind und nachgelagerte Aufgaben gemeinsame Repräsentationen teilen. Semi‑überwachte Methoden helfen nur, wenn Annahmen über ungelabelte Daten und Klassenstruktur zutreffen. Vergleichen Sie mit einfachen Baselines und berücksichtigen Sie die Gesamtkosten für Sammlung, Annotation, Review, Berechnung und Fehler, statt anzunehmen, dass ungelabelt automatisch günstig ist.
Verhindern Sie Leakages, indem Sie verwandte Entitäten vor der Ableitung von Labels, Augmentierungen oder Pseudo‑Labels trennen. Überwachen Sie Klassen‑Balance, Annotations‑Übereinstimmung, Cluster‑Stabilität, Kollaps und Drift. Pseudo‑Labels können frühe Fehler verstärken; Clustering kann sensible Attribute kodieren; ein vortrainiertes Representation kann Quell‑Bias übertragen. Menschliche Reviews sollten sich auf Grenz‑Fälle und Konsequenzen konzentrieren. Dokumentieren Sie in der Produktion, wie das Lernsignal erstellt wurde und wann es veraltet. Das Paradigma bestimmt, wo Aufsicht ins System eintritt, nicht, ob menschliche Entscheidungen und Werte vorhanden sind.
Praktisches Beispiel: Entdeckung und Kennzeichnung von Support‑Themen
Ein Unternehmen nutzt zunächst unüberwachte Embeddings und Clustering, um Themen in anonymisierten Support‑Nachrichten zu explorieren. Analysten prüfen repräsentative und Grenz‑Beispiele und stellen fest, dass einige Cluster eher Nachrichtenlänge und Kanal als eigentliche Probleme widerspiegeln. Sie entwickeln daraufhin eine überwachte Taxonomie mit einer unbekannten Klasse, Annotations‑Leitfaden und gemessener Übereinstimmung. Ein Klassifikator wird anschließend auf späteren Zeiträumen, Sprachen und Produkten gegen Keyword‑ und K‑Nearest‑Neighbor‑Baselines evaluiert.
Ungelabelte neue Nachrichten unterstützen die Erkennung von Drift, trainieren den Klassifikator jedoch nicht automatisch neu. Reviewer kennzeichnen ausgewählte unsichere und emergente Fälle mittels Active Learning, mit Qualitäts‑Checks und einem versiegelten Evaluations‑Set. Das Monitoring verfolgt Themen‑Prävalenz, Vertrauen, Meinungsverschiedenheiten und Routing‑Ergebnisse. Bei Markteinführung eines neuen Produkts werden Taxonomie und Kapazität der nachgelagerten Teams gemeinsam aktualisiert. Der Workflow nutzt unüberwachte Methoden zur Hypothesen‑Generierung und überwachte Evidenz für das operative Routing.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Verantwortlichen und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie ein reproduzierbares Baseline‑Modell und ein versioniertes Evaluations‑Set, bevor Sie optimieren. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungs‑Shift, Ausfall von Abhängigkeiten, Fehlgebrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgaben‑Qualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Roll‑out bestimmen Sie Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Roll‑back und Stilllegung. Nutzen Sie ein gestaffeltes Roll‑out, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabe‑Qualität, Ausgabe‑Verhalten, Modell‑ bzw. Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse offenbaren, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für Reaktionen, prüfen Sie dann reale Evidenz nach dem Deployment, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Incidents, Lösch‑ und Aufbewahrungs‑Prozesse sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Primärreferenzen












