
Grundlagen der KI
Was ist ein Entscheidungsbaum?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
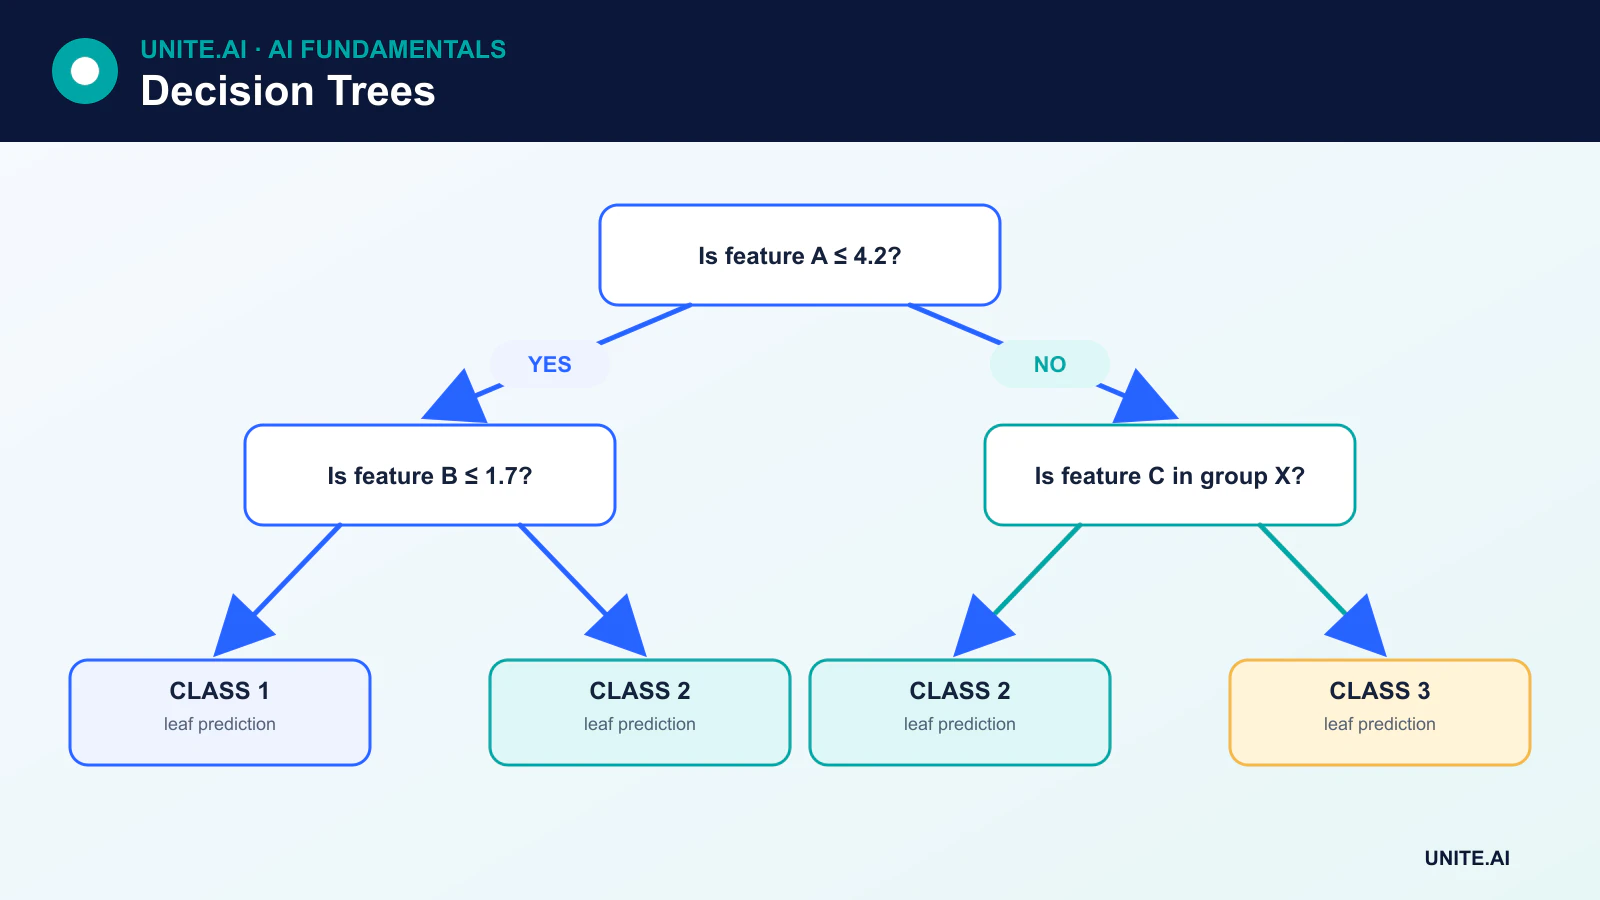
Ein Entscheidungsbaum ist ein überwacht lernendes Modell, das eine Vorhersage trifft, indem es eine Reihe von Wenn-Dann-Regeln anwendet. Jeder innere Knoten prüft ein Merkmal, jeder Ast stellt ein Ergebnis dieser Prüfung dar, und jedes Blatt liefert eine Klassen‑Vorhersage, Wahrscheinlichkeit oder einen numerischen Wert.
Entscheidungsbäume werden für Klassifikation und Regression eingesetzt. Ihr praktischer Reiz liegt darin, dass sie nichtlineare Wechselwirkungen darstellen können, nur wenig Vorverarbeitung benötigen und einen Pfad erzeugen, den ein Mensch prüfen kann. Ihre Schwäche ist die Instabilität – kleine Änderungen in den Trainingsdaten können einen anderen Baum erzeugen.
Wesentliche Erkenntnisse
- Ein Baum partitioniert den Merkmalsraum rekursiv; er muss nicht jede Trainingsbeobachtung isolieren.
- Bei Klassifikations‑Splits werden häufig Gini‑Impurität oder Entropie verwendet, während bei Regressions‑Splits der Vorhersagefehler oder die Varianz reduziert wird.
- Tiefe, minimale Blattgröße und Pruning steuern die Komplexität und Overfitting.
- Random Forests und gradienten‑geboostete Bäume steigern die Vorhersagekraft, indem sie viele Bäume kombinieren.
Wie ein Entscheidungsbaum eine Vorhersage trifft
Angenommen, ein Modell sagt voraus, ob eine Maschine wahrscheinlich ausfällt. Der Wurzelknoten könnte fragen, ob die Vibration einen erlernten Schwellenwert überschreitet. Ein Ast könnte anschließend die Betriebstemperatur prüfen. Die Beobachtung gelangt zu einem Blatt, das die geschätzte Ausfallwahrscheinlichkeit unter den Trainingsbeispielen enthält, die denselben Pfad verfolgt haben.
Bei Regression kann das Blatt den Mittelwert des Zielwerts der Beobachtungen in diesem Gebiet zurückgeben. Bei Klassifikation kann es die Mehrheitsklasse oder eine Verteilung der Klassenhäufigkeiten zurückliefern. Ein Blatt kann viele Beobachtungen enthalten; das vollständige Trennen der Trainingsdaten ist in der Regel unerwünscht, weil es zu einem überangepassten Baum führen kann.
Wie ein Baum einen Split auswählt
Beim Training werden Kandidaten‑Merkmale und Schwellenwerte geprüft, dann wird der Split ausgewählt, der das definierte Ziel am meisten verbessert. Die Verbesserung muss nach der Anzahl der Beobachtungen, die zu jedem Kindknoten gehen, gewichtet werden.
Gini‑Impurität
Für die Klassifikation misst die Gini‑Impurität, wie gemischt die Klassen in einem Knoten sind:
Gini = 1 - Σ p(k)²
Ein Knoten, der nur eine Klasse enthält, hat eine Impurität von null. Ein Kandidaten‑Split ist nützlich, wenn die gewichtete Impurität seiner Kinder niedriger ist als die Impurität des Elternknotens.
Entropie und Informationsgewinn
Entropie ist ein weiteres Maß für die Klassenunsicherheit:
Entropy = -Σ p(k) log₂ p(k)
Informationsgewinn ist die Entropie des Elternknotens minus die gewichtete Entropie der Kindknoten. Gini und Entropie erzeugen oft ähnliche Bäume, obwohl sie nicht immer identisch sind.
Regressionsverlust
Regressionsbäume wählen typischerweise Splits, die den quadratischen Fehler, den absoluten Fehler oder ein anderes Regressionskriterium reduzieren. Jedes Blatt sagt dann einen Wert voraus, basierend auf den Trainingszielen in diesem Gebiet.
CART und andere Baum‑Algorithmen
CART, oder Classification and Regression Trees, verwendet binäre Splits und liegt den gängigen Implementierungen wie den Entscheidungsbäumen von scikit-learn zugrunde. Weitere Algorithmen sind ID3, C4.5 und C5.0. Implementierungen unterscheiden sich hinsichtlich unterstützter Split‑Typen, Umgang mit fehlenden Werten, Pruning und Zielsetzungen.
Kategoriale Variablen können eine Kodierung, direkte Teilmengen‑Splits oder implementierungsspezifische Handhabung erfordern. Fehlende Werte können imputiert oder über erlernte Standardrichtungen bzw. Surrogat‑Splits behandelt werden. Es ist wichtig, das Verhalten der jeweiligen Bibliothek zu verstehen, anstatt anzunehmen, dass jede Baum‑Implementierung gleich funktioniert.
Steuerung der Baumkomplexität
Ein tiefer Baum kann Rauschen memorisieren. Übliche Kontrollen umfassen:
- Maximale Tiefe: begrenzt die Länge eines Vorhersagepfads.
- Minimale Stichprobengröße pro Split oder Blatt: verhindert winzige Regionen.
- Minimale Impuritätsreduktion: erfordert, dass ein Split ausreichend Nutzen bringt.
- Maximale Blattanzahl: begrenzt die Gesamtkomplexität.
- Kosten‑Komplexitäts‑Pruning: entfernt Zweige, deren Verbesserung die zusätzliche Komplexität nicht rechtfertigt.
Pruning ist ein strukturierter Optimierungsprozess, kein zufälliges Löschen. Hyperparameter sollten mit Validierungsdaten oder Kreuzvalidierung gewählt werden, während das finale Testset unverändert bleibt.
Stärken und Einschränkungen
Entscheidungsbäume können Interaktionen und Schwellen‑Effekte modellieren, ohne Merkmale zu skalieren. Sie akzeptieren numerische und, je nach Implementierung, kategoriale Eingaben. Die Vorhersage ist schnell, und ein kleiner Baum lässt sich leicht visualisieren.
Allerdings kann ein einzelner Baum eine hohe Varianz aufweisen, abrupte Vorhersageänderungen nahe eines Splits erzeugen und Merkmale mit vielen möglichen Split‑Punkten bevorzugen. Bäume extrapolieren zudem bei Regression schlecht: außerhalb der beobachteten Regionen gibt ein Blatt weiterhin einen aus den Trainingsdaten gelernten Wert zurück. Ein großer Baum ist möglicherweise nicht verständlicher als ein anderes komplexes Modell.
Von einem Baum zu Ensembles
Ensemble‑Learning kombiniert mehrere Modelle. Ein Random Forest trainiert viele Bäume auf neu gesampelten Beobachtungen und Teilmengen von Merkmalen und mittelt anschließend deren Vorhersagen. Gradient Boosting baut Bäume sequenziell, sodass jeder neue Baum den verbleibenden Fehler adressiert. Diese Ansätze übertreffen in der Regel einen einzelnen Baum, jedoch verlieren sie etwas an Interpretierbarkeit und erhöhen die Rechenkosten.
Die Merkmalsbedeutung eines Baumes oder Ensembles sollte vorsichtig interpretiert werden. Auf Impurität basierende Wichtigkeit kann verzerrt sein, und die Wichtigkeit eines Merkmals beweist keine Kausalität. Permutations‑Importance, Partial‑Dependence‑Werkzeuge und fachliche Überprüfung liefern zusätzlichen Kontext.
Wie ein Baum Splits und Vorhersagen lernt
Ein Entscheidungsbaum partitioniert den Merkmalsraum rekursiv. An jedem Knoten bewertet ein Trainingsalgorithmus Kandidaten‑Merkmalsschwellen oder Kategorieteilungen und wählt einen Split, der die Impurität am stärksten reduziert, z. B. Gini‑Impurität oder Entropie für die Klassifikation und quadratischen Fehler für die Regression. Blätter speichern eine Klassenverteilung oder numerische Vorhersage basierend auf den Trainingsbeobachtungen, die sie erreichen. Gieriges Splitten ist rechnerisch praktisch, garantiert jedoch nicht den global optimalen Baum, und unterschiedliche Stichproben oder Tie‑Break‑Entscheidungen können verschiedene Strukturen erzeugen.
Kontinuierliche, ordinale, kategoriale und fehlende Merkmale benötigen eine explizite Handhabung. One‑Hot‑Kodierung kann viele Kandidaten‑Splits erzeugen; native kategoriale Methoden können geordnete Statistiken nutzen, erfordern jedoch eine leak‑sichere Implementierung. Bäume benötigen keine Skalierung, können jedoch hochkardinale Variablen bevorzugen und kleine Gruppen isolieren. Tiefe, minimale Blattgröße, minimale Impuritätsreduktion und Kosten‑Komplexitäts‑Pruning steuern die Varianz. Diese sollten mit Validierungsdaten gewählt und die Kalibrierung bewertet werden, da eine Blatt‑Wahrscheinlichkeit, die auf wenigen Fällen beruht, extrem und instabil sein kann.
Interpretation, Fehlermodi und Einsatz in der Produktion
Ein Pfad vom Wurzelknoten zum Blatt ist eine exakte Regel für eine Modellvorhersage, stellt jedoch nicht automatisch eine kausale Erklärung dar. Korrelationen zwischen Variablen können einander ersetzen, kleine Datenänderungen können obere Splits verändern, und ein einfach erscheinender Pfad kann von verzerrten Labels abhängen. Auf Impurität basierende globale Merkmalsbedeutung kann irreführend sein; Permutations‑Importance, Partial‑Dependence und kontrafaktische Prüfungen liefern Kontext, besitzen jedoch Annahmen. Unsicherheit sollte berichtet und geprüft werden, ob eine behauptete Regel auf unabhängigen Daten und relevanten Untergruppen gilt.
Einzelbäume sind nützlich, wenn Transparenz, geringe Latenz und eine moderate nichtlineare Struktur wichtig sind, doch Ensembles bieten in der Regel eine stärkere Vorhersageleistung. Grenzverhalten, seltene Kategorien, Fehlwerte und Eingaben außerhalb des Trainingsbereichs sollten validiert werden. Exportierte Regeln müssen die Trainingsvorverarbeitung und numerischen Vergleiche exakt reproduzieren. Überwachen Sie Blattbelegung, Ausgabeverteilung, Fehler und entstehende Kategorien. Ein Baum, der viele neue Fälle in ein winziges oder zuvor leeres Gebiet leitet, sollte eine Überprüfung auslösen, selbst wenn der aggregierte Drift gering bleibt. Halten Sie ein Fallback für ungültige Schemata bereit und dokumentieren Sie jede Pruning‑ oder Schwellenwert‑Entscheidung.
Praktisches Beispiel: ein interpretierbarer Kredit‑Triage‑Baum
Ein Kreditgeber verwendet einen Baum ausschließlich, um unvollständige Anträge für eine manuelle Prüfung zu priorisieren, nicht um Kredite zu genehmigen oder abzulehnen. Das Ziel ist ein dokumentiertes Vollständigkeitsergebnis, und die zum Zeitpunkt der Antragstellung verfügbaren Merkmale schließen spätere Entscheidungen aus. Eine gruppierte zeitliche Validierung vergleicht einen flachen, geprunten Baum mit Regeln und logistischer Regression. Eine minimale Blattgröße verhindert Regeln, die auf einer Handvoll Antragsteller basieren, während Kalibrierung und klassen‑spezifische Fehler über Kanäle und relevante geschützte Gruppen hinweg berichtet werden.
Prüfer sehen den exakten Pfad und die Quellwerte, können jedoch fehlerhafte Daten korrigieren und die Weiterleitung überschreiben. Die Organisation testet korrelierte Proxy‑Variablen und kontrafaktische Änderungen, überwacht Blattbelegung und Fehlwerte und behandelt plötzlichen Verkehr in ein kleines Blatt als Datenqualitäts‑Incident. Richtlinienänderungen erzeugen eine neue Modellversion und Validierung, nicht einen undokumentierten Split‑Edit. Da die Nutzung den Zugang und die Belastung beeinflusst, erhalten Antragsteller einen menschlichen Kanal und der Baum wird niemals als kausale Erklärung der Kreditwürdigkeit präsentiert.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluationsdatensatz vor der Feinabstimmung. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und jeden Schwellenwert, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Zuständigkeiten für Release, Ausnahmen, Änderungen, Rollbacks und Stilllegung festgelegt werden. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingefügten Fehlfunktionen. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, die Modell‑ oder Regelversion, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion und prüfen Sie anschließend die Evidenz aus der Praxis, anstatt anzunehmen, dass die Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Primärreferenzen












