Grundlagen der KI
Was ist eine Verwirrungsmatrix?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Eine Verwirrungsmatrix ist eine Tabelle, die zählt, wie oft die Vorhersagen eines Klassifikators mit bekannten Labels übereinstimmen oder abweichen. Sie zeigt, welche Klassen verwechselt werden, und liefert die Zählungen, die zur Berechnung von Kennzahlen wie Präzision, Recall, Spezifität und F1 verwendet werden. Sie ist eines der zentralen Diagnosewerkzeuge für überwachtes Lernen bei Klassifikationsproblemen.
Die Matrix selbst ist kein einzelner Leistungswert. Sie stellt eine strukturierte Ansicht der Ergebnisse bei einem bestimmten Entscheidungsschwellenwert, Datensatz und Klassendefinition dar.
Wesentliche Erkenntnisse
- Bei binärer Klassifikation sind die vier Ergebnisse wahre Positive, falsche Positive, falsche Negative und wahre Negative.
- Beschriften Sie stets die Achsen: Bibliotheken und Publikationen ordnen die tatsächlichen und vorhergesagten Klassen nicht immer in derselben Orientierung.
- Die Genauigkeit kann bei unausgeglichenen Klassen ernsthafte Fehler verbergen.
- Das Ändern des Klassifikationsschwellwerts verändert die Verwirrungsmatrix und den Kompromiss zwischen Präzision und Recall.
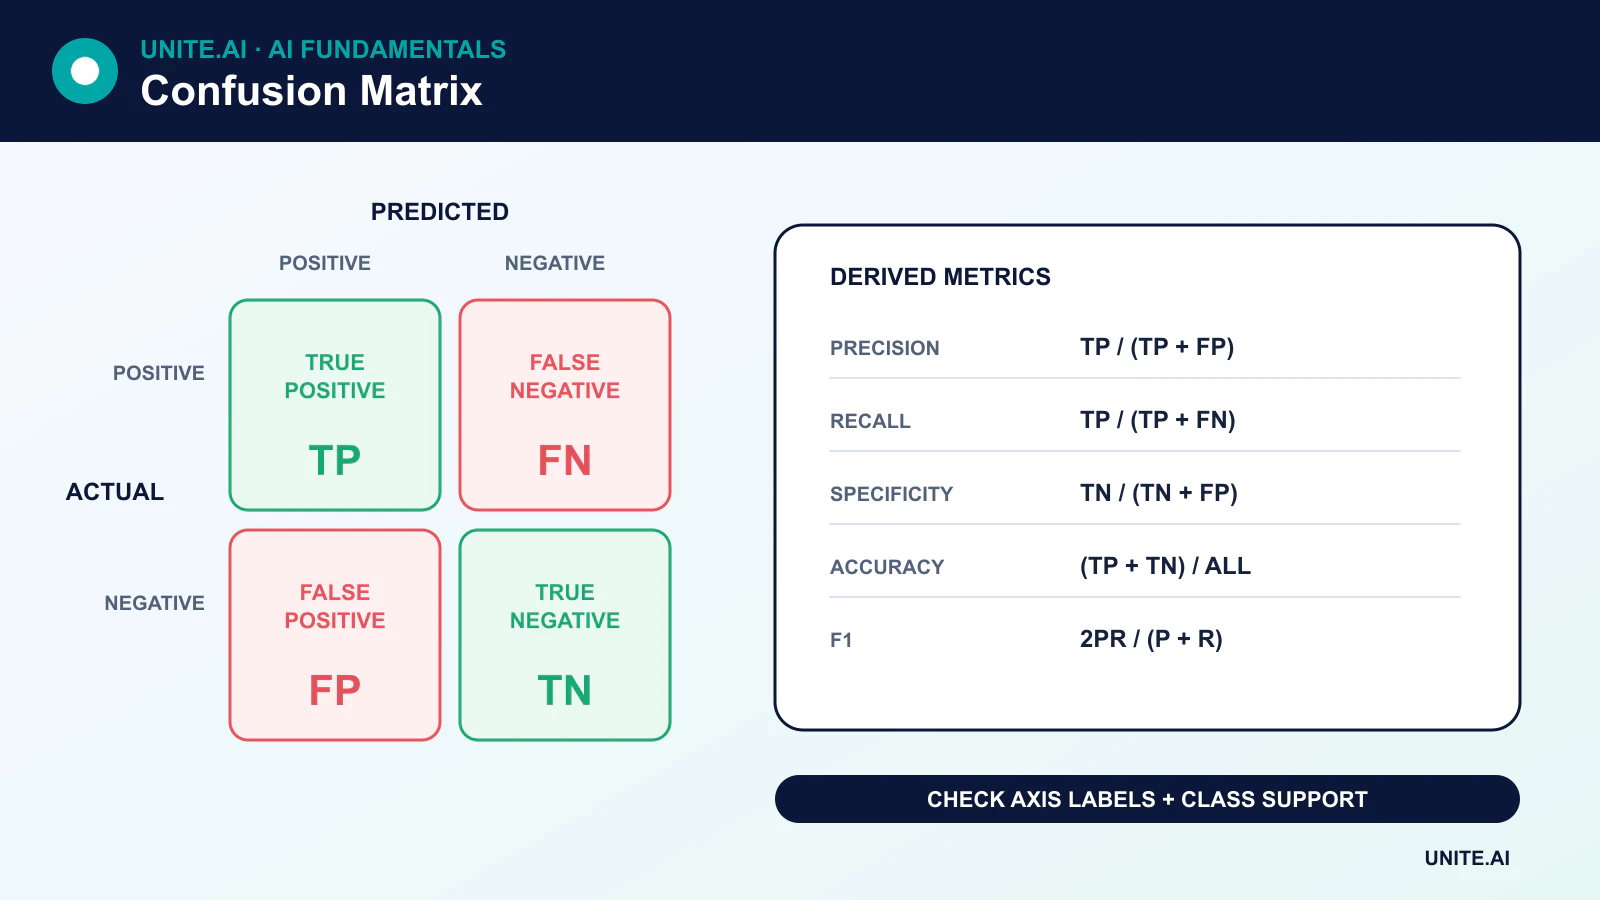
Die vier Ergebnisse der binären Klassifikation
- Wahr positives (TP): Das Beispiel ist positiv und das Modell sagt positiv voraus.
- Falsch positives (FP): Das Beispiel ist negativ, das Modell sagt jedoch positiv voraus.
- Falsch negatives (FN): Das Beispiel ist positiv, das Modell sagt jedoch negativ voraus.
- Wahr negatives (TN): Das Beispiel ist negativ und das Modell sagt negativ voraus.
Nach der Konvention von scikit-learn entsprechen die Zeilen den wahren Klassen und die Spalten den vorhergesagten Klassen. Andere Visualisierungen können diese Anordnung transponieren, sodass die Beschriftungen – nicht die Eckpositionen – die Interpretation leiten sollten.
Kennzahlen, die aus einer Verwirrungsmatrix abgeleitet werden
Präzision
Precision = TP / (TP + FP)
Präzision beantwortet: Unter den als positiv vorhergesagten Beispielen, welcher Anteil war tatsächlich positiv?
Recall oder Sensitivität
Recall = TP / (TP + FN)
Recall beantwortet: Unter allen tatsächlich positiven Beispielen, welcher Anteil wurde vom Modell identifiziert? Bei binärer Klassifikation wird der Recall der positiven Klasse auch Sensitivität oder wahre‑Positive‑Rate genannt.
Spezifität
Specificity = TN / (TN + FP)
Spezifität ist der Recall für die negative Klasse: Unter den tatsächlichen Negativen, welcher Anteil wurde vom Modell korrekt zurückgewiesen?
Genauigkeit
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Genauigkeit ist nützlich, wenn Klassen und Fehlkosten einigermaßen ausgeglichen sind. Sie kann irreführend sein, wenn eine Klasse dominiert.
F1‑Score
F1 = 2 × (Precision × Recall) / (Precision + Recall)
Der F1‑Score fasst Präzision und Recall mittels eines harmonischen Mittels zusammen. Er ignoriert wahre Negative und ist daher nicht für jede Aufgabe die passende Zusammenfassung.
Ein durchgerechnetes Beispiel
Angenommen, ein Testdatensatz enthält 1.000 Transaktionen. Fünfzig davon sind betrügerisch. Ein Modell erkennt 40 dieser Betrugsfälle, meldet jedoch 30 legitime Transaktionen als betrügerisch:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Das Modell erreicht 96 % Genauigkeit, aber seine Präzision liegt bei etwa 57 % und der Recall bei 80 %. Die hohe Genauigkeit resultiert hauptsächlich aus den vielen legitimen Transaktionen. Ob dieses Modell akzeptabel ist, hängt von den Kosten verpasster Betrugsfälle, der Untersuchungskapazität und der Kalibrierung seiner Risikobewertungen ab.
Schwellenwerte verändern die Matrix
Viele Klassifikatoren geben einen Score aus statt einer unvermeidlichen Ja/Nein‑Antwort. Das Senken des positiven Schwellenwerts erhöht in der Regel Recall und falsche Positive; das Anheben erhöht typischerweise Präzision oder Spezifität, während mehr Positive übersehen werden. Der Schwellenwert sollte anhand von Validierungsdaten und realen Fehlkosten gewählt werden, nicht automatisch auf 0,5 festgelegt.
Präzision‑Recall‑ und ROC‑Kurven fassen die Leistung über verschiedene Schwellenwerte zusammen. Präzision‑Recall‑Kurven sind häufig informativer, wenn die positive Klasse selten ist.
Mehrklassige Verwirrungsmatrizen
Für K Klassen ist die Matrix K × K. Korrekte Vorhersagen liegen auf der Diagonalen; Zellen außerhalb der Diagonalen zeigen, welche Klassenpaare verwechselt werden. Klassenbezogene Kennzahlen können auf verschiedene Arten gemittelt werden:
- Makro‑Durchschnitt: gibt jeder Klasse gleiches Gewicht.
- Gewichteter Durchschnitt: gewichtet jede Klasse nach ihrer Beispielanzahl.
- Mikro‑Durchschnitt: aggregiert Ergebniszahlen, bevor die Kennzahl berechnet wird.
Die Angabe nur eines Durchschnitts kann schlechte Leistungen bei kleineren Klassen verbergen. Geben Sie Unterstützungszahlen und klassenbezogene Ergebnisse an, wo die Unterschiede relevant sind.
Häufige Fehler
- Eine transponierte Matrix zu lesen, ohne die Achsenbeschriftungen zu prüfen.
- Kennzahlen aus Trainingsdaten zu berechnen statt aus einem geeigneten Testdatensatz.
- Die Klassenprävalenz, Stichprobenstrategie oder doppelte Entitäten über Aufteilungen hinweg zu ignorieren.
- Matrizen, die bei unterschiedlichen Schwellenwerten erzeugt wurden, zu vergleichen, ohne die Änderung zu vermerken.
- Alle falschen Positive und falschen Negative als gleich kostspielig zu behandeln.
Eine Verwirrungsmatrix ist daher ein Diagnosewerkzeug, keine vollständige Bewertung. Kalibrierung, Subgruppen‑Analyse, Robustheit und nachgelagerte Konsequenzen gehören ebenfalls in eine Klassifikationsbewertung.
Jede Zelle lesen und nützliche Kennzahlen ableiten
Bei binärer Klassifikation zählt die Verwirrungsmatrix wahre Positive, falsche Positive, falsche Negative und wahre Negative für eine gewählte positive Klasse und einen Schwellenwert. Genauigkeit teilt korrekte Vorhersagen durch alle Fälle; Präzision fragt, welcher Anteil der vorhergesagten Positiven korrekt war; Recall fragt, welcher Anteil der tatsächlichen Positiven gefunden wurde; Spezifität misst, wie viele tatsächliche Negative korrekt zurückgewiesen wurden. Der F1‑Score ist das harmonische Mittel von Präzision und Recall. Keine Kennzahl ist per se die beste: Betrugserkennung, medizinische Triage und Spam‑Filterung weisen denselben Zellen unterschiedliche Konsequenzen zu.
Bei Mehrklassen‑Problemen repräsentieren Zeilen meist die tatsächlichen Klassen und Spalten die vorhergesagten Klassen, obwohl die Konventionen variieren, sodass Beschriftungen eindeutig sein müssen. One‑vs‑Rest‑Zählungen erzeugen klassenbezogene Präzision und Recall. Makro‑Durchschnitt gewichtet Klassen gleich; Mikro‑Durchschnitt aggregiert Entscheidungen und begünstigt häufige Klassen; gewichteter Durchschnitt folgt dem Klassensupport. Mehrlabel‑Aufgaben erlauben mehrere Labels pro Element und benötigen label‑weise oder stichproben‑weise Definitionen. Normalisieren Sie nach Zeilen, um Recall‑Muster zu untersuchen, oder nach Spalten, um die Zusammensetzung der Vorhersagen zu prüfen, behalten Sie jedoch Rohzahlen bei, damit seltene Gruppen nicht visuell überbetont werden.
Schwellenwerte, Unsicherheit und operative Entscheidungen
Eine Verwirrungsmatrix fasst harte Entscheidungen bei einem Schwellenwert zusammen. Verwenden Sie Präzision‑Recall‑ oder ROC‑Kurven, um Schwellenwerte zu vergleichen, und wählen Sie dann einen Betriebspunkt basierend auf Kapazität, Prävalenz und Fehlkosten. Kalibrierung prüft, ob vorhergesagte Wahrscheinlichkeiten mit der beobachteten Häufigkeit übereinstimmen und ist vom Ranking getrennt. Bei veränderter Prävalenz kann die Präzision schwanken, selbst wenn Sensitivität und Spezifität stabil bleiben. Geben Sie Konfidenzintervalle oder Bootstrap‑Variationen an und vermeiden Sie Schlussfolgerungen aus wenigen Fehlern in einer kleinen Untergruppe.
Prüfen Sie Matrizen nach Zeit, Ort, Gerät, Sprache und relevanten betroffenen Gruppen, um konzentrierte Fehler zu finden. Vergleichen Sie das Modell mit dem bestehenden Entscheidungsprozess, einschließlich menschlicher Überprüfung. Bei Kaskaden dokumentieren Sie Fehler in jeder Stufe: Abruf, Klassifikation, Schwellenwertsetzung und Aktion. Überwachen Sie Live‑Ergebnislabels mit deren Verzögerung und Korrekturprozess. Ein scheinbar verbesserter F1‑Score kann dennoch schädliche falsche Negative erhöhen oder die Überprüfungskapazität überschreiten. Die Verwirrungsmatrix ist ein Entscheidungsbuch; verbinden Sie jede Zelle mit dem Betroffenen und der nachfolgenden Reaktion.
Durchgerechnetes Beispiel: Auswahl eines Schwellenwerts für medizinisches Screening
Ein Machine‑Learning-Screening‑Modell gibt einen Risikoscore für eine seltene Erkrankung aus. Das Team erstellt Verwirrungsmatrizen über verschiedene Schwellenwerte und berichtet Sensitivität, Spezifität, Präzision, falsche Überweisungen und verpasste Fälle mit Konfidenzintervallen. Da der positive prädiktive Wert von der Prävalenz abhängt, modelliert er die beabsichtigte Population statt die Präzision eines einzelnen Datensatzes zu zitieren. Die Ergebnisse werden nach Gerät, Standort, Alter, Geschlecht und anderen klinisch begründeten Gruppen segmentiert.
Kliniker wählen einen Betriebspunkt, der die erforderliche Sensitivität bewahrt, ohne die Bestätigungstests zu überlasten. Die Matrix wird in erwartete Zählungen pro 10.000 gescannte Personen umgerechnet, sodass die Konsequenzen verständlich sind. Scores außerhalb validierter Bedingungen führen zu keiner automatischen Schlussfolgerung. Das Monitoring vergleicht Vorhersagen mit verzögerten bestätigten Diagnosen, verfolgt Kapazität und Kalibrierung und löst eine Überprüfung aus, wenn sich Prävalenz oder Erfassungsbedingungen ändern. Die Verwirrungsmatrix bleibt mit dem genauen Modell, Schwellenwert und der Population verknüpft.
Implementierungsnachweise und operative Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Verantwortlichen und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluationsdatensatz vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und jeden Schwellenwert, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollbacks und Stilllegung festgelegt werden. Verwenden Sie eine gestufte Einführung, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingefügten Fehlfunktionen. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, die Modell‑ oder Regelversion, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion und prüfen Sie dann Evidenz aus der Praxis nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Prozeduren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Was ist eine normalisierte Verwirrungsmatrix?
Normalisierung teilt die Zählungen durch die Gesamtzahl der wahren Klassen, die Gesamtzahl der vorhergesagten Klassen oder alle Beobachtungen. Sie erleichtert den Vergleich von Raten zwischen Klassen, doch der Bericht sollte auch die Roh‑Support‑Zahlen beibehalten, damit kleine Gruppen nicht fälschlich als gleich groß angesehen werden.
Kann eine Verwirrungsmatrix Regression bewerten?
Nicht direkt. Eine Verwirrungsmatrix erfordert diskrete Klassen. Das Einteilen eines kontinuierlichen Ziels in Bins verwirft Informationen; bei Regression sollte normalerweise eine Residualanalyse und Kennzahlen für kontinuierliche Werte verwendet werden, wie MAE oder RMSE.
Primärreferenzen