
Grundlagen der KI
Was ist Overfitting?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Overfitting tritt auf, wenn ein Modell Muster oder Rauschen erfasst, die auf den Trainingsdaten außergewöhnlich gut funktionieren, aber sich nicht auf neue Beispiele verallgemeinern lassen. Ein überangepasstes Modell kann einen sehr niedrigen Trainingsfehler aufweisen, während die Validierungs‑ oder Real‑World‑Leistung deutlich schlechter ist.
Das Gegenproblem ist underfitting: das Modell oder der Trainingsprozess kann selbst im Trainingsdatensatz nicht genügend Signal erfassen. Gutes Modellieren balanciert Passgenauigkeit und Generalisierung, anstatt eine perfekte Trainingsleistung zu verfolgen.
Wesentliche Erkenntnisse
- Die Trainingsleistung allein kann die Generalisierung nicht diagnostizieren.
- Early Stopping sollte das Validierungsverhalten nutzen und niemals wiederholte Entscheidungen auf dem finalen Testset treffen.
- Mehr Daten können helfen, aber mehr Merkmale oder Kapazität können das Overfitting ebenfalls verschlimmern.
- Regularisierung, Datenaugmentation, Kreuzvalidierung, Verhinderung von Datenlecks und geeignete Evaluation behandeln unterschiedliche Ursachen.
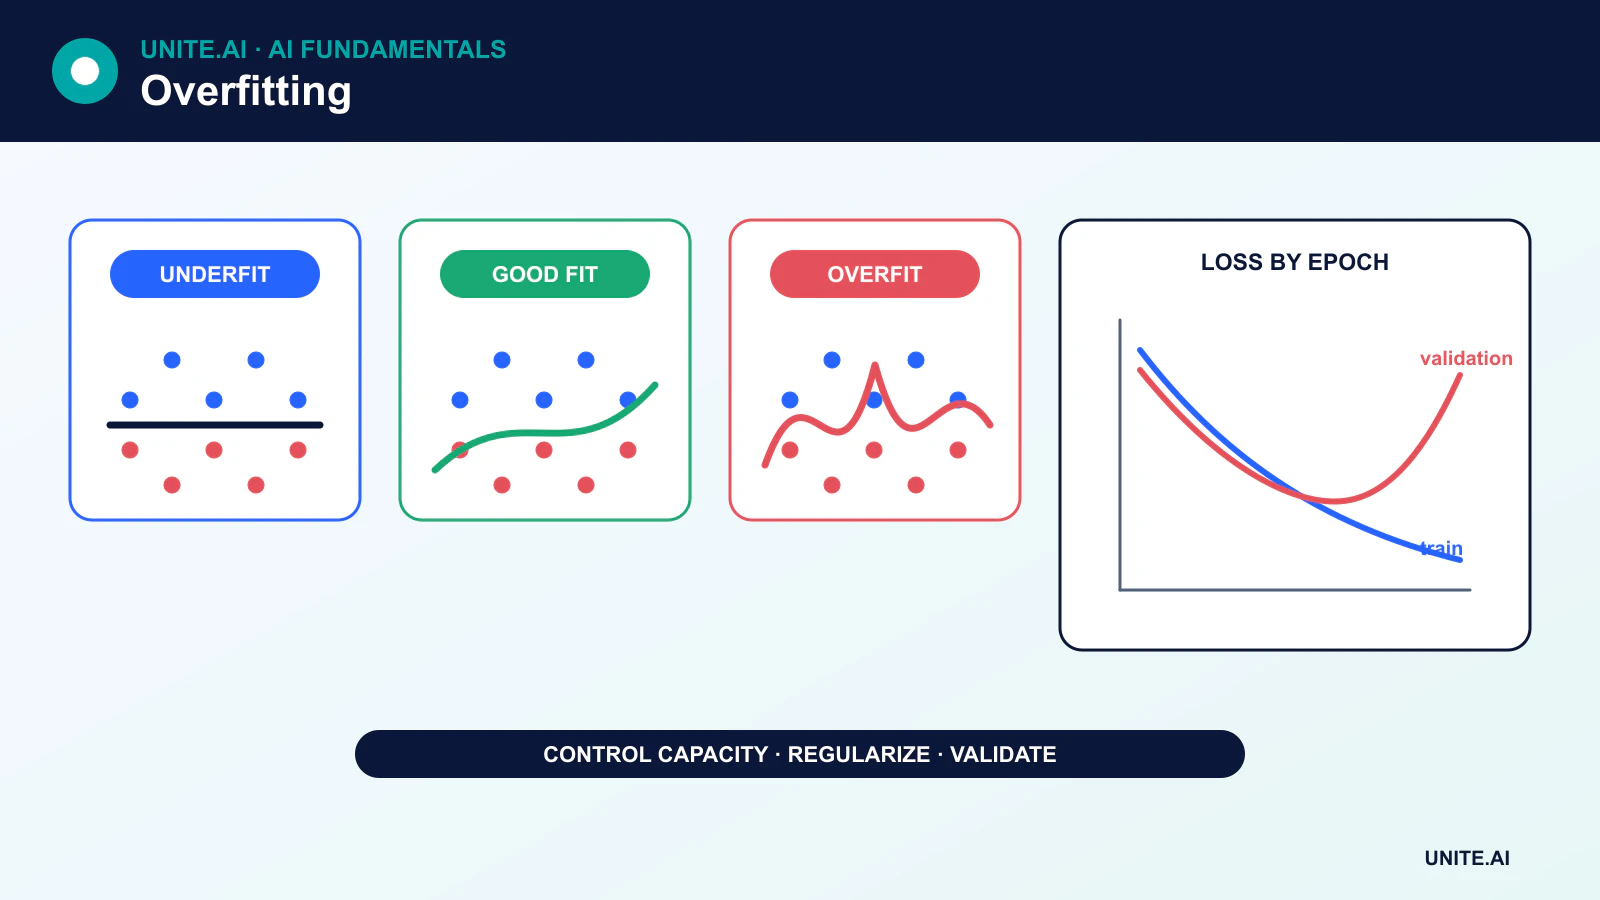
Fit, Underfitting und Overfitting
Ein Modell underfittet, wenn seine Annahmen zu restriktiv sind, wichtige Signale in den Merkmalen fehlen, die Optimierung unzureichend ist oder das Training ungenügend ist. Das Hinzufügen relevanter Merkmale oder zusätzlicher Kapazität kann helfen, aber das bloße Hinzufügen willkürlicher Merkmale kann Rauschen und Overfitting erhöhen.
Ein Modell overfittet, wenn seine effektive Kapazität im Verhältnis zu den Informationen im Trainingsdatensatz zu hoch ist. Beispiele sind ein tiefer Entscheidungsbaum, der winzige Blätter erzeugt, ein Polynom, das zufälligen Schwankungen folgt, oder ein neuronales Netzwerk, das Beispiele auswendig lernt.
Die Rolle von Trainings‑, Validierungs‑ und Testdaten
- Trainingsdaten passen die Modellparameter.
- Validierungsdaten wählen Architektur, Hyperparameter, Schwellenwerte und Stoppzeitpunkt.
- Testdaten liefern eine endgültige Schätzung, nachdem diese Entscheidungen getroffen wurden.
Wird das Testset wiederholt zur Entscheidungsfindung verwendet, wird es Teil des Entwicklungsprozesses und liefert keine unverzerrte Endschätzung mehr. Kreuzvalidierung kann begrenzte Daten effizienter nutzen, doch sämtliche Vorverarbeitung und Merkmalsauswahl müssen innerhalb jedes Trainings‑Folds erfolgen.
Frühes Stoppen
Während des Trainings sinkt der Trainingsverlust in der Regel weiter. Der Validierungsverlust kann zunächst fallen und später ansteigen, wenn das Modell sich an das Trainingsrauschen anpasst. Frühes Stoppen speichert den Checkpoint mit dem besten Validierungsziel oder stoppt, nachdem die Validierung über einen definierten Geduldszeitraum keine Verbesserung mehr gezeigt hat.
Der richtige Checkpoint ist nicht der mit dem niedrigsten Trainingsverlust. Ein separates finales Testset wird nach dem Early Stopping und dem Abschluss der Tuning‑Entscheidungen ausgewertet.
Regularisierungsmethoden
Gewichtsstrafen
L2‑Regularisierung bzw. Gewichtszerfall (weight decay) verhindert große Parameterwerte. L1‑Regularisierung kann spärliche Koeffizienten fördern. Ihre Wirkung hängt vom Modell und Optimierer ab; AdamW beispielsweise entkoppelt den Gewichtszerfall von der adaptiven Aktualisierung.
Dropout und stochastische Regularisierung
Dropout maskiert während des Trainings zufällig Aktivierungen. Andere Methoden lassen Pfade wegfallen, stören Merkmale oder glätten Labels. Diese Techniken ändern das Trainingsziel und müssen bei der Inferenz deaktiviert oder angemessen behandelt werden.
Datenaugmentation
Augmentation erzeugt realistische Variationen – wie Ausschnitte, Drehungen, Rauschen oder Paraphrasen – die das Ziel erhalten sollten. Ungültige Transformationen können das Label ändern und das Modell schädigen. Für Bilddaten helfen Werkzeuge wie Albumentations, kontrollierte Pipelines zu implementieren.
Kapazitätskontrolle
Flachere Bäume, weniger Parameter, Merkmalsauswahl, Pruning und einfachere Hypothesenklassen können die Varianz reduzieren. Beim Baum‑Pruning wird anhand von Kriterien entschieden, nicht durch zufälliges Entfernen erlernter Details.
Datenlecks können wie außergewöhnliche Leistung aussehen
Leckage tritt auf, wenn Informationen, die zum Vorhersagezeitpunkt nicht verfügbar sind, in das Training oder die Evaluation gelangen. Häufige Beispiele sind das Anpassen der Normalisierung an den gesamten Datensatz, das Aufteilen wiederholter Datensätze über Folds, die Nutzung zukünftiger Daten zur Vorhersage der Vergangenheit oder das Einbeziehen eines Merkmals, das aus dem Ziel abgeleitet ist.
Leckage ist kein gewöhnliches Overfitting, erzeugt jedoch dieselbe irreführende Lücke zwischen Offline‑Ergebnissen und dem Deployment. Die Aufteilungs‑Strategie sollte Zeit, Identität, Standort und Daten‑Generierungs‑Prozesse berücksichtigen.
Verteilungsverschiebung ist ein separates Problem
Ein Modell kann auf seine Test‑Verteilung verallgemeinern und dennoch versagen, wenn sich Produktionsdaten ändern. Neue Geräte, Richtlinien, Populationen, Jahreszeiten oder adversarisches Verhalten können die Beziehung zwischen Eingabe und Ziel verschieben. Monitoring und periodische Neubewertung sind notwendig, selbst wenn das ursprüngliche Modell nicht overfittete.
Diagnose von Overfitting
Nutzen Sie Lernkurven, Kreuzvalidierungs‑Varianz, Subgruppen‑Metriken, Kalibrierung und Fehlersichtung. Sind sowohl Trainings‑ als auch Validierungsleistung schlecht, konzentrieren Sie sich auf Underfitting, Merkmale, Labels oder Optimierung. Ist das Training stark und die Validierung schwach, untersuchen Sie Kapazität, Leckage, Regularisierung und Repräsentativität, bevor Sie einfach mehr Daten sammeln.
Warum Overfitting auftritt und wie man es erkennt
Overfitting tritt auf, wenn ein Modell Muster lernt, die den Trainingsfehler reduzieren, aber nicht auf die Zielpopulation verallgemeinern. Ursachen sind übermäßige Kapazität im Verhältnis zu den effektiven Daten, Label‑Rauschen, wiederholte Entitäten, flexible Merkmalsauswahl, Leckage und das Abstimmen am selben Validierungs‑Set. Eine wachsende Lücke zwischen Trainings‑ und Validierungsleistung ist ein häufiges Anzeichen, doch eine kleine Lücke schließt Overfitting nicht aus, wenn beide Sets kontaminiert sind oder von der Deployment‑Umgebung abweichen. Lernkurven über Datenmenge und Kapazität helfen, Varianz von Bias zu unterscheiden.
Leckage ist besonders trügerisch: Zukunftsinformationen, Duplikate, Überschneidungen von Subjekten, auf allen Daten angepasste Vorverarbeitung oder in Metadaten codierte Labels können hervorragende Hold‑out‑Scores erzeugen. Teilen Sie nach der Einheit, die beim Deployment neu sein wird – Patient, Kunde, Maschine, Standort oder Zeit – bevor Transformationen oder Augmentationen angepasst werden. Halten Sie ein finales Testset verschlossen, während Sie Merkmale, Architektur und Schwellenwerte auswählen. Wenn Teams wiederholt Testergebnisse prüfen, wird das Testset zu einem weiteren Validierungsset und muss ersetzt oder formell korrigiert werden.
Regularisierung, Modellauswahl und Produktionsdrift
Verringern Sie Overfitting mit repräsentativeren Daten, geringerer Kapazität, Gewichtszerfall, Dropout, frühem Stoppen, Augmentation, Ensembling oder Einschränkungen, die die Domänenstruktur widerspiegeln. Jede Methode hat Kompromisse: Augmentation kann Labels verzerren, Dropout ändert die Optimierung, und Ensembles erhöhen die Bereitstellungskosten. Kreuzvalidierung schätzt die Variabilität der Auswahl, doch gruppierte oder zeitbewusste Folds müssen die Deploy‑Grenze wahren. Vergleichen Sie mit einem einfachen Modell und berichten Sie Unsicherheit über Folds oder Seeds, anstatt den günstigsten Durchlauf zu wählen.
In der Produktion kann eine andere Form des Generalisierungs‑Versagens auftreten, wenn sich Eingaben, Nutzer, Anreize oder Messungen ändern. Überwachen Sie Merkmals‑ und Vorhersageverteilungen, Kalibrierung, Subgruppen‑Ergebnisse und verzögerte Ground‑Truth. Trainieren Sie nicht automatisch auf ungeprüftes Feedback neu; die eigenen Entscheidungen des Modells können die später gesehenen Labels beeinflussen. Diagnostizieren Sie, ob das Versagen aus Drift, Daten‑Pipelines, Richtlinienänderungen oder einem ungültigen Ziel resultiert. Overfitting wird durch Versuchsdesign und Lebenszyklus‑Disziplin gesteuert, nicht durch eine einzelne Regularisierungseinstellung.
Praktisches Beispiel: Eliminierung von Leckage in einem Betrugsmodell
Ein anfänglicher Betrugsklassifikator erzielt extrem gute Scores, weil wiederholte Karten‑ und Händlerereignisse in zufälligen Trainings‑ und Testzeilen erscheinen und Chargeback‑Informationen, die Wochen später aufgezeichnet wurden, als Merkmal einbezogen werden. Das Team rekonstruiert die Verfügbarkeit jedes Merkmals, entfernt nach‑Entscheid‑Felder, gruppiert nach Konto und verwendet eine Vorwärts‑Zeit‑Aufteilung. Die Leistung sinkt stark, liefert aber nun eine Schätzung der tatsächlichen Entscheidung. Ein einfacher Regel‑Baseline und Lernkurven leiten die erforderliche Modellkomplexität an.
Regularisierung und frühes Stoppen werden nur innerhalb historischer Folds abgestimmt. Die finale Evaluation berichtet Präzision bei Review‑Kapazität, Recall, Kalibrierung und Kosten nach Betrugstyp und Kundensegment. In der Produktion kommen bestätigte Labels verspätet und sind verzerrt durch die geprüften Transaktionen, sodass das Monitoring Score‑Drift von Ergebnis‑Schätzungen trennt. Das erneute Training nutzt adjudizierte Fälle und ein Replay gegen die aktuelle Richtlinie. Das Projekt bevorzugt einen niedrigeren, ehrlichen Score gegenüber einem hohen, geleakten Score, der im Deployment nicht überleben kann.
Implementierungsnachweis und operative Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die beabsichtigten Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenzen jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluations‑Set vor dem Tuning. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem ansprechenden Prototyp unterscheiden kann.
Vor dem Launch sollten Verantwortlichkeiten für Release, Ausnahmen, Änderungen, Rollback und Stilllegung zugewiesen werden. Verwenden Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabe‑Qualität, Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse aufzeigen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, dann prüfen Sie reale Evidenz nach dem Deployment, anstatt von anhaltender Offline‑Performance auszugehen. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Incidents, Lösch‑ und Aufbewahrungs‑Prozeduren sowie einen klaren Zeitpunkt, zu dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Kann ein einfaches Modell overfittieren?
Ja. Wiederholte Merkmal‑Auswahl, Schwellenwert‑Abstimmung oder Evaluation auf demselben Hold‑out‑Set können den Entwicklungsprozess überfitten, selbst wenn das finale Modell einfach ist.
Löst mehr Trainingsdaten immer Overfitting?
Nein. Mehr repräsentative, korrekt gelabelte Daten können helfen, aber duplizierte, voreingenommene, geleakte oder out‑of‑Domain‑Daten möglicherweise nicht. Das Lernziel und das Evaluations‑Design bleiben dennoch wichtig.
Primärreferenzen












