Grundlagen der KI
Was ist Ensemble-Lernen?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
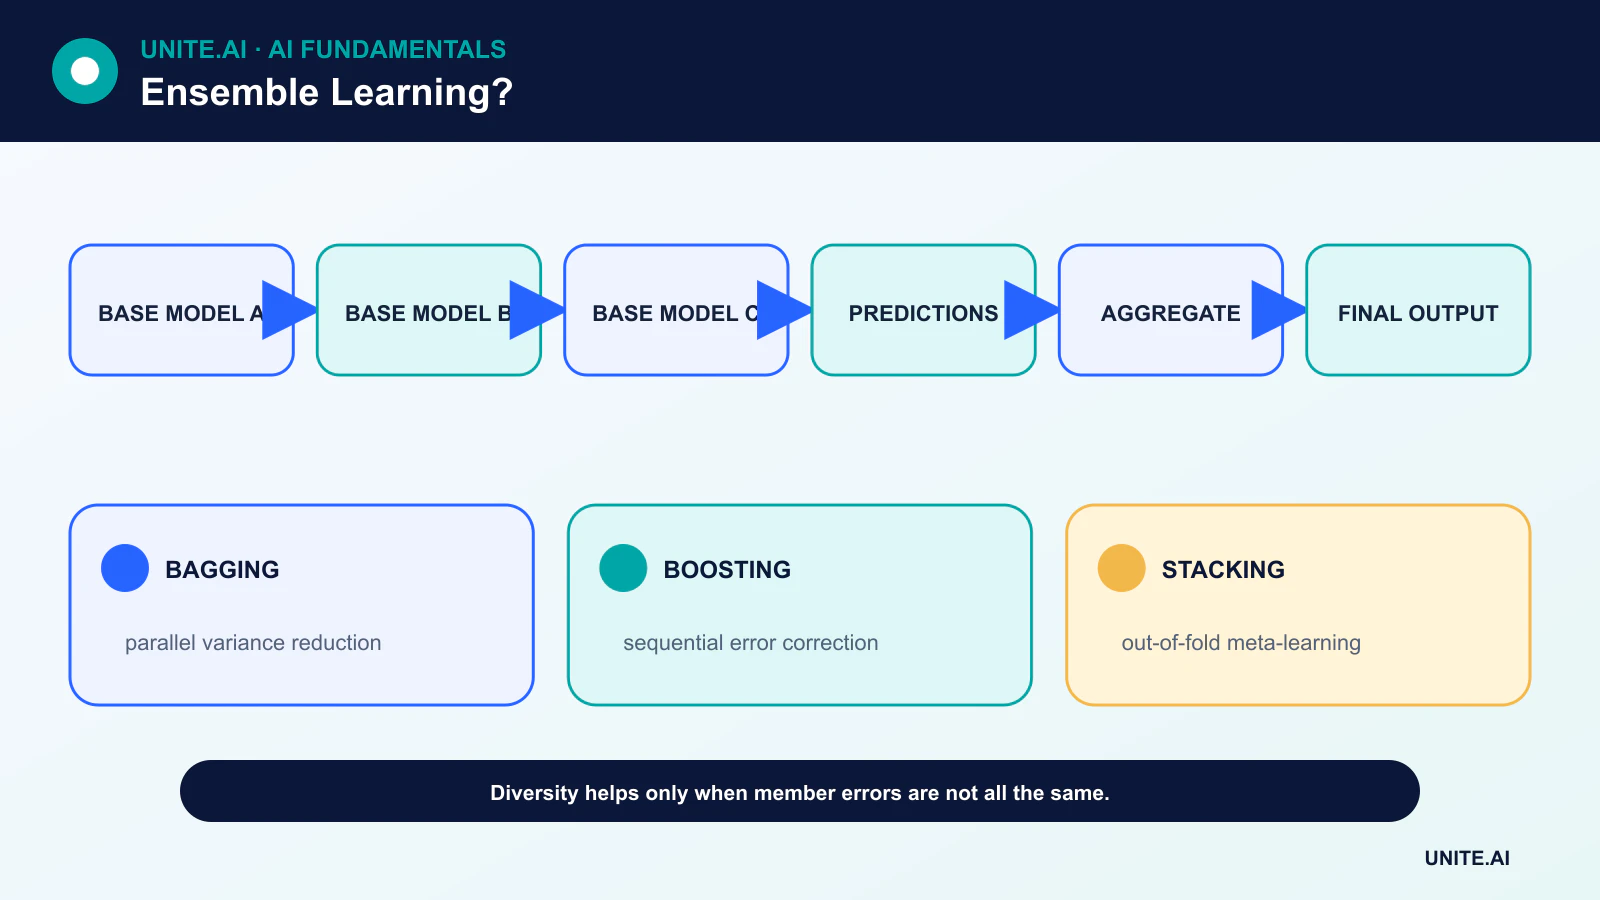
Ensemble-Lernen kombiniert Vorhersagen mehrerer Modelle. Die zentrale Idee ist, dass Modelle mit unterschiedlichen Fehlern ein genaueres oder stabileres Ergebnis liefern können, wenn ihre Ausgaben gemittelt, abgestimmt oder an einen Meta‑Lernenden übergeben werden.
Einfach nur Modelle hinzuzufügen reicht nicht. Wenn jedes Mitglied dieselbe Abkürzung lernt, werden ihre Fehler korreliert und das Ensemble wird lediglich selbstbewusster in demselben Fehler.
Wesentliche Erkenntnisse
- Ensembles funktionieren am besten, wenn die einzelnen Modelle nützlich sind und wesentlich unterschiedliche Fehler machen.
- Bagging trainiert die Mitglieder parallel auf neu gesampelten Daten; Boosting trainiert Lernende sequenziell, um Fehler zu korrigieren.
- Stacking trainiert ein Meta‑Modell anhand von Out‑of‑Fold‑Vorhersagen, nicht anhand von In‑Sample‑Vorhersagen.
- Gewinn an Genauigkeit muss gegen Latenz, Kalibrierung, Interpretierbarkeit und Wartungskosten abgewogen werden.
Abstimmung und Mittelung
Hartes Voting wählt die Klasse mit den meisten Stimmen. Soft‑Voting mittelt Klassenwahrscheinlichkeiten, meist nach Kalibrierung. Regressions‑Ensembles mitteln häufig numerische Vorhersagen. Gewichtete Varianten geben stärkeren Mitgliedern mehr Einfluss.
Eine Mittelung kann die Varianz reduzieren, wenn die Fehler nicht perfekt korreliert sind. Sie kann jedoch keinen gemeinsamen Datenfehler, Beschriftungsfehler oder fehlende Untergruppe beheben. Vielfalt sollte anhand von Meinungsverschiedenheiten und Fehlerüberlappungen gemessen werden, nicht anhand unterschiedlicher Modellnamen angenommen werden.
Bagging und Random Forests
Bootstrap‑Aggregating trainiert Modelle auf neu gesampelten Datensätzen und mittelt sie. Ein Entscheidungsbaum hat eine hohe Varianz und ist daher ein natürlicher Kandidat für Bagging.
Random Forests fügen bei Aufteilungen eine zufällige Merkmal‑Auswahl hinzu, wodurch die Korrelation zwischen Bäumen reduziert wird. Out‑of‑Bag‑Beispiele können die Leistung schätzen, aber ein abschließender, unberührter Testdatensatz bleibt für Modellwahl und Deployment‑Ansprüche wertvoll.
Boosting
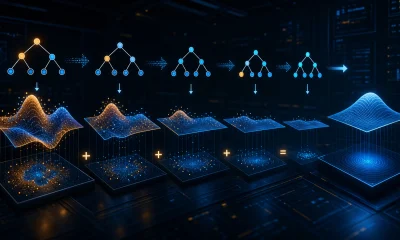
Boosting erstellt ein additives Modell in mehreren Stufen. Spätere Lernende konzentrieren sich auf Beispiele oder Residuen, die das aktuelle Ensemble schlecht behandelt. AdaBoost ändert die Gewichte der Beispiele; Gradient‑Boosting passt Lernende an die negativen Gradienten eines gewählten Verlusts an.
Geboostete Bäume können komplexe tabellarische Zusammenhänge modellieren, doch tiefe Bäume, zu viele Runden und Datenlecks können dennoch zu Overfitting führen. Lernrate, Baumtiefe, Teilstichprobe und Early‑Stopping sind zentrale Steuergrößen.
Stacking und Blending
Stacking erzeugt ein Modell der zweiten Ebene, das lernt, wie Basisvorhersagen kombiniert werden. Um Leckagen zu vermeiden, muss jede Trainingszeile für das Meta‑Modell von einem Basis‑Modell stammen, das nicht auf dieser Zeile trainiert wurde. Kreuzvalidierung erzeugt diese Out‑of‑Fold‑Vorhersagen.
Blending verwendet ein separates Hold‑out‑Set für das Meta‑Modell, was einfacher ist, aber die für das Training verfügbare Datenmenge reduziert. Beide Ansätze erfordern dieselbe Vorverarbeitung und Versionskontrolle bei der Inferenz.
Operative Kompromisse
Ein Ensemble kann Speicher, Rechenleistung und Fehlermodi vervielfachen. Es kann schwieriger zu erklären, zu kalibrieren und konsistent zu aktualisieren sein. Distillation kann ein Ensemble in ein kleineres Modell komprimieren, doch das Student‑Modell muss unabhängig bewertet werden.
Eine praktische Auswahl vergleicht Leistung, Tail‑Latenz, Kalibrierung, Ressourcenverbrauch und Fehlkosten. Manchmal ist ein gut regularisiertes Modell einer geringen Genauigkeitssteigerung durch einen fragilen Stack vorzuziehen.
Warum Ensembles funktionieren
Ensemble‑Lernen kombiniert mehrere Modelle, sodass sich ihre Fehler teilweise aufheben oder ihre Stärken verschiedene Regionen abdecken. Bagging trainiert Modelle auf neu gesampelten Daten und mittelt Vorhersagen, wodurch die Varianz reduziert wird; Random Forests fügen eine zufällige Merkmalsauswahl hinzu, um Bäume zu entkoppeln. Boosting trainiert Lernende sequenziell, um sich auf Residualfehler zu konzentrieren, reduziert häufig den Bias, erhöht jedoch die Empfindlichkeit gegenüber Rauschen und Feinabstimmung. Stacking trainiert ein Meta‑Modell anhand von Basis‑Modell‑Vorhersagen. Vielfalt muss nützlich sein: Das Mitteln identischer Modelle verursacht Kosten, ohne die Fehlerrate wesentlich zu senken.
Die Korrelation zwischen den Fehlern bestimmt den Nutzen. Vielfalt kann aus Datenstichproben, Merkmalen, Algorithmen, Hyperparametern, zufälliger Initialisierung oder Zeitfenstern entstehen. Hartes Voting verwirft das Vertrauen; Soft‑Voting mittelt Wahrscheinlichkeiten, erfordert jedoch kompatible Kalibrierung. Regression kann mitteln oder robuste Aggregation nutzen. Beim Stacking sind Out‑of‑Fold‑Vorhersagen essenziell – das Training des Meta‑Modells auf Basis‑Vorhersagen aus denselben angepassten Daten führt zu Leckagen. Behalten Sie eine einfache Mittelungsbasis bei, bevor Sie einen komplexen Kombinator einsetzen.
Evaluation, Kalibrierung und Unsicherheit
Vergleichen Sie jedes Mitglied und das Ensemble auf einem Hold‑Out‑Set mit identischer Vorverarbeitung. Berichten Sie Aufgabenmetriken, Kalibrierung, Untergruppen‑Fehler, Varianz über Folds oder Seeds sowie Ressourcenkosten. Ein Ensemble kann die durchschnittliche Qualität verbessern, während es gleichzeitig ein gemeinsames Blindspot, verursacht durch gemeinsame Daten oder Labels, verdeckt. Untersuchen Sie Meinungsverschiedenheiten: Sie können Unsicherheit aufzeigen, doch korrelierte, zuversichtlich falsche Modelle können übereinstimmen. Kalibrieren Sie das finale Ensemble, nicht nur die Mitglieder, und validieren Sie Schwellenwerte für das Zurückhalten gegenüber Prüfkapazität und Konsequenzen.
Out‑of‑Bag‑Schätzungen sind für bagged Modelle nützlich, ersetzen jedoch keinen abschließenden, deploymentsrepräsentativen Test. Bei zeitlichen Daten sollte man Resampling vermeiden, das die Reihenfolge zerstört. Für sicherheitsrelevante Anwendungen sollten Ausfälle von Mitgliedern, veraltete Modelle und adversariale Eingaben getestet werden. Gewichtete Ensembles können bei vielen getesteten Kandidaten die Validierungsdaten überanpassen. Dokumentieren Sie die Kandidatenauswahl und verwenden Sie verschachtelte Validierung, wenn die Feinabstimmung umfangreich ist.
Bereitstellung und Wartung
Ensembles vervielfachen Speicher, Latenz, Energieverbrauch und operative Abhängigkeiten. Distillation kann das kombinierte Verhalten in ein Modell komprimieren, was eine neue Validierungsanforderung mit sich bringt. Versionieren Sie Mitglieder, Vorverarbeitung, Gewichte und Routing als ein Artefakt; definieren Sie das Verhalten, wenn ein Mitglied zeitlich ausfällt oder ein ungültiges Ergebnis liefert. Überwachen Sie die Vorhersagen der Mitglieder und deren Meinungsverschiedenheiten, damit stille Fehler sichtbar werden. Entfernen Sie redundante Mitglieder und trainieren Sie gezielt neu. Ensembles verbessern Vorhersagen, wenn Fehlervielfalt tatsächlich vorhanden ist, aber sie verwandeln keine voreingenommenen Trainingsdaten oder ein ungültiges Ziel in verlässliche Evidenz.
Praktisches Beispiel: ein Ensemble für Unwetter‑Warnungen
Ein Vorhersage‑Team kombiniert einen physikalischen Modell‑Feature‑Satz, einen gradient‑geboosteten Baum, ein neuronales Sequenzmodell und eine kalibrierte statistische Basislinie. Out‑of‑Fold‑Vorhersagen trainieren ein einfaches Meta‑Modell, und die Evaluation nutzt zukünftige Stürme, die vollständig vom Training der Mitglieder ausgeschlossen sind. Metriken umfassen Ereignis‑Recall, Fehlalarme, Vorlaufzeit, Kalibrierung, geografische Leistung und Zuverlässigkeit unter seltenen extremen Bedingungen. Die Korrelation der Fehlervarianz der Mitglieder wird untersucht, da geteilte Eingabedaten gemeinsame Blindspots erzeugen können.
Die Bereitstellung speichert jede Vorhersage und das kombinierte Ergebnis. Ist ein Mitglied nicht verfügbar, verwendet das System eine vorvalidierte, degradierte Konfiguration, anstatt stillschweigend neu zu normalisieren. Meinungsverschiedenheiten lösen zusätzliche Prüfungen aus, werden jedoch nicht in allen Fällen als Unsicherheit behandelt. Das Monitoring verfolgt Drift der Mitglieder, Latenz und Sturm‑Ergebnisse, wobei Gewichte nur durch kontrollierte Validierung aktualisiert werden. Öffentliche Warnungen bleiben im Rahmen autorisierter meteorologischer Entscheidungsprozesse; das Ensemble verbessert die Evidenz, definiert jedoch die Alarm‑Politik nicht eigenständig.
Implementierungsnachweise und operative Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluations‑Set vor der Feinabstimmung. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout sollten Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung festgelegt werden. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und verifizieren Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabequalität, Ausgabeverhalten, Modell‑ oder Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse aufzeigen, ohne unnötige sensible Daten zu erfassen. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie nach dem Deployment reale Evidenz, anstatt anzunehmen, dass Offline‑Leistungen bestehen bleiben. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Ist ein Random Forest ein Ensemble?
Ja. Es kombiniert viele zufällig erzeugte Entscheidungsbäume, meist durch Abstimmung oder Mittelung.
Können identische Modelle ein nützliches Ensemble bilden?
Sie können das, wenn Trainingsdaten, Initialisierung oder Stichproben ausreichend unterschiedliche Fehler erzeugen, aber reine Duplizierung bringt keinen Nutzen.
Primärreferenzen