
Grundlagen der KI
Was ist Edge‑KI & Edge‑Computing?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Edge‑Computing verlagert die Berechnung in die Nähe der Geräte und physikalischen Prozesse, die Daten erzeugen. Edge‑KI führt Machine‑Learning‑Inference – und manchmal Training oder Anpassung – auf einem Sensor, Telefon, Fahrzeug, Gateway oder lokalen Server aus, anstatt jede Eingabe an eine entfernte Cloud zu senden.
Die Architektur ist in der Regel ein Kontinuum und nicht eine Gegenüberstellung von Edge und Cloud. Sofortige Entscheidungen können lokal bleiben, während die Cloud Flottenmanagement, aggregierte Analysen, Modelltraining und Langzeitspeicherung unterstützt.
Wesentliche Erkenntnisse
- Edge‑KI kann Latenz, Bandbreitennutzung und Rohdatenübertragung reduzieren, garantiert jedoch nicht automatisch Datenschutz.
- Speicher‑, Energie‑, Thermallimits und die Unterstützung von Beschleunigern bestimmen das einsetzbare Modell.
- Quantisierung, Pruning und Distillation tauschen Modellgröße und Geschwindigkeit gegen Genauigkeit und Robustheit ab.
- Sichere Updates, Telemetrie, Rollback und Hardware‑Vielfalt sind zentrale Bestandteile des Systems.
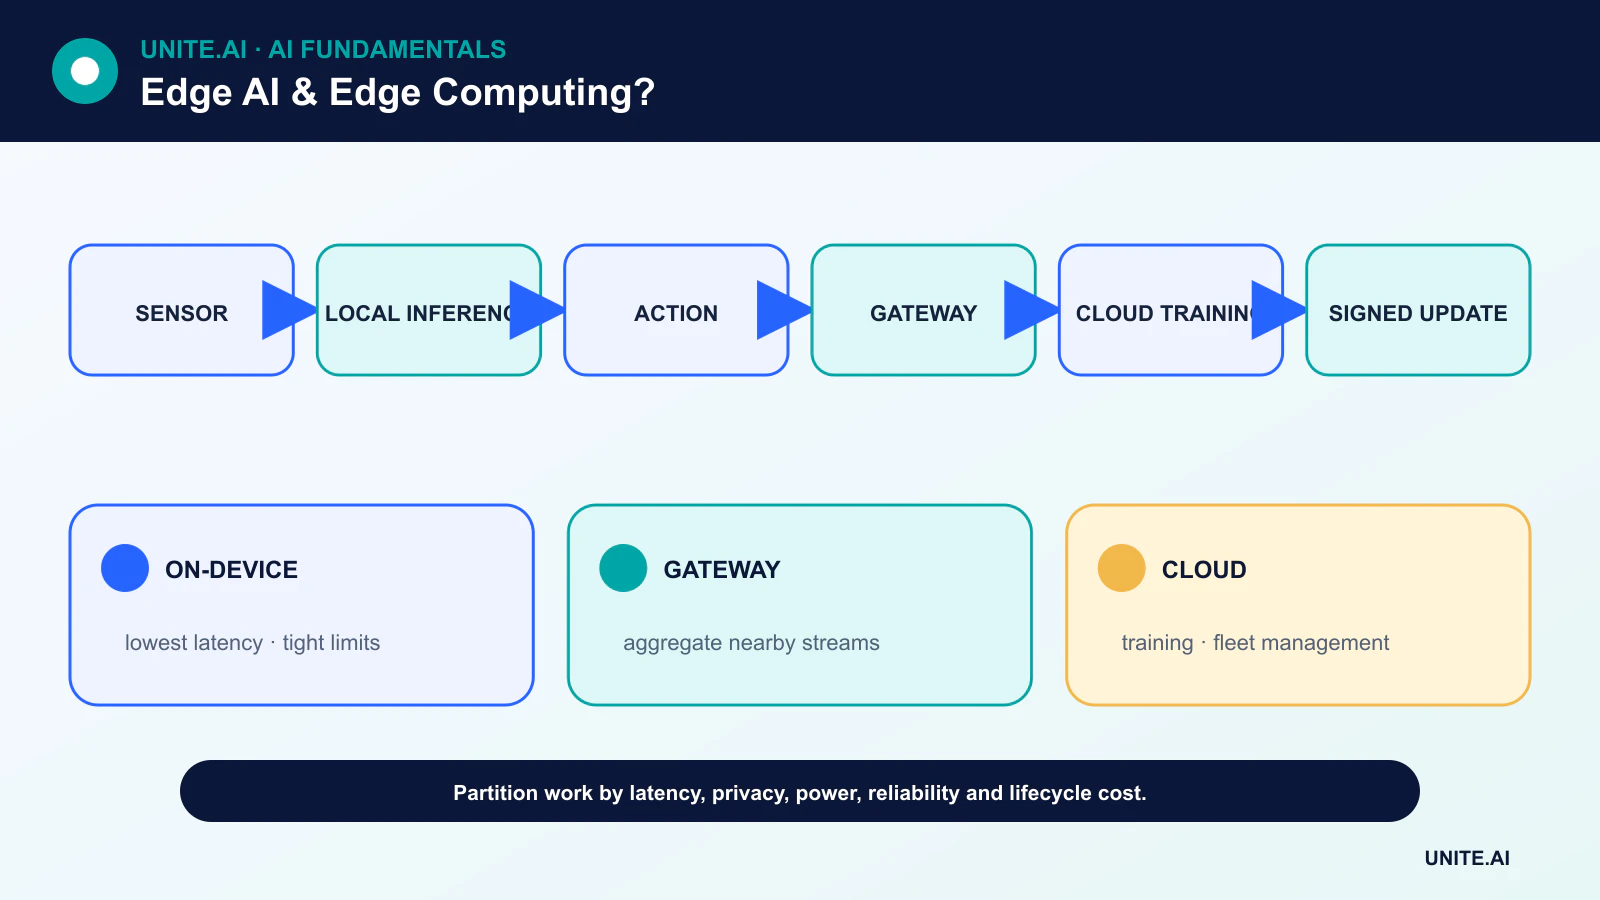
Das Edge‑Cloud‑Kontinuum
Ein Sensor kann ein kleines Schwellenwert‑Modell ausführen, ein nahegelegenes Gateway kann mehrere Datenströme kombinieren und ein regionaler Server kann aufwändigere Inferenz durchführen. Die Cloud kann Modelle trainieren und signierte Updates verteilen. Die Aufteilung hängt von Latenz, Konnektivität, Energie, Datensensitivität und Wartung ab.
Bei industrieller Steuerung können Millisekunden und Offline‑Betrieb lokale Inferenz rechtfertigen. Für eine seltene geschäftliche Vorhersage kann zentrale Berechnung einfacher und besser nachvollziehbar sein.
Hardware‑ und Modell‑Einschränkungen
Edge‑Geräte reichen von Mikrocontrollern mit Kilobytes Speicher bis zu Telefonen und Servern mit NPUs oder GPUs. Das Modell muss in Speicher und RAM passen, Echtzeit‑Fristen einhalten, innerhalb thermischer Grenzen bleiben und unterstützte Operatoren verwenden.
Benchmarks sollten Vorverarbeitung, Datenbewegung und Aufwachkosten berücksichtigen – nicht nur die Kernel‑Durchsatzrate. Die Batch‑Größe ist häufig eins, und die nachhaltige Leistung kann von einem kurzen Labortest abweichen.
Kompression und Optimierung
Quantisierung stellt Gewichte und Aktivierungen mit geringerer Präzision dar. Pruning entfernt Parameter oder Strukturen. Knowledge‑Distillation trainiert einen kleineren Student, der einen größeren Lehrer nachahmt. Operator‑Fusion und Speicherplanung können die Latenz weiter reduzieren.
Kompression kann Genauigkeit, Kalibrierung und Teilgruppen‑Performance verändern. Teams sollten das konvertierte Artefakt auf der Zielhardware validieren, anstatt anzunehmen, dass die Metriken des ursprünglichen Fließkomma‑Modells weiterhin gelten.
Datenschutz, föderiertes Lernen und Sicherheit
Lokale Inferenz kann Roh‑Audio, Bilder oder Sensordaten auf dem Gerät behalten, aber Metadaten, Embeddings und Telemetrie können weiterhin sensibel sein. Föderiertes Lernen kann verteiltes Training koordinieren, birgt jedoch eigene Datenschutz‑ und Poisoning‑Risiken.
Edge‑Flotten vergrößern die Angriffsfläche. Secure‑Boot, signierte Modelle, Services mit minimalen Rechten, verschlüsselte Kommunikation und zeitnahe Updates gehören in das Cybersecurity-Design. Physischer Zugriff und langlebige, nicht unterstützte Geräte müssen angenommen werden.
Überwachung und Flottenbetrieb
Ein lokales Modell benötigt weiterhin Beobachtbarkeit. Geräte können datenschutzbewusste aggregierte Metriken, Version, Gesundheitszustand, Latenz und Ablehnungsraten melden. Das Stichproben‑Sampling ausgewählter Eingaben zur Überprüfung erfordert ausdrückliche Einwilligung und Aufbewahrungskontrollen.
Rollouts sollten Canary‑Gruppen und automatischen Rollback nutzen. Das System muss inkompatible Hardware, unterbrochene Updates und Modell‑Drift handhaben. Ein Gerät, das keine Sicherheits‑Updates erhalten kann, muss möglicherweise aus dem Dienst genommen werden.
Edge‑Architektur und Arbeitslast‑Platzierung
Edge‑Computing verarbeitet Daten in der Nähe ihrer Quelle – auf einem Sensor, Gerät, Gateway, Fahrzeug, Einzelhandelsstandort oder lokalen Server – anstatt vollständig auf eine entfernte Cloud zu setzen. Edge‑KI platziert Modell‑Inference oder manchmal Training in dieser Umgebung. Die Platzierung sollte Latenz, Konnektivität, Bandbreite, Datenschutz, Resilienz, Energie‑ und Management‑Bedürfnisse berücksichtigen. Ein hybrides Design kann sofortige Erkennung lokal durchführen, ausgewählte Ereignisse an ein regionales System senden und die Cloud für Flotten‑Analytics und Modell‑Training nutzen.
Hardware reicht von Mikrocontrollern und NPUs bis zu GPUs und robusten Servern. Modelle werden exportiert, quantisiert, gepruned, destilliert oder für verfügbare Operatoren und Speicher kompiliert. Vorverarbeitung und Sensor‑I/O können die Latenz dominieren, während Hitze‑ oder Batterielimits die nachhaltige Durchsatzrate begrenzen. Benchmarken Sie die komplette Pipeline auf dem genauen Gerät unter realistischen Parallelitäts‑, Temperatur‑ und Energiemodi. Eine Überschriften‑TOPS‑Zahl offenbart weder Operator‑Fallbacks, Speicher‑Transfers noch die eingesetzte Genauigkeit.
Flotten‑Sicherheit, Updates und Beobachtbarkeit
Verteilte Geräte vergrößern die Angriffsfläche und können physisch zugänglich sein. Nutzen Sie Secure‑Boot, signierte Firmware und Modelle, hardwaregestützte Identität wo möglich, verschlüsselte Kommunikation, das Prinzip der minimalen Rechte, Netzwerksegmentierung und geschützte Geheimnisse. Updates benötigen gestufte Rollouts, Kompatibilitätsprüfungen, Anti‑Rollback‑Richtlinien wo angebracht, Wiederherstellung bei unterbrochenen Updates und ein als gut bekanntes Image. Inventarisieren Sie Geräte-, Sensor‑, Firmware‑, Laufzeit‑ und Modell‑Versionen, damit ein Vorfall schnell eingegrenzt werden kann.
Die Konnektivität ist intermittierend, daher Daten mit begrenztem Speicher puffern, Ereignisse sequenzieren, Wiederholungen idempotent gestalten und Offline‑Verhalten definieren. Beobachtbarkeit sollte Gesundheit, Latenz, Energie, Eingabe‑Zusammenfassungen, Vorhersagen, Konfidenz und bestätigte Ergebnisse erfassen, ohne unnötige Rohdaten zu übertragen. Uhrzeit‑Drift, Sensor‑Ausfälle und Erschöpfung des lokalen Speichers können Ergebnisse ungültig machen. Remote‑Befehle und Debug‑Kanäle erfordern stärkere Autorisierung, da sie zu flächenweiten Steuerpfaden werden können.
Verantwortungsbewusste Bereitstellung
Lokale Verarbeitung kann den Transfer reduzieren, schützt jedoch nicht automatisch die Privatsphäre; Roh‑Inputs, Embeddings und Protokolle können weiterhin auf dem Gerät verbleiben oder später synchronisiert werden. Minimieren Sie die Aufbewahrung und geben Sie Cloud‑Fallbacks offen. Testen Sie Modell‑Drift über Standorte und Umweltbedingungen hinweg, mit einem sicheren Standard, wenn das Vertrauen oder die Sensor‑Gesundheit nachlässt. Edge‑KI ist wertvoll, wenn lokale Beschränkungen real sind, überträgt jedoch die Verantwortung für Lebenszyklus, Sicherheit und Qualität auf eine große heterogene Flotte, die als ein System konzipiert und gewartet werden muss.
Praktisches Beispiel: Edge‑KI für eine entfernte Sicherheitskamera
Eine entfernte Anlage erkennt, ob ein gesperrtes Tor geöffnet ist, während Maschinen in Betrieb sind. Das Edge‑Gerät verarbeitet das Video lokal für geringe Latenz und überträgt nur Ereignisse und zulässige Thumbnails. Die Daten umfassen Wetter, Nachtbeleuchtung, Schmutz, Vibrationen und leere Szenen. Das Modell ist quantisiert und End‑zu‑End‑auf dem Zielgerät für Erkennung, Fehlalarme, Latenz, Energieverbrauch und nachhaltiges thermisches Verhalten benchmarked.
Secure‑Boot, signierte Updates, Geräte‑Identität und segmentierte Netzwerke schützen die Flotte. Kameraverstopfung, Speichererschöpfung, Uhrzeit‑Drift, Netzwerkverlust und Modell‑Timeout erzeugen Gesundheitsalarme und eine sichere Geräteregel, die unabhängig von KI ist. Updates werden einer kleinen Gruppe mit automatischem Rollback ausgerollt. Monitoring sammelt minimale Gesundheits‑ und Ergebnisdaten, und das Vor‑Ort‑Personal kann prüfen und übersteuern. Lokale Inferenz reduziert den Transfer, beseitigt jedoch nicht Datenschutz‑, Aufbewahrungs‑ oder physische Sicherheitsverpflichtungen.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Feintuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Sie die Verantwortung für Freigabe, Ausnahmen, Änderungen, Rollback und Stilllegung zuweisen. Nutzen Sie einen gestuften Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit gezielt eingespeisten Fehlern. Operative Telemetrie sollte Eingabequalität, Ausgabeverhalten, Modell‑ oder Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Übersteuerungen und bestätigte Ergebnisse offenbaren, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion und prüfen Sie dann Evidenz aus der Praxis nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Incident‑Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist Edge‑KI immer schneller als Cloud‑KI?
Nein. Lokale Inferenz vermeidet Netzwerkverzögerungen, kann jedoch auf schwächerer Hardware laufen. Die gesamte Pipeline und Zuverlässigkeitsanforderungen bestimmen die Latenz.
Kann Edge‑KI ohne Internetzugang arbeiten?
Ja, wenn das Modell, die Vorverarbeitung und die Entscheidungslogik lokal sind. Updates, Synchronisation oder cloud‑abhängige Funktionen können nicht verfügbar sein.
Primäre Referenzen












