
Grundlagen der KI
Was ist erklärbare KI?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Erklärbare KI (XAI) umfasst Methoden und Praktiken, die Menschen dabei helfen, das Verhalten oder die Ausgabe eines KI‑Systems zu verstehen. Eine Erklärung kann einflussreiche Eingaben beschreiben, ein ähnliches Beispiel zeigen, eine kontrafaktische Änderung darstellen, eine globale Regel zusammenfassen oder mitteilen, wann das System keine Antwort hat.
Keine Erklärung ist universell die beste. Ein Entwickler, der ein Modell debuggt, ein Prüfer, der die Einhaltung von Richtlinien testet, und eine von einer Entscheidung betroffene Person benötigen unterschiedliche Belege. Erklärungen müssen daher hinsichtlich Genauigkeit, Bedeutung und beabsichtigter Nutzung bewertet werden – nicht nur nach visueller Attraktivität.
Wesentliche Erkenntnisse
- Transparenz beschreibt verfügbare Informationen; Interpretierbarkeit betrifft die Bedeutung; eine Erklärung kommuniziert Belege oder Gründe.
- Globale Methoden fassen ein Modell zusammen, während lokale Methoden eine einzelne Vorhersage oder einen kleinen Bereich behandeln.
- Nachträgliche Erklärungen können nützlich sein, können jedoch instabil oder dem zugrunde liegenden Modell nicht treu sein.
- Eine Erklärung beweist weder Fairness, Kausalität, Robustheit noch Korrektheit.
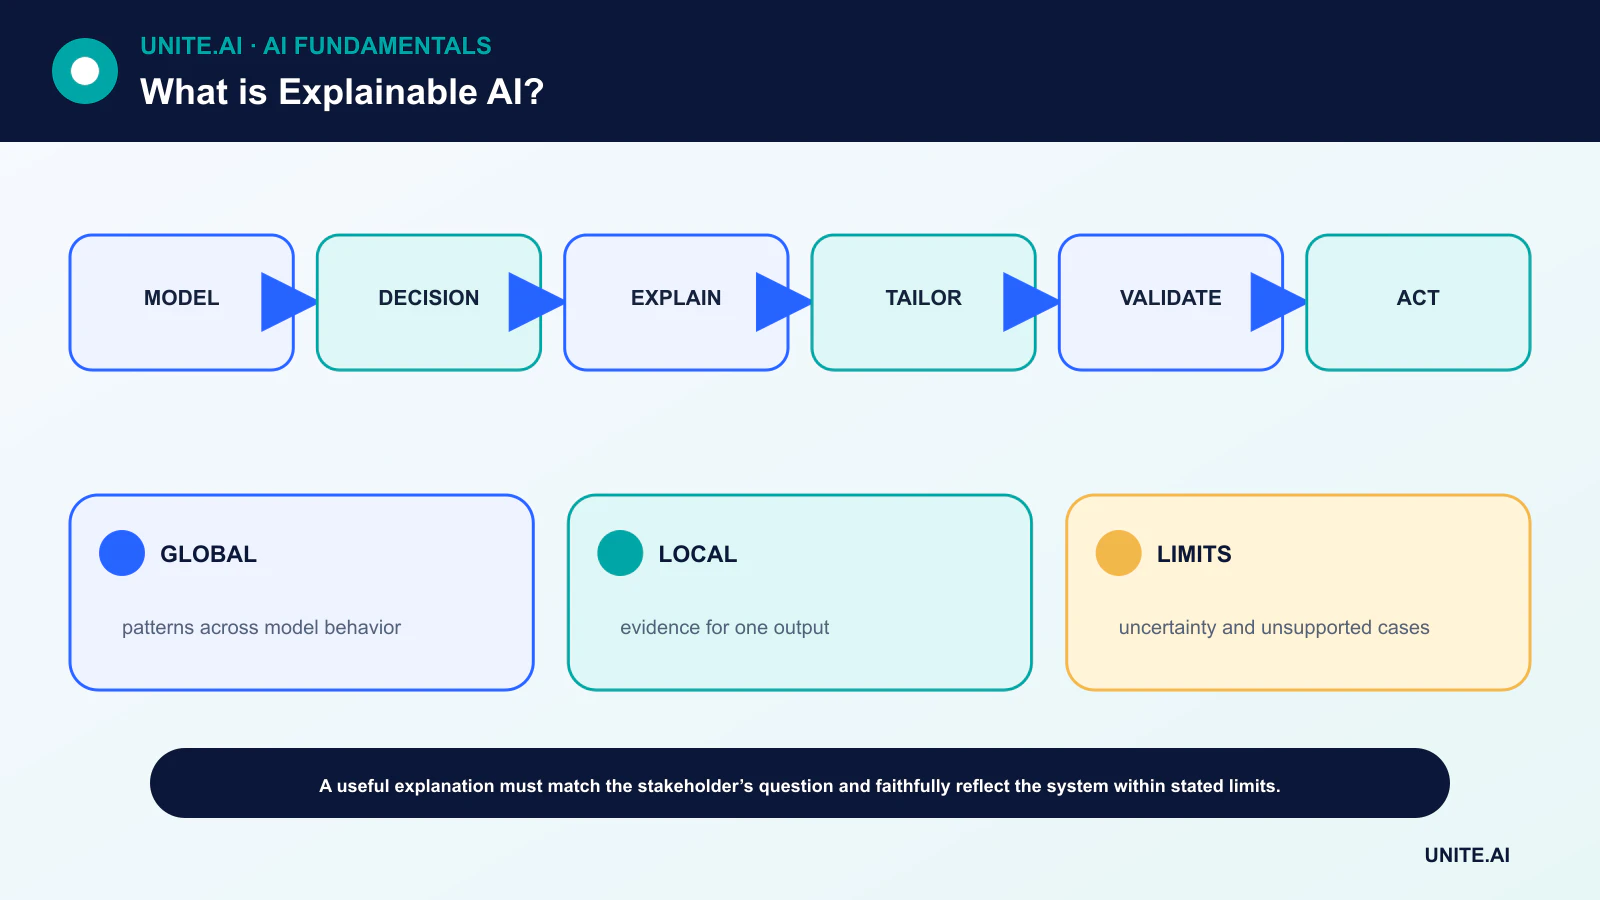
Vier Prinzipien für nützliche Erklärungen
Das NIST schlägt vor, dass ein System eine Erklärung bereitstellt, sie für den vorgesehenen Nutzer sinnvoll macht, sicherstellt, dass sie den Prozess des Systems genau widerspiegelt, und seine Wissensgrenzen kommuniziert. Diese Prinzipien trennen das Vorhandensein einer Erklärung von ihrer Qualität.
Bedeutung ist publikumsabhängig. Ein kurzer Grundcode kann einem Antragsteller helfen, während ein Modell‑Entwickler Verteilungen, Merkmalverhalten und Fehlermuster benötigt. Beide sollten mit demselben dokumentierten System und Entscheidungskontext verbunden sein.
Intrinsische und nachträgliche Methoden
Ein spärliches lineares Modell oder ein eingeschränkter Entscheidungsbaum kann innerhalb seines gültigen Geltungsbereichs direkt interpretiert werden. Ein komplexes Modell kann stattdessen nachträgliche Merkmalzuweisungen, ein lokales Surrogat, Beispiele, Salienz‑Karten oder Kontrafaktiken verwenden.
Intrinsische Einfachheit ist nicht automatisch treu, wenn Merkmale schlecht definiert oder die Pipeline verborgen ist. Nachträgliche Komplexität ist nicht automatisch irreführend. Die Methode muss gegen die Frage getestet werden, die sie beantworten soll.
Merkmalzuweisung und korrelierte Eingaben
Zuweisungsmethoden ordnen Anteile einer Ausgabe expliziten Annahmen nach Eingabemerken zu. LIME passt ein einfaches lokales Surrogat um eine Vorhersage an; SHAP‑ähnliche Verfahren verbinden additive Zuweisungen mit Shapley‑Wert‑Konzepte.
Korrelierte Merkmale können Zuweisungen teilen oder austauschen, und eine hohe Zuweisung ist kein kausaler Effekt. Das isolierte Ändern eines Merkmals kann eine unmögliche Person, ein unmögliches Bild oder eine unmögliche Transaktion erzeugen. Erklärungen sollten ihre Basislinie, Stichproben‑ und Abhängigkeitsannahmen angeben.
Kontrafaktische Erklärungen, Beispiele und globales Verhalten
Ein Kontrafakt stellt die Frage, welche machbare Änderung das Ergebnis verändern würde. Einschränkungen sind essenziell: Eine umsetzbare Erklärung darf keine unveränderlichen, illegalen oder unrealistischen Änderungen empfehlen. Beispielbasierte Verfahren zeigen Prototypen oder einflussreiche Trainingsfälle, können jedoch private Daten preisgeben.
Globale Analysen untersuchen Leistung, partielle Abhängigkeit, Monotonie, Interaktionen und das Verhalten von Untergruppen. Für Ensembles wie Gradient‑Boosting sollten Zusammenfassungen mit lokaler Evidenz und direkten Tests erwarteter Einschränkungen kombiniert werden.
Erklärung und System validieren
Testen Sie Treue, Stabilität bei kleinen Störungen, Konsistenz über äquivalente Eingaben, das Verständnis der Nutzer und ob die Erklärung eine angemessene Entscheidung unterstützt. Adversariale Tests sollten prüfen, ob eine überzeugende Erklärung einem falschen oder manipulierten Ergebnis beiliegt.
XAI ist Teil einer umfassenderen Bewertung: gehaltene Qualitäts‑, Kalibrierungs‑, Fairness‑, Datenschutz‑, Sicherheits‑, Monitoring‑ und Beschwerdemechanismen. Eine Erklärung kann zur Verantwortlichkeit beitragen, sie kann jedoch keine verantwortungsvolle Governance ersetzen.
Zielsetzungen von Erklärungen und Methodenfamilien
Erklärbare KI sollte mit einer Frage und einem Publikum beginnen: warum ein bestimmter Entscheid getroffen wurde, wie das Modell allgemein funktioniert, welche Evidenz ihn beeinflusst hat, was das Ergebnis ändern würde oder ob eine Richtlinie eingehalten wurde. Lokale Erklärungen betreffen eine Vorhersage; globale Erklärungen fassen breiteres Verhalten zusammen. Intrinsisch interpretierbare Modelle zeigen Koeffizienten, Regeln oder Strukturen, während nachträgliche Verfahren komplexe Modelle annähern. Eine Erklärung des Modellverhaltens ist nicht automatisch eine kausale Erklärung der Welt oder ein Nachweis dafür, dass ein Entscheid fair ist.
Methoden der Merkmalzuweisung umfassen Gradienten, integrierte Gradienten, SHAP‑artige Werte, Permutation und lokale Surrogat‑Modelle. Beispielbasierte Erklärungen rufen einflussreiche oder ähnliche Fälle ab; Kontrafaktiken schlagen Änderungen vor, die zu einer anderen Ausgabe führen; Konzept‑Methoden verknüpfen interne Repräsentationen mit menschlichen Kategorien. Jede Methode hat Annahmen zu Basislinien, Merkmalsunabhängigkeit, lokaler Linearität oder Modellzugriff. Korrelationen, Interaktionen und Vorverarbeitung können Zuweisungen instabil oder irreführend machen. Vergleichen Sie Methoden und stören Sie Eingaben, um zu prüfen, ob eine Erklärung das Verhalten vorhersagt.
Bewertung und menschliche Faktoren
Bewerten Sie die Treue – ob die Erklärung mit dem Modell übereinstimmt – getrennt von ihrer Plausibilität für eine Person. Testen Sie Stabilität, Sensitivität, Vollständigkeit, Sparsamkeit und Nützlichkeit für eine definierte Aufgabe wie Debugging oder Beschwerde. Human‑Studien benötigen repräsentative Teilnehmende und sollten Entscheidungsqualität, Fehlerraten, Vertrauen und Zeit messen, nicht ob Nutzer sagen, ein Diagramm sei klar. Eine überzeugende Erklärung kann das Vertrauen in ein falsches Modell erhöhen, daher müssen Oberflächen Unsicherheit, Alternativen und Grenzen anzeigen.
Kontrafaktiken sollten machbar, umsetzbar und nicht das Ändern geschützter oder unveränderlicher Merkmale empfehlen. Erklärungen können Modell‑ oder Personeninformationen leaken und Angreifern beim Reverse‑Engineering von Entscheidungen helfen. Setzen Sie Zugriffskontrollen und Output‑Minimierung ein. Für regulierte oder hochriskante Anwendungen sollten Datenherkunft, Modellversion, Schwellenwert und tatsächliche Entscheidungslogik erhalten bleiben; eine generische Wichtigkeits‑Grafik kann keinen rechtlich bedeutsamen Grund oder eine menschliche Prüfung ersetzen.
Erklärungen verantwortungsbewusst einsetzen
Wählen Sie das einfachste Modell, das Leistung und operative Anforderungen erfüllt, verzichten Sie jedoch nicht auf Validität zugunsten oberflächlicher Interpretierbarkeit. Kombinieren Sie Erklärungen mit Untergruppen‑Tests, Robustheitsprüfungen, kausaler Analyse, wo relevant, und Ergebnis‑Monitoring. Dokumentieren Sie das vorgesehene Publikum und ungültige Schlussfolgerungen. Ändert sich eine Erklärung nach einer harmlosen Störung, untersuchen Sie dies vor dem Rollout. Erklärbarkeit liefert Evidenz über ein System unter einer Methode; sie ist wertvoll für Debugging, Aufsicht und Kommunikation, zertifiziert jedoch weder Wahrheit, Fairness, Sicherheit noch Verständnis.
Praktisches Beispiel: Erklärung eines Kreditrisikomodells
Ein Kreditgeber definiert zunächst das Publikum und den erforderlichen Grund: Antragsteller benötigen genaue Entscheidungsfaktoren und einen Korrekturweg, Entwickler benötigen Diagnosen. Eine kalibrierte, interpretierbare Basis wird mit einem Boosted‑Modell verglichen. Lokale Zuweisungen, Kontrafaktiken und globale Fehleranalysen werden auf Treue, Stabilität, Verhalten korrelierter Merkmale und Nützlichkeit geprüft. Erklärungen dürfen nicht das Alter, Behinderungen oder andere unveränderliche Merkmale ändern und werden nicht als kausale Effekte dargestellt.
Der Produktions‑Entscheidungsdatensatz bewahrt Quelldaten, Merkmalstransformation, Modell, Schwellenwert, Richtlinie und menschliche Aktion. Antragsteller können falsche Daten anfechten und erhalten eine sinnvolle Überprüfung. Monitoring prüft Ergebnis‑ und Erklärung‑Stabilität über Gruppen und Modell‑Updates hinweg. Ändert sich eine plausible Erklärung bei einer harmlosen Merkmalstörung oder fehlt eine entscheidende Richtlinienregel, wird die Bereitstellung gestoppt. Erklärbarkeit ergänzt Validierung und Verfahrensrechte; sie entschuldigt jedoch kein ungültiges Ziel, diskriminierende Ergebnisse oder das Fehlen einer verantwortlichen menschlichen Autorität.
Nachweis der Implementierung und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluations‑Datensatz vor dem Tuning. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie Aufgabenqualität zusammen mit Kalibrierung bzw. Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und jeden Schwellenwert, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout weisen Sie Verantwortlichkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und verifizieren Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabequalität, Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, Gesundheitszustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für Reaktionen, prüfen Sie dann reale Evidenz nach dem Deployment, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Sind Aufmerksamkeitskarten Erklärungen?
Sie können diagnostische Signale sein, aber Aufmerksamkeitsgewichte allein garantieren nicht, dass sie die Gründe für die Ausgabe eines Modells getreu wiedergeben.
Erfordert erklärbare KI ein einfaches Modell?
Nicht immer. Komplexe Modelle können mit nachträglichen Methoden analysiert werden, doch diese Erklärungen benötigen unabhängige Validierung und klar definierte Grenzen.
Primärreferenzen












