
Grundlagen der KI
Was ist Data Science?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Data Science ist die Praxis, Daten in belastbares Wissen, Vorhersagen oder Entscheidungen zu verwandeln. Sie kombiniert Fachwissen, Statistik, Informatik, Daten‑Engineering, Visualisierung und Kommunikation. Ein Modell kann Teil der Arbeit sein, doch die Disziplin beginnt vor dem Modellieren und setzt sich nach der Bereitstellung fort.
Die wichtigste Frage lautet nicht „Welchen Algorithmus sollten wir verwenden?“, sondern „Welche Entscheidung unterstützen wir, welche Evidenz würde sie beantworten und wie erkennen wir, dass das Ergebnis weiterhin nützlich ist?“
Wesentliche Erkenntnisse
- Data Science ist ein End‑to‑End‑Evidenz‑Workflow, kein Synonym für Machine Learning.
- Problemdefinition, Messung und Daten‑Governance bestimmen den Erfolg häufig stärker als die Modellkomplexität.
- Prädiktive und kausale Fragestellungen erfordern unterschiedliche Annahmen und Evaluationsdesigns.
- Eine bereitgestellte Analyse benötigt Monitoring, Dokumentation und Kommunikation, die für die Nutzer angemessen sind.
Beginnen Sie mit einer Entscheidung und einem Estimand
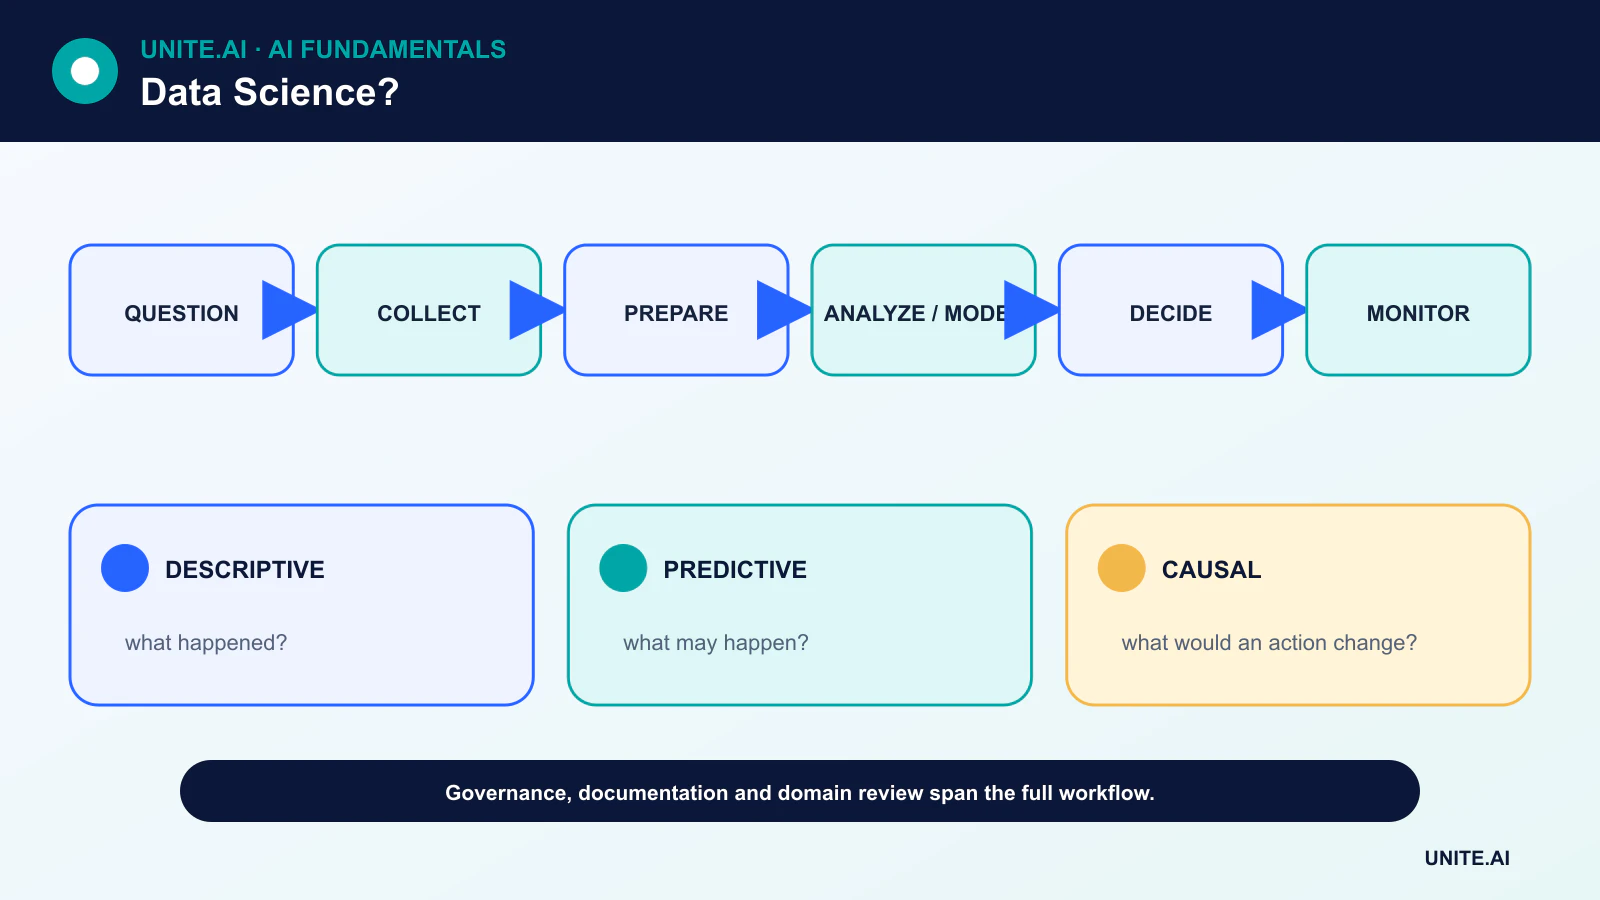
Ein Projekt sollte den Nutzer, die Entscheidung, die Intervention und die Fehlkosten identifizieren. Bei einer beschreibenden Fragestellung kann das Ziel eine Rate oder ein Trend sein. Für Vorhersagen kann es die zukünftige Nachfrage oder das Risiko sein. Bei einer kausalen Fragestellung beschreibt das Estimand die Wirkung einer definierten Intervention unter den angegebenen Annahmen.
Unklare Ziele wie „Erkenntnisse finden“ machen eine Bewertung unmöglich. Ein messbares Ziel schafft eine Grenze für die Datenerhebung und verhindert, dass die Analyse in jedes verfügbare Feld ausdehnt.
Daten sammeln, verwalten und verstehen
Teams erfassen Quellen, Eigentumsverhältnisse, Einwilligungen, Aufbewahrung, Herkunft und Zugriff. Sie unterscheiden strukturierte und unstrukturierte Daten, definieren Einheiten und Zeitstempel und prüfen, ob die Datensätze die relevante Population und den interessierenden Zeitraum repräsentieren.
Datenbereinigung besteht nicht nur darin, fehlende Zeilen zu löschen. Sie umfasst das Auflösen von Duplikaten, unmöglichen Werten, Mehrdeutigkeiten von Labels, Schema‑Drift, Zensur sowie Joins, die die Analyseeinheit ändern. Jede Transformation sollte reproduzierbar und dokumentiert sein.
Erkunden vor dem Modellieren
Explorative Analysen untersuchen Verteilungen, Fehlwerte, Zusammenhänge und mögliche Messartefakte. Visualisierungen können Ausreißer und Untergruppenunterschiede aufdecken, die ein zusammenfassender Durchschnitt verbirgt. Die Exploration sollte Hypothesen informieren, ohne fälschlicherweise als bestätigende Evidenz angesehen zu werden.
Feature‑Engineering, Dimensionalitätsreduktion und Representation‑Learning können das Modellieren verbessern, jedoch müssen Transformationen ausschließlich auf Trainingsdaten angepasst werden, um Datenlecks zu vermeiden.
Methoden passend zur Fragestellung wählen
Statistische Schätzungen quantifizieren die Unsicherheit von interessierenden Kennzahlen. Machine Learning ist nützlich, wenn das Hauptziel die prädiktive Leistung auf neuen Daten ist. Experimente und kausale Inferenzmethoden sind erforderlich, wenn das Ziel ein Interventions‑Effekt ist.
Eine Basislinie sollte so einfach sein, dass sie verständlich ist. Komplexere Modelle müssen ihre zusätzlichen Kosten durch bessere Validierungs‑Performance, kalibrierte Unsicherheit, betrieblichen Nutzen oder eine notwendige Fähigkeit wie Bild‑ oder Sprachverarbeitung rechtfertigen.
Evaluieren, kommunizieren und überwachen
Die Evaluation sollte zur Entscheidung passen. Ein Klassifikator kann Präzision, Recall, Kalibrierung und Untergruppenanalysen benötigen, nicht nur Genauigkeit; ein Prognosesystem erfordert zeitbewusstes Backtesting. Overfitting und Datenlecks sind Prozessfehler, nicht nur Modelleigenschaften.
Kommunikation umfasst Annahmen, Unsicherheit, Einschränkungen und empfohlene Maßnahmen. Sobald ein Modell oder Dashboard genutzt wird, überwachen Teams die Eingabequalität, Ergebnisdrift, Nutzerverhalten und nachgelagerte Auswirkungen. Ein ausgemusterter Entscheidungsprozess benötigt ein Archiv und klare Zuständigkeit, genauso wie ein bereitgestelltes System einen Betreiber erfordert.
Der Data‑Science‑Lebenszyklus und analytische Fragen
Data Science kombiniert Domänenwissen, Statistik, Informatik und Kommunikation, um Daten in Evidenz für Entscheidungen zu verwandeln. Beginnen Sie damit, Beschreibung, Diagnose, Vorhersage und kausale Inferenz zu unterscheiden. Ein Dashboard, das berichtet, was geschehen ist, ein Modell, das vorhersagt, wer abwandern wird, und ein Experiment, das abschätzt, ob eine Intervention die Abwanderung verändert, beantworten unterschiedliche Fragen. Definieren Sie Einheit, Population, Zeitfenster, Ergebnis, Maßnahme und Fehlkosten, bevor Sie Daten extrahieren. Viele gescheiterte Projekte lösen ein messbares Proxy, das die beabsichtigte Entscheidung nicht unterstützen kann.
Die Beschaffung erfordert Herkunftsnachweis, Berechtigungen, Stichprobendesign und einen Datenvertrag. Exploration prüft Verteilungen, Fehlwerte, Duplikate, Ausreißer, Zusammenhänge, Messänderungen und mögliche Lecks. Bereinigungsentscheidungen sind analytische Annahmen: Das Löschen fehlender Zeilen, Imputieren von Werten oder Begrenzen von Ausreißern kann die Population und das Ergebnis verändern. Versionieren Sie Rohdaten unveränderlich und Transformationen als Code und erstellen Sie ein Datenlexikon mit Einheiten und Bedeutungen. Teilen Sie Evaluierungsdaten, bevor Sie Transformationen lernen oder Hypothesen wiederholt testen.
Modellierung, Inferenz und Reproduzierbarkeit
Statistische Inferenz quantifiziert Unsicherheit unter Annahmen; prädiktive Modellierung schätzt die Out‑of‑Sample‑Performance; kausale Analyse erfordert Identifikation durch Design oder vertretbare Annahmen. Wählen Sie Methoden, die zur Fragestellung und zum Daten‑generierenden Prozess passen. Vergleichen Sie mit einfachen Basislinien, nutzen Sie gruppierte oder zeitbewusste Validierung und berichten Sie Unsicherheit sowie Sensitivität. Eine hohe Korrelation oder Feature‑Importance begründet keine Kausalität. Mehrfachtests, Forschenden‑Freiheitsgrade und selektive Berichterstattung können überzeugende Muster erzeugen, daher können Vorregistrierung oder ein klar getrenntes Bestätigungsstadium helfen.
Reproduzierbarkeit umfasst Code, Umgebung, Daten‑Snapshot, Zufalls‑Seeds, Abfrage‑Definitionen und ein Protokoll manueller Entscheidungen. Automatisierte Tests sollten Schemata, geschäftliche Invarianten, Transformationen und Metriken abdecken. Notebooks sind für Exploration wertvoll, aber Produktionsarbeit benötigt modulare, prüfbare Pipelines. Peer‑Review sollte Annahmen, Lecks, Zielvalidität und die Generalisierbarkeit der Ergebnisse hinterfragen. Kommunizieren Sie Effektgrößen, Unsicherheit, Einschränkungen und Gegenbelege, nicht nur statistische Signifikanz oder einen Modell‑Score.
Bereitstellung und Entscheidungswirkung
Wenn Analysen einen wiederkehrenden Prozess steuern, weisen Sie Verantwortliche zu, überwachen Sie die Datenfrische und Ergebnisqualität und definieren Sie Rollback oder Stilllegung. Schützen Sie persönliche und vertrauliche Informationen durch Minimierung, Zugriffskontrolle, Aufbewahrung und sichere Ausgaben. Evaluieren Sie Untergruppeneffekte und wie Nutzer auf das Modell reagieren; Rückkopplungsschleifen können zukünftige Daten verändern. Messen Sie, ob die Entscheidung das eigentliche Ziel verbessert hat, nicht nur, ob ein Modell bereitgestellt wurde. Data Science ist erfolgreich, wenn Evidenz Handlungen zuverlässig und transparent ändert – nicht, wenn eine Organisation Dashboards, Features oder Experimente ohne Zuständigkeit anhäuft.
Praxisbeispiel: Messung einer Retentions‑Intervention
Ein Produktteam beobachtet geringere Retention und definiert einen aktiven Nutzer, Kohorte, Zeitraum, Ausschlüsse und die Entscheidung. Analysten prüfen Instrumentierung, fehlende Ereignisse und Akquisitionsmix vor dem Modellieren. Beschreibende Kohorten identifizieren, wo der Rückgang auftritt, ein prädiktives Modell priorisiert Forschungsteilnehmer, und ein randomisiertes Onboarding‑Experiment schätzt, ob die vorgeschlagene Änderung die Retention verbessert. Dies sind drei unterschiedliche Analysen mit separaten Annahmen und Ergebnissen.
Das Notebook, die Abfragen, der Daten‑Snapshot, die Metrikdefinition und der Versuchsplan sind versioniert und werden von Fachkollegen geprüft. Die Ergebnisse berichten Effektgröße und Unsicherheit mit Leitplanken für Support‑Bedarf und Zugänglichkeit. Ein Dashboard überwacht das Experiment, ersetzt jedoch nicht die vorab deklarierte Analyse. Wenn die Intervention erfolgreich ist, erfolgt die Einführung schrittweise und prüft langfristiges Verhalten. Die Arbeit gilt nur dann als wertvoll, wenn sie eine reproduzierbare Entscheidung unterstützt, nicht weil ein komplexes Modell oder ein visuell ansprechendes Diagramm erstellt wurde.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluationsdatensatz vor dem Tuning. Testen Sie Standardfälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start weisen Sie die Zuständigkeit für Freigabe, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Verwenden Sie eine gestufte Einführung, bewahren Sie ein sicheres Backup und prüfen Sie das Monitoring mit bewusst eingebrachten Fehlfunktionen. Operative Telemetrie sollte Eingabequalität, Ausgabeverhalten, Modell‑ oder Regelversion, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse aufzeigen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für Reaktionen und prüfen Sie dann Evidenz aus der Praxis nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungsprozesse sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Ist Data Science dasselbe wie Data Analytics?
Die Begriffe überschneiden sich. Data Science umfasst häufig den Aufbau von Datenprodukten und prädiktiven Systemen, während Analytics sich stärker auf beschreibende und diagnostische Entscheidungsunterstützung konzentrieren kann. Die Nutzung variiert je nach Organisation.
Benötigt jedes Data‑Science‑Projekt KI?
Nein. Eine gut gestaltete Abfrage, ein Diagramm, ein Experiment oder eine statistische Schätzung kann nützlicher und vertrauenswürdiger sein als ein komplexes Modell.
Primärreferenzen











