
Grundlagen der KI
Was ist ETL? Extrahieren, Transformieren, Laden erklärt

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
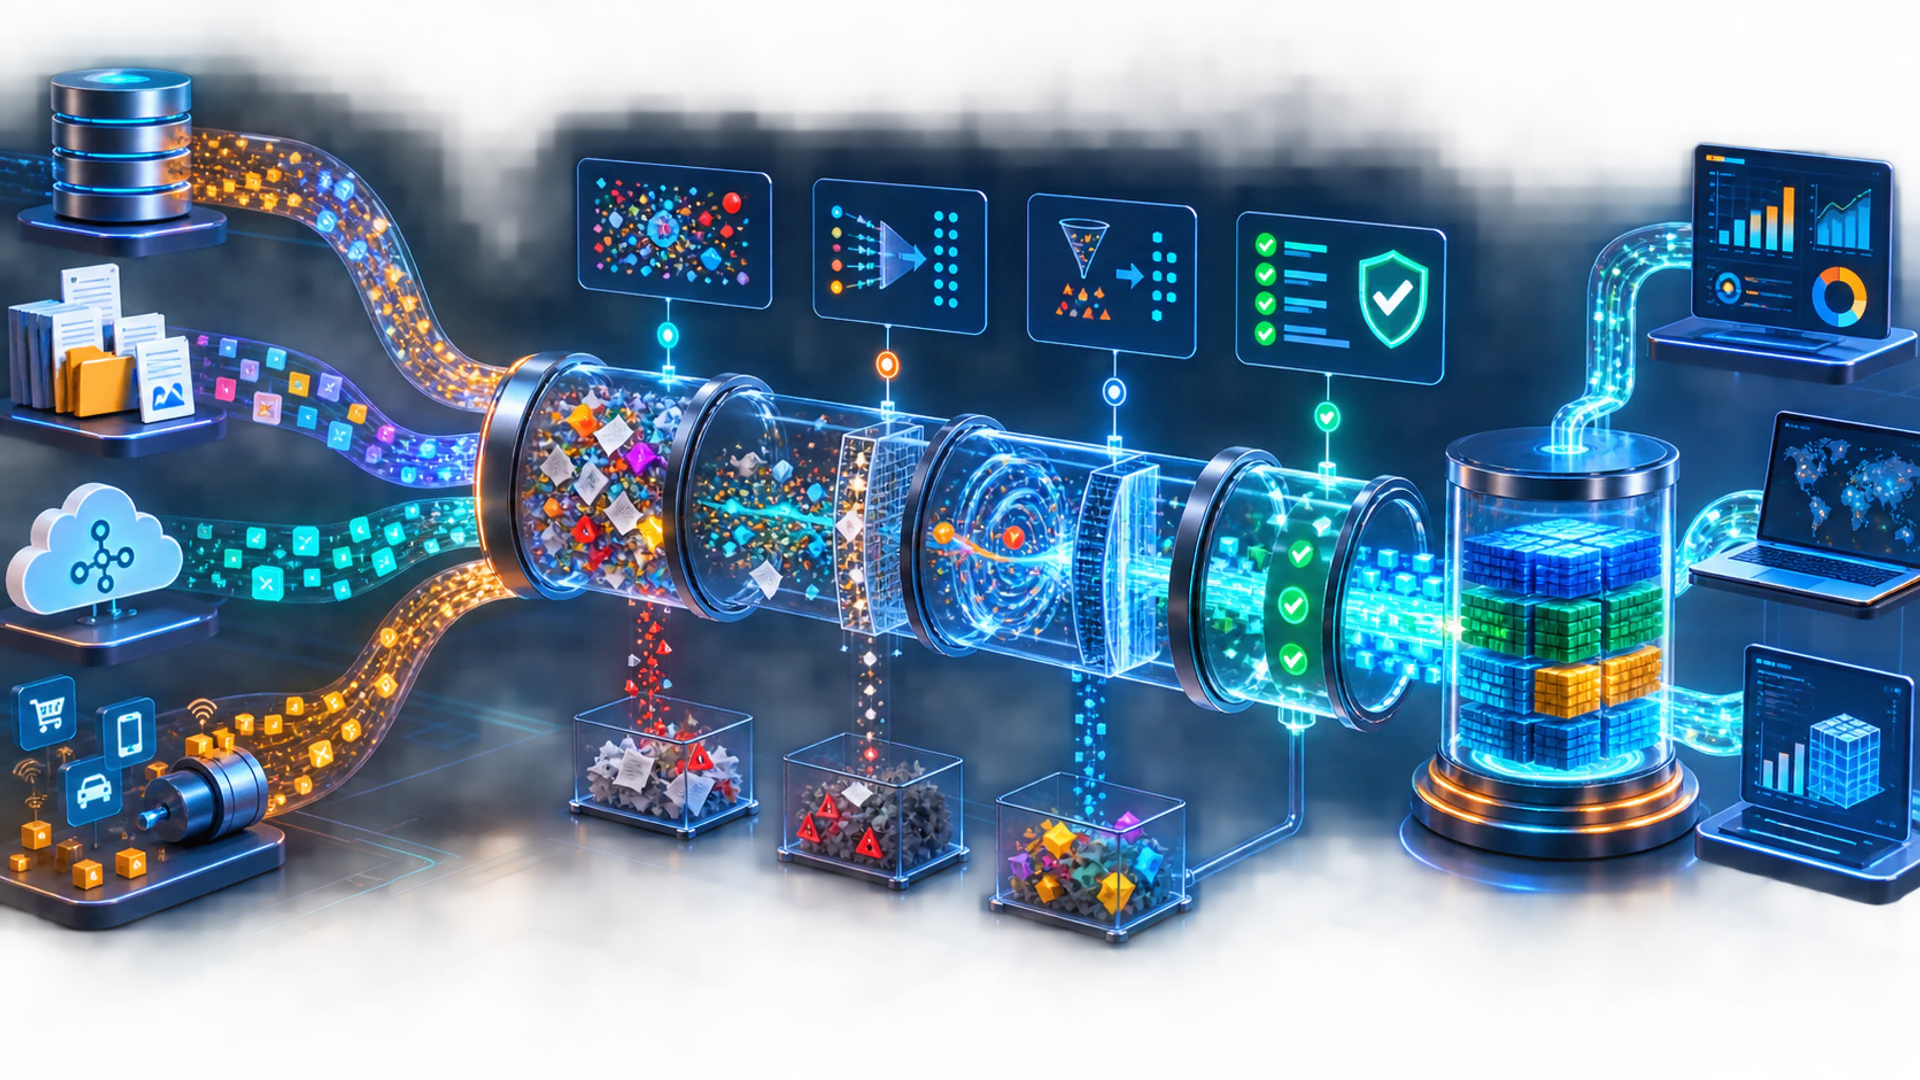
ETL—extract, transform, load—ist ein Datenintegrationsmuster, das Daten aus Quellsystemen liest, sie validiert und umformt und anschließend in ein Ziel schreibt, das für Analysen, Reporting, Machine Learning oder den Betrieb geeignet ist.
Eine produktive ETL‑Pipeline besteht aus mehr als drei Komponenten. Sie erfordert wiederholbare Ausführung, Schema‑ und Qualitätskontrollen, Lineage, Orchestrierung, Beobachtbarkeit, Sicherheit sowie eine sichere Methode zum Nachfüllen oder Wiederholen von Daten, wenn sich die Logik ändert.
Wesentliche Erkenntnisse
- Die Extraktion sollte die Belastung der Quelle minimieren und festhalten, welches Intervall oder welcher Änderungssatz erfasst wurde.
- Transformationen kodieren geschäftliche Bedeutung, daher benötigen sie Versionskontrolle, Tests und Verantwortlichkeit.
- Ladevorgänge sollten idempotent sein oder anderweitig vor Duplikaten und teilweisen Fehlern schützen.
- ETL versus ELT dreht sich hauptsächlich darum, wo die Transformation ausgeführt wird; moderne Systeme nutzen häufig beide Ansätze.
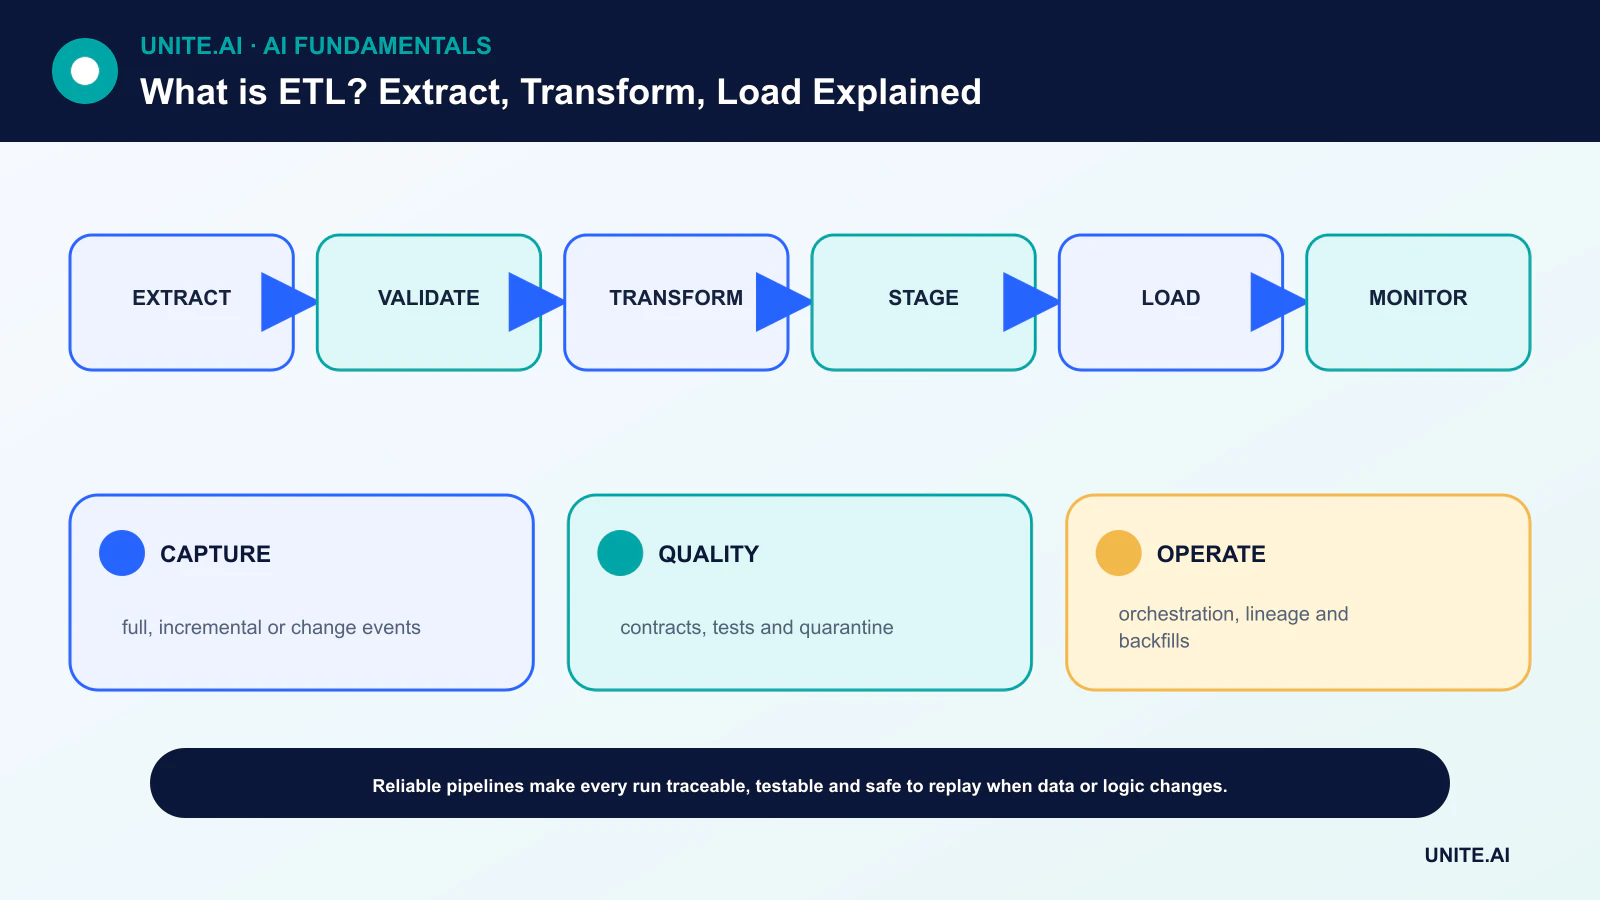
Daten zuverlässig extrahieren
Quellen können Datenbanken, Dateien, APIs, Ereignisströme und Anwendungen umfassen. Ein vollständiger Extrakt kopiert ein komplettes Set; ein inkrementeller Extrakt liest Datensätze, die seit einem Checkpoint geändert wurden. Change‑Data‑Capture nutzt Datenbank‑Logs oder Ereignisse, um wiederholte Scans zu reduzieren.
Protokollieren Sie Quell‑IDs, Zeitgrenzen und Checkpoints. Beachten Sie Rate‑Limits und Transaktionssemantik. Ändert eine Quelle das Schema stillschweigend, brechen Sie sicher ab oder setzen Sie Datensätze in Quarantäne, anstatt mehrdeutige Daten zu laden, als wäre nichts geschehen.
Transformation mit expliziten Verträgen
Transformationen standardisieren Typen und Einheiten, parsen Datensätze, joinen Quellen, entfernen oder markieren Duplikate, wenden Geschäftsregeln an und berechnen Features. Trennen Sie ungültige Daten von fehlenden, aber akzeptablen Daten und bewahren Sie genügend Nachweise, um ein Ergebnis zu seinen Eingaben zurückzuverfolgen.
Versionieren Sie Transformationen auf dieselbe disziplinierte Weise wie die Software‑Auslieferung. Tests sollten Schema, Wertebereiche, referentielle Integrität, erwartete Verteilungen und bekannte Beispiele abdecken. Ein Datenvertrag definiert Erwartungen zwischen Produzent und Konsument.
Sicheres und wiederholbares Laden
Ein Ladevorgang kann Ereignisse anhängen, geänderte Datensätze zusammenführen, eine Partition ersetzen oder eine Tabelle neu aufbauen. Idempotenz bedeutet, dass das erneute Ausführen derselben Eingabe denselben Zielzustand erzeugt. Transaktionen, Staging‑Tabellen und atomare Swaps reduzieren das Risiko teilweiser Updates.
Partitionierung und Indizierung sollten den Zugriffsmustern entsprechen. Schützen Sie sensible Felder und wenden Sie Ziel‑Berechtigungen an, bevor Daten abfragbar werden. Aufbewahrungs‑ und Löschanforderungen müssen mit den Daten mitgeführt werden.
ETL, ELT, Batch und Streaming
Traditionelles ETL transformiert in einer separaten Engine, bevor es lädt. ELT lädt zunächst Roh‑ oder leicht verarbeitete Daten und nutzt dann die Rechenleistung des Ziels für die Transformation. Ein Cloud‑Data‑Warehouse oder Lakehouse kann ELT praktisch machen, aber es eliminiert nicht die Arbeit an Qualität oder Governance.
Batch‑Pipelines verarbeiten begrenzte Intervalle; Streaming‑Pipelines verarbeiten fortlaufende Ereignisse mit definierten Zeit‑ und Ordnungssemantiken. Viele Architekturen nutzen Streaming‑Ingestion gefolgt von periodischer Rekonsiliation, da späte oder korrigierte Daten normal sind.
Orchestrierung, Lineage und Beobachtbarkeit
Ein Orchestrator plant Aufgaben, beachtet Abhängigkeiten, wiederholt definierte Fehler und protokolliert den Zustand. Wiederholungen benötigen Grenzen und idempotente Aufgaben. Backfills sollten isoliert und kapazitätsbewusst sein, damit historische Korrekturen die aktuellen Daten nicht stören.
Überwachen Sie Aktualität, Volumen, Schema, Qualität, Dauer und Kosten. Lineage und die Metadaten‑Schicht eines Data‑Fabric helfen Konsumenten zu verstehen, welche Version einen Datensatz erzeugt hat und was upstream fehlschlug.
Extraktion: Quellen, Verträge und inkrementelle Erfassung
ETL verschiebt Daten von Quellsystemen, transformiert sie in gesteuerte Strukturen und lädt ein Ziel. Die Extraktion kann Dateien, Datenbankabfragen, APIs, Logs, Streams oder Change‑Data‑Capture nutzen. Definieren Sie Quell‑Eigentum, Schema, Schlüssel, Zeitstempel, Zeitzone, Einheiten, Löschsemantik und zulässige Ladeparameter. Vollständige Extrakte sind einfach, aber kostenintensiv; inkrementelle Erfassung reduziert das Volumen, erfordert jedoch Wasserzeichen, Log‑Positionen oder Versionsfelder sowie eine Strategie für späte und korrigierte Datensätze.
Gehen Sie nicht davon aus, dass ein erfolgreicher API‑Aufruf einen vollständigen Extrakt bedeutet. Protokollieren Sie Datensätze, Prüfsummen, Sequenzlücken, Paginierung, Rate‑Limits, Wiederholungen und Quell‑Snapshots. Speichern Sie unveränderliche Rohdaten, wo die Richtlinie es erlaubt, damit Transformationen wiederholt werden können. Schützen Sie Anmeldedaten und sensible Felder und stellen Sie Wiederholungen idempotent sicher. Schema‑Änderungen sollten über Verträge als kompatibel oder brechend klassifiziert werden, statt erst entdeckt zu werden, wenn ein nachgelagertes Dashboard stillschweigend ändert.
Transformieren und Laden mit reproduzierbaren Semantiken
Transformationen parsen Typen, standardisieren Einheiten, deduplizieren, joinen, wenden Geschäftsregeln an, verwalten Historie und leiten Fakten sowie Dimensionen ab. Jede Regel benötigt Tests und Lineage. Statistische Vorverarbeitung sollte nur auf geeigneten Trainingsdaten erfolgen, wenn ETL ML speist. Langsam ändernde Dimensionen bestimmen, ob Attributänderungen überschreiben oder Historie bewahren. Definieren Sie die Faktgranularität vor dem Join; Many‑to‑Many‑Fehler erzeugen duplizierte Kennzahlen, die einfache Zeilenprüfungen überstehen können.
Laden kann Anhängen, Zusammenführen, Ersetzen von Partitionen oder Aktualisieren von Datensätzen umfassen. Nutzen Sie nach Möglichkeit Staging‑Tabellen und atomare Swaps, damit Leser keinen Teilzustand sehen. Erzwingen Sie Eindeutigkeit, Beziehungen, zulässige Werte, Vollständigkeit und geschäftliche Invarianten. Handhaben Sie späte Ereignisse und Backfills mit Ereigniszeit und versioniertem Code. Die Rekonsiliation mit Quell‑Summen ist für Finanz‑ und Betriebsdaten unerlässlich. ELT lädt Rohdaten vor der Transformation im Ziel; die Governance‑ und Korrekturanforderungen bleiben bestehen.
Betrieb und Wiederherstellung
Orchestrierung verwaltet Abhängigkeiten, Zeitpläne, Wiederholungen, Parallelität und Alarme. Überwachen Sie Aktualität, Volumen, Qualität, Dauer, Kosten und nachgelagerten Einfluss. Ein fehlgeschlagener Job sollte ohne Duplikate fortgesetzt oder wiederholt werden können. Versionieren Sie Code und Schemas, erhalten Sie Lineage und testen Sie Backfills isoliert. Disaster‑Recovery umfasst Rohdaten, Kataloge, Berechtigungen, Orchestrierungs‑Zustand und semantische Definitionen. ETL ist vertrauenswürdig, wenn ein Nutzer eine Kennzahl zu den Quellen zurückverfolgen und nach einer Änderung reproduzieren kann – nicht nur, wenn eine grüne Pipeline abgeschlossen wurde.
Praktisches Beispiel: Eine inkrementelle Bestell‑Pipeline
Ein ETL‑Job liest Datenbank‑Change‑Logs für Bestellungen und Artikel, speichert unveränderliche Ereignisse, validiert Sequenz und Schema und merged sie in eine Warehouse‑Fact‑Tabelle mit einer Granularität pro Bestellposition. Ereigniszeit und Update‑Version behandeln späte Korrekturen; deterministische Schlüssel machen das Wiederholen idempotent. Dimensionen bewahren ausgewählte Kunden‑ und Produkt‑Historie über Surrogatschlüssel. Zeilenzahlen, Bestellsummen, Steuern, Rückgaben und Stornierungen werden mit den Quell‑Perioden abgeglichen.
Eine brechende Quellfeld‑Änderung stoppt die Promotion zu vertrauenswürdigen Tabellen und alarmiert Eigentümer über nachgelagertes Lineage. Backfills laufen mit versioniertem Code isoliert und werden vor einem atomaren Swap verglichen. Die Zugriffspolicy beschränkt Kunden‑IDs, und Löschungen werden auf zulässige abgeleitete Kopien propagiert. Monitoring deckt Aktualität, Volumen, Qualität, Kosten und Dashboard‑Einfluss ab. Wiederherstellungstests bauen eine Periode aus Rohereignissen neu auf und stellen den Orchestrierungs‑Zustand wieder her. Ein grüner Scheduler reicht nicht aus, solange geschäftliche Kennzahlen nicht reproduzierbar und abgeglichen bleiben.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabendqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout weisen Sie die Zuständigkeit für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und verifizieren Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, die Modell‑ oder Regel‑Version, den Gesundheitszustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse aufzeigen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie reale Evidenz nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Incidents, Lösch‑ und Aufbewahrungs‑Prozeduren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist ETL in Cloud‑Datenplattformen veraltet?
Nein. Einige Plattformen bevorzugen ELT, aber die Aufgaben der Extraktion, Transformation und des Ladens bestehen weiterhin. Teams kombinieren häufig beide Muster.
Was macht eine ETL‑Pipeline idempotent?
Sie kann dieselbe Eingabe sicher erneut verarbeiten, ohne duplizierten oder inkonsistenten Zielzustand zu erzeugen, typischerweise durch stabile Schlüssel, Checkpoints und transaktionale Schreibvorgänge.
Primärreferenzen












