Grundlagen der KI
Was ist ein Data Warehouse? Architektur, ETL und Anwendungsfälle

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
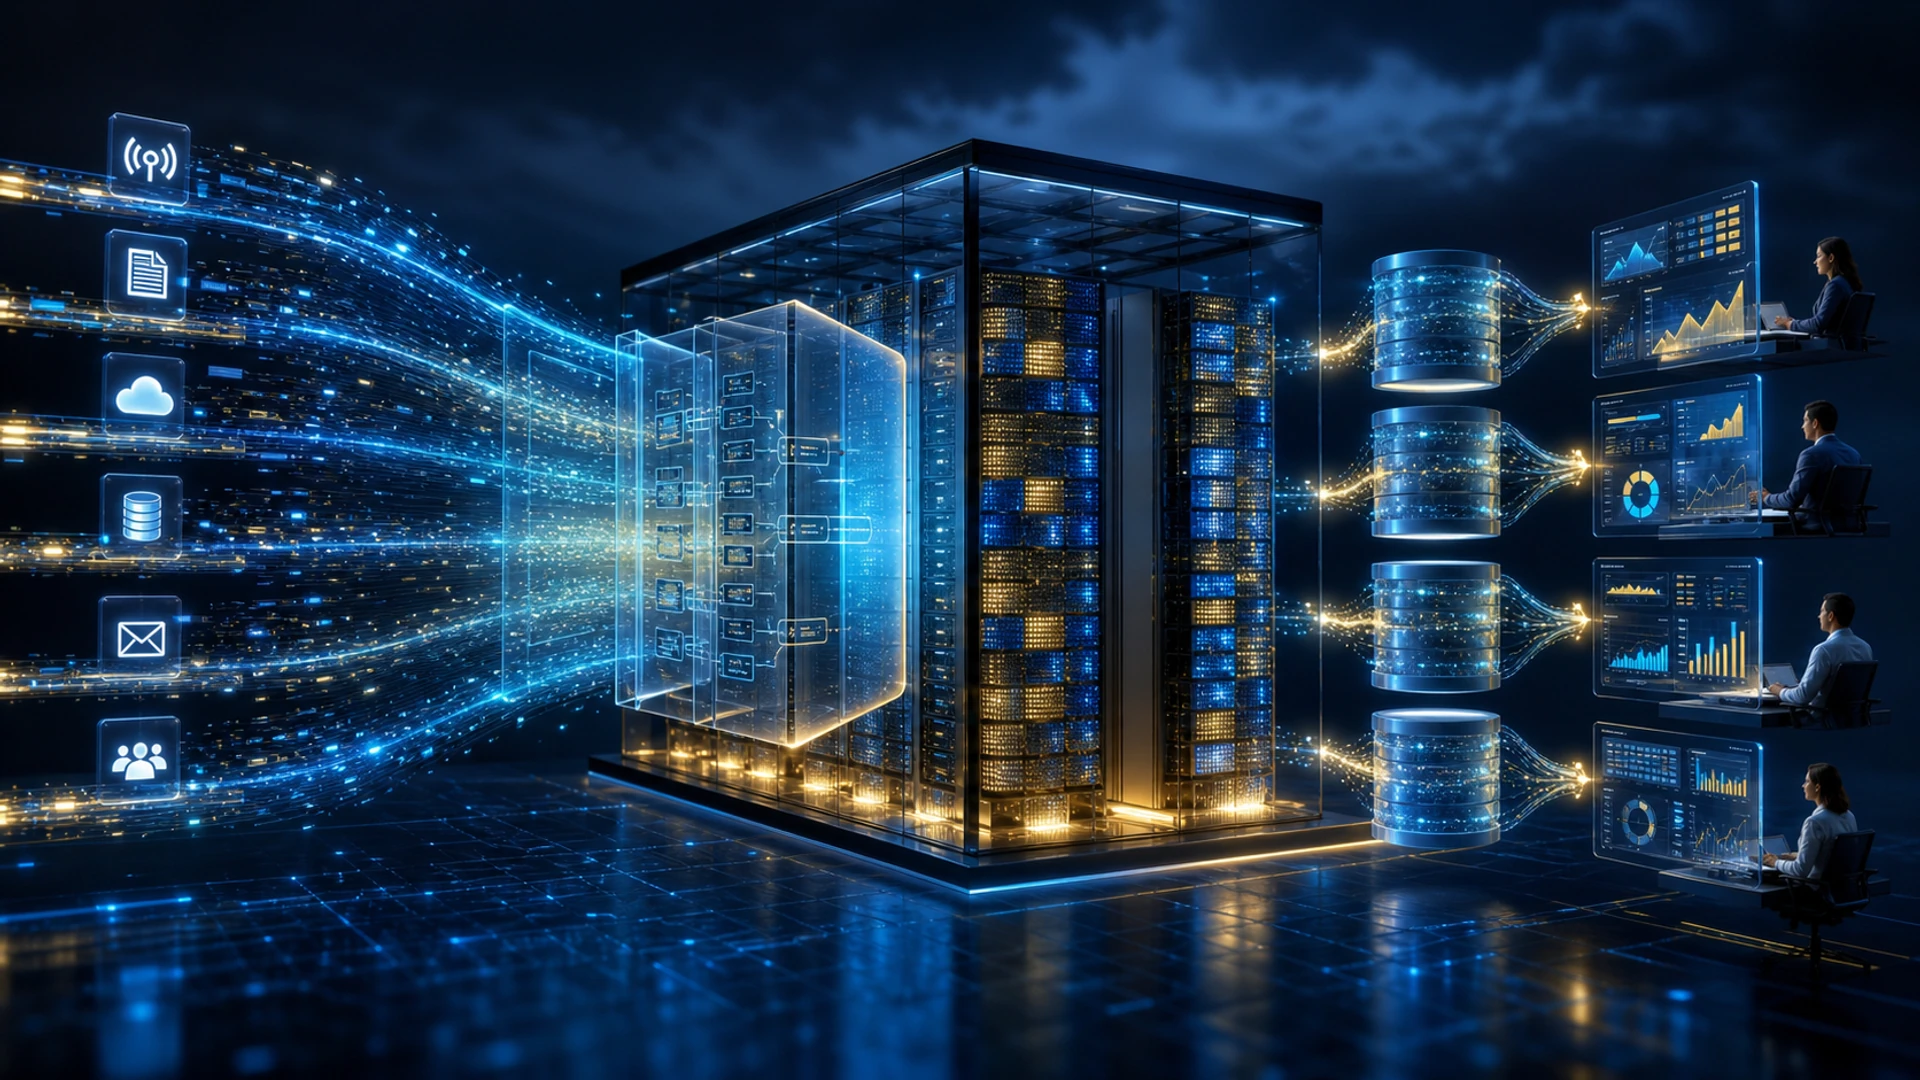
Ein Data Warehouse ist ein analytisches Datensystem, das Informationen aus operativen Quellen integriert und für Reporting, Business Intelligence und wiederholbare Analysen aufbereitet. Es trennt viele analytische Arbeitslasten von den Anwendungen, die Transaktionen aufzeichnen.
Moderne Warehouses können spaltenbasiert, verteilt, serverlos oder an Objektspeicher angebunden sein. Die wesentlichen Aufgaben bleiben konsistent: gesteuerte Datenaufnahme, modellierte Bedeutung, Historie, Abfrageleistung, Sicherheit, Qualität und zuverlässige Bereitstellung für Nutzer.
Wesentliche Erkenntnisse
- Operative Systeme optimieren aktuelle Transaktionen; Warehouses optimieren historische Analysen über verschiedene Quellen.
- ETL transformiert vor dem Laden, während ELT zuerst lädt und innerhalb der analytischen Plattform transformiert.
- Dimensionale, normalisierte und Wide‑Table‑Modelle bedienen unterschiedliche Arbeitslasten und Governance‑Anforderungen.
- Vertrauen hängt von Datenherkunft, Tests, Aktualität, Zugriffskontrolle, semantischen Definitionen und Kostenüberwachung ab.
Quellen, Datenaufnahme und Speicherung
Daten können über Batches, Change‑Data‑Capture, Streams, Dateien und APIs eintreffen. Eine Landing‑Schicht bewahrt den Quellkontext; Transformationen standardisieren Typen, deduplizieren Datensätze, behandeln verspätete Ereignisse und erzeugen wiederverwendbare analytische Entitäten.
Dies erweitert den ETL-Workflow. ELT nutzt die Rechenleistung des Warehouses für Transformationen, während ETL Daten vor dem Laden reduzieren oder validieren kann. Die richtige Wahl hängt von Latenz, Datenschutz, Skalierung und Toolchain ab.
Datenmodellierung für Fragen
Dimensionale Modelle ordnen messbare Fakten um beschreibende Dimensionen wie Kunde, Produkt und Zeit. Normalisierte Kernmodelle können Unternehmensbeziehungen bewahren, während denormalisierte Marts gängige Abfragen vereinfachen.
Eine semantische Schicht liefert konsistente Definitionen für Kennzahlen. Ohne sie können Teams mehrere plausibel aussehende Umsatz‑ oder Retentionszahlen aus denselben Zeilen erzeugen. Structured data erfordert weiterhin eine abgestimmte Bedeutung.
Warehouse, Lake und Lakehouse
Ein Data Lake speichert typischerweise Dateien und vielfältige Roh‑ oder verarbeitete Daten im Objektspeicher. Ein Warehouse stellt verwaltete analytische Tabellen und Abfragedienste bereit. Lakehouse‑Designs fügen dem Lake‑Speicher Tabellmetadata, Transaktionen und Governance hinzu.
Dies sind Architektur‑Muster, keine Garantien. Organisationen kombinieren sie häufig über ein data fabric oder eine gemeinsame Governance‑Schicht. Arbeitslast, Fachkenntnisse, Interoperabilität und Lebenszykluskosten sind wichtiger als die Bezeichnung.
Qualität, Sicherheit und Betrieb
Definieren Sie Eigentümer, Verträge, Aktualitätsziele, Datenherkunft, Tests, Aufbewahrung und Zeilen‑ oder Spaltenzugriff. Trennen Sie personenbezogene Daten, verwenden Sie das Prinzip der minimalen Rechte und prüfen Sie sensible Abfragen. Backfills und Schema‑Änderungen erfordern kontrollierte, nachvollziehbare Verfahren.
Messen Sie erfolgreiche Aktualisierungen, Datenverzögerungen, Testfehler, Abfrageleistung, Akzeptanz, Vorfallauswirkungen und Kosten pro Arbeitslast. Ein Warehouse ist nützlich, wenn Nutzer eine Kennzahl bis zu den gesteuerten Daten zurückverfolgen und das Ergebnis reproduzieren können.
Dimensionale Modellierung und Semantik
Eine Faktentabelle erfasst Ereignisse oder periodische Messungen auf einer festgelegten Granularität, z. B. eine Bestellposition oder ein Gerät pro Stunde. Dimensionen liefern beschreibenden Kontext. Die Granularität vor der Auswahl von Spalten zu deklarieren verhindert das Mischen von Ebenen, das zu Doppelzählungen führt. Additive Kennzahlen können über alle Dimensionen summiert werden; semi‑additive Kennzahlen erfordern im Zeitverlauf besondere Vorsicht.
Surrogatschlüssel entkoppeln die Warehouse‑Historie von wechselnden Quell‑Identifikatoren. Slowly‑Changing‑Dimensions bestimmen, wie Attributänderungen gehandhabt werden: überschreiben, eine neue historische Zeile anlegen oder begrenzte frühere Werte behalten. Die richtige Methode richtet sich nach der analytischen Fragestellung und den Aufbewahrungspflichten.
Eine semantische Kennzahl sollte Formel, Filter, zeitliches Verhalten, Währung, Ausschlüsse, Eigentümer und Tests definieren. Zentrale Definitionen reduzieren Inkonsistenzen, doch die Governance sollte vorgeschlagene Änderungen und Versionierung zulassen. Eine einzelne semantische Schicht wird zum Engpass, wenn Nutzer sie nicht verantwortungsvoll prüfen oder erweitern können.
Moderne Speicher‑ und Abfragearchitektur
Spaltenbasierter Speicher hält die Werte einer Spalte zusammen, verbessert die Kompression und scannt nur benötigte Felder. Partitionierung schneidet große Abschnitte nach Datum oder anderem Schlüssel ab; Clustering ordnet verwandte Werte nebeneinander; materialisierte Sichten und Caches nutzen Ergebnisse erneut. Schlechte Partitionierungsentscheidungen erzeugen winzige Dateien, Skew oder teure Vollscans.
Massiv parallel arbeitende Abfrage‑Engines verteilen Scans, Joins und Aggregationen auf mehrere Worker. Datenbewegungen während Joins können die Laufzeit dominieren, daher sind Verteilung, Statistiken und Join‑Reihenfolge wichtig. Autoscaling und serverlose Dienste vereinfachen die Kapazitätsplanung, erfordern jedoch Kostenkontrollen, Priorisierung von Arbeitslasten und Begrenzungen für unkontrollierte Abfragen.
Lakehouse‑Tabellenformate fügen Metadaten, Snapshots, Schema‑Evolution und Transaktionssemantik zu Objektdateien hinzu. Sie verbessern die Interoperabilität, bringen jedoch Katalog‑ und Wartungsverantwortungen mit sich. Offene Formate reduzieren Bindungen nur, wenn Rechen‑Engines, Governance und Betriebsabläufe sie tatsächlich nutzen können.
Zuverlässige Pipelines und Datenprodukte
Pipelines sollten idempotent sein oder Duplikate auflösen können. Wasserzeichen und Ereigniszeit behandeln verspätete Ankünfte; Backfills reproduzieren historische Transformationen; Schema‑Verträge definieren kompatible Änderungen. Datentests prüfen Einzigartigkeit, Vollständigkeit, zulässige Werte, Beziehungen und geschäftliche Invarianten – nicht nur, ob ein Job ausgeführt wurde.
Behandeln Sie wichtige Datensätze als Produkte mit Eigentümern, Dokumentation, Service‑Erwartungen, Auffindbarkeit, Support und Nutzern. Datenherkunft verbindet Quellfelder über Transformationen zu Berichten, wodurch Auswirkungen von Änderungen und Incident‑Untersuchungen schneller werden. Zugriffspolicen sollten sich bei Datenkopien fortsetzen oder neu bewertet werden.
Ein Warehouse‑Programm ist erfolgreich, wenn Entscheidungen zuverlässiger und schneller werden, nicht wenn das Speicher‑Volumen wächst. Stilllegen Sie ungenutzte Tabellen, machen Sie Abfrage‑ und Speicherkosten transparent, prüfen Sie sensible Zugriffe und messen Sie, ob Teams gesteuerte Kennzahlen vertrauen und wiederverwenden, anstatt private Tabellenkalkulationen zu pflegen.
Praktisches Beispiel: Entwurf eines Vertriebs‑Analyse‑Warehouses
Definieren Sie die Faktengröße als eine abgeschlossene Bestellposition und verknüpfen Sie anschließend Produkt-, Kunden-, Kanal-, Promotions-, Geografie‑ und Datums‑Dimensionen über Surrogatschlüssel. Halten Sie Bestellstatus‑Ereignisse in einer separaten Faktentabelle, anstatt Snapshots und Transaktionen zu mischen. Umsatz, Menge, Rabatt, Steuer und Kosten benötigen eindeutige Währungs-, Rückgabe‑, Stornierungs‑ und Erfassungsregeln. Die Kennzahldefinition sollte dieselbe Antwort in Dashboards, Notebooks und Finanzabstimmungen liefern.
Die Datenaufnahme erfasst Quelländerungen, legt unveränderliche Rohdaten ab, validiert das Schema und transformiert sie in getestete Staging‑ und Dimensionen‑Modelle. Verspätete Updates müssen den entsprechenden historischen Zeitraum korrigieren, ohne Fakten zu duplizieren. Vergleichen Sie Zeilenzahlen und Geldbeträge mit den Quellsystemen, testen Sie Einzigartigkeit und Beziehungen und protokollieren Sie die Datenherkunft vom Berichtsfeld zur Quelle. Backfills nutzen versionierten Code und isolierte Validierung, bevor vertrauenswürdige Tabellen ersetzt werden.
Der Zugriff trennt Kunden‑Identifikatoren von breit verfügbaren Aggregaten und wendet das Prinzip der minimalen Rechte nach Rolle und Zweck an. Das Workload‑Management hält Executive‑Dashboards reaktionsfähig, während Analysten explorative Abfragen ausführen. Überwachen Sie Aktualität, fehlgeschlagene Tests, Abfragekosten, ungenutzte Tabellen und semantische Änderungen. Ein Warehouse ist erfolgreich, wenn gesteuerte Kennzahlen wiederholbare Entscheidungen unterstützen; das bloße Zentralisieren von Daten kann Verwirrung zentralisieren, wenn Eigentümerschaft, Qualität und Definitionen ungelöst bleiben.
Die Notfallwiederherstellung sollte Backup‑Abdeckung, regionenübergreifende Kopien, Katalog‑ und Berechtigungswiederherstellung, akzeptablen Datenverlust und Wiederherstellungszeit festlegen. Testen Sie die Wiederherstellung in einer isolierten Umgebung und prüfen Sie Kennzahlen, nicht nur Dateien. Verschlüsselungsschlüssel, Identitätskonfiguration, Orchestrierungs‑Code und semantische Definitionen gehören zum wiederherstellbaren System. Ein Warehouse, das Petabytes wiederherstellen kann, aber die Zugriffspolicy oder vertrauenswürdige Berechnungen nicht reproduzieren kann, hat seinen analytischen Service nicht wiederhergestellt.
Praktische Implementierungs‑Checkliste
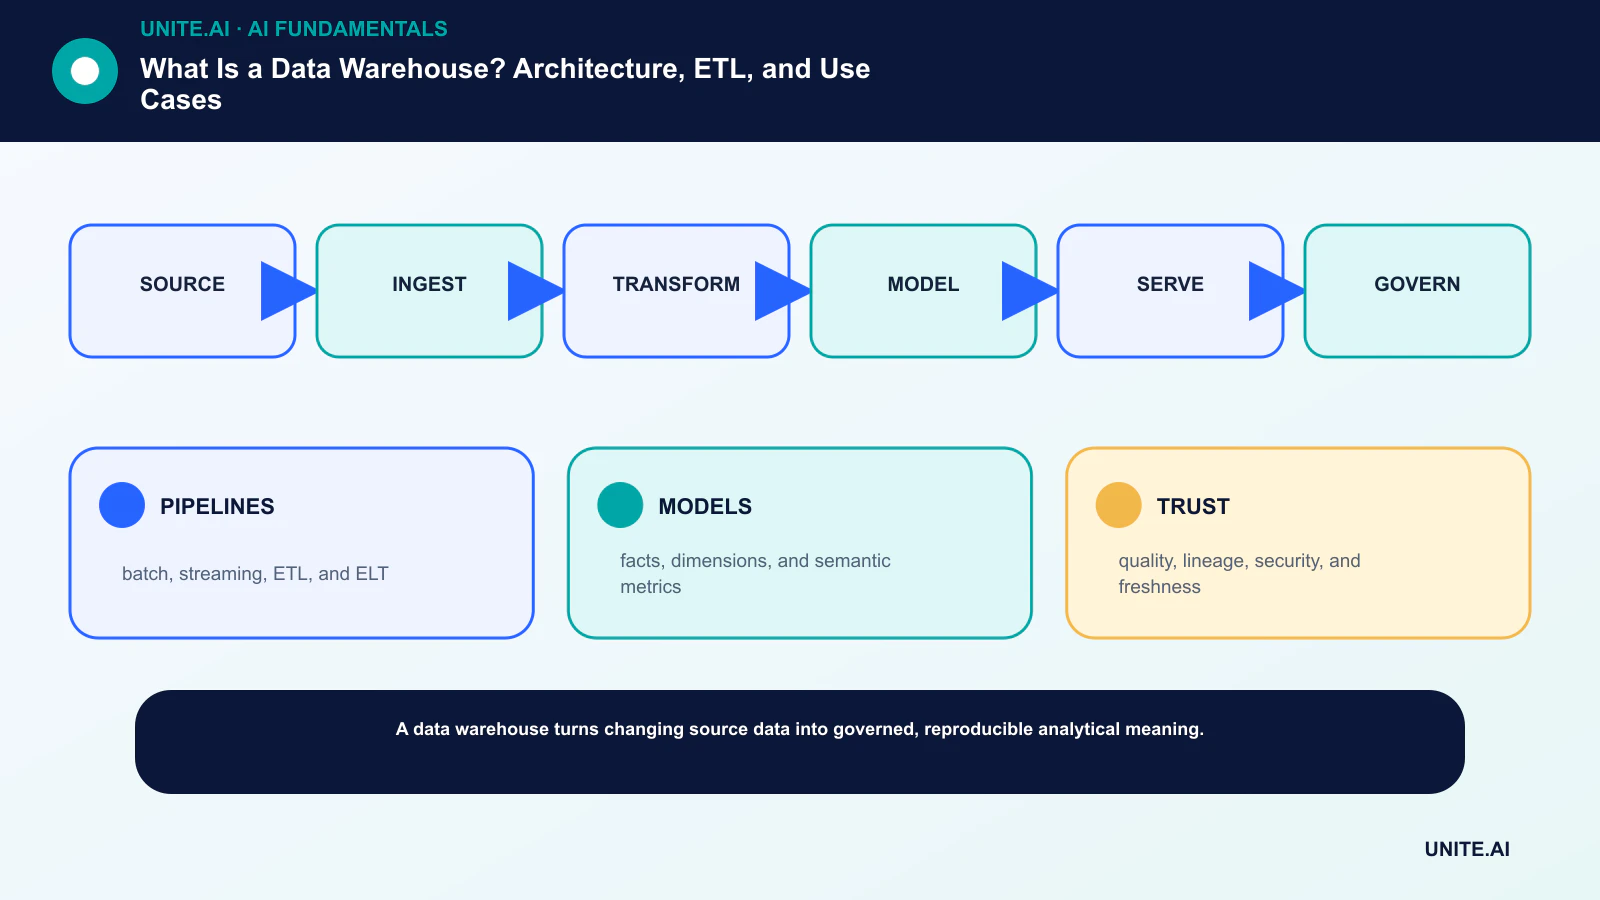
Verwandeln Sie das Konzept in einen abgegrenzten, testbaren Workflow: source → ingest → transform → model → serve → govern. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie die Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, setzen Sie Akzeptanz‑ und Abbruchkriterien, testen Sie repräsentative Fehler und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Readiness‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Abhängigkeits‑Fehler und Missbrauch; bewahren Sie die Beweise und offenen Risiken. Definieren Sie, wer die Freigabe genehmigen, Schwellenwerte ändern, Ausgaben überschreiben oder den Betrieb stoppen darf. Überprüfen Sie die Entscheidung erneut, sobald reale Daten eintreffen, da ein technisch erfolgreicher Pilot keine zuverlässige Leistung im größeren Maßstab garantiert.
- PIPELINES: Batch, Streaming, ETL und ELT.
- MODELS: Fakten, Dimensionen und semantische Kennzahlen.
- TRUST: Qualität, Datenherkunft, Sicherheit und Aktualität.
Häufig gestellte Fragen
Ist ein Data Warehouse nur eine große Datenbank?
Es ist eine Datenbank oder analytische Plattform, die für integrierte, historische Analysen konzipiert ist. Ihr Modellierungs‑, Aufnahme‑, Governance‑ und Arbeitslast‑Muster unterscheiden sich von einer transaktionalen Anwendungsdatenbank.
Sollte ein Unternehmen ETL oder ELT verwenden?
Viele nutzen beide. Transformieren Sie früh, wenn Datenschutz, Validierung oder Bandbreite es erfordern; transformieren Sie nach dem Laden, wenn die Rechenleistung des Warehouses und schnelle Iterationen vorteilhaft sind.
Primärreferenzen