
Grundlagen der KI
Was ist Computer Vision?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Computer vision ist das Fachgebiet, das Systeme entwickelt, die nützliche Informationen aus Bildern und Videos extrahieren. Ein Vision‑Modell kann ein ganzes Bild klassifizieren, Objekte lokalisieren, jeden Pixel labeln, Text lesen, Pose schätzen, Bewegung verfolgen oder visuellen Inhalt mit Sprache verbinden.
Moderne Vision‑Systeme reproduzieren nicht einfach den frühen Kantenerkennungsprozess der menschlichen Wahrnehmung. Sie lernen aufgabenspezifische Darstellungen aus Daten, häufig unter Verwendung von convolutional neural networks, vision transformers oder multimodalen foundation models.
Key takeaways
- Klassifikation, Detektion, Segmentierung, OCR, Tracking und Generierung sind unterschiedliche Vision‑Aufgaben.
- CNNs integrieren Lokalität und Gewichtsteilung; Vision‑Transformer nutzen Attention über Bild‑Patches.
- Labels können von Menschen, schwacher Aufsicht, synthetischen Daten oder selbstüberwachten Zielen stammen.
- Genauigkeit allein ist unzureichend: Robustheit, Latenz, Datenschutz, Verzerrungen und Fehlkosten sind wichtig.
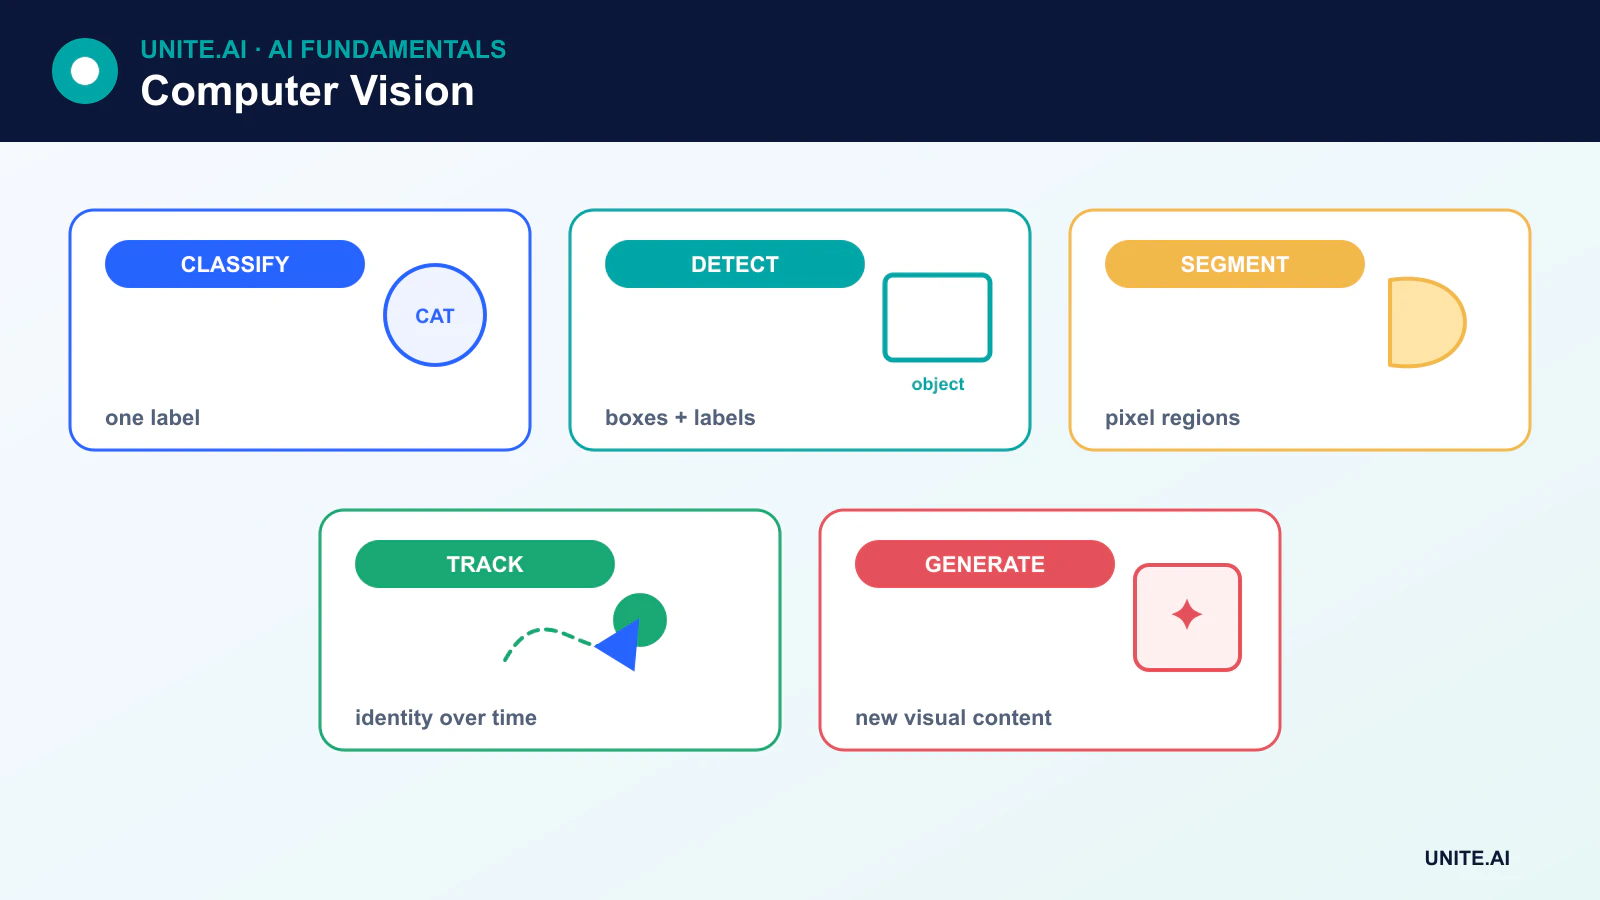
The main computer-vision tasks
- Image classification weist einem Bild ein oder mehrere Labels zu. Siehe how image classification works.
- Object detection sagt Kategorien und Begrenzungsrahmen für mehrere Objekte voraus.
- Semantic segmentation labelt jeden Pixel nach Klasse, während instance segmentation einzelne Objekte trennt.
- Optical character recognition (OCR) erkennt und transkribiert Text.
- Pose estimation sagt Körper‑ oder Objekt‑Landmarken voraus.
- Tracking verknüpft Erkennungen über Videoframes hinweg.
- Image generation and editing erzeugt oder transformiert visuellen Inhalt, häufig unter Verwendung von diffusion models.
How images become model inputs
Ein digitales Bild ist bereits numerische Daten: ein Tensor, der Pixelwerte über räumliche Dimensionen und Kanäle enthält. Die Vorverarbeitung kann das Bild skalieren, normalisieren, zuschneiden oder augmentieren. Video fügt eine Zeildimension hinzu, während medizinische und wissenschaftliche Bildgebung Tiefe, Wellenlänge oder andere Modalitäten hinzufügen kann.
Klassische Computer‑Vision nutzte handgefertigte Kanten-, Eck- und Textur‑Features. Moderne tiefe Modelle lernen in der Regel Features gemeinsam mit der Aufgabe, obwohl klassische Methoden nützlich bleiben, wenn Daten begrenzt, Regeln gut verstanden oder Rechenleistung minimal sein muss.
CNNs and learned local features
Ein CNN wendet gelernte Kernel auf lokale Nachbarschaften an. Frühere Schichten können auf lokale Muster reagieren, während spätere Blöcke sie zu aufgabenrelevanten Darstellungen kombinieren. Pooling‑ oder Strided‑Operationen reduzieren die räumliche Auflösung, und Residual‑Verbindungen erleichtern die Optimierung tiefer Netze.
Ein moderner CNN‑Klassifikator verwendet häufig Global Pooling statt eines großen Stapels vollständig verbundener Schichten. Detektoren und Segmentierungs‑Netzwerke fügen spezialisierte Köpfe oder Decoder‑Pfade hinzu, die räumliche Informationen erhalten.
Vision transformers and foundation models
Ein Vision‑Transformer teilt ein Bild in Patches, bettet sie ein und nutzt Attention, um deren Beziehungen zu modellieren. Transformer können mit großen Datensätzen und Vor‑Training effektiv skalieren, während CNNs häufig stärkere eingebaute Annahmen und Effizienz bei kleineren Skalen bieten.
Multimodale Modelle richten Bilder an Text aus, sodass Nutzer suchen, Bildunterschriften erstellen, Fragen beantworten oder Segmentierung mit Sprache steuern können. Diese Modelle erweitern die Fähigkeiten, übernehmen aber auch Schwächen aus breit angelegten Web‑Daten, einschließlich Stereotypen, urheberrechtlich geschütztem Material und ungleicher Abdeckung von Bevölkerungen und Umgebungen.
Labels, self-supervision, and synthetic data
Begrenzungsrahmen, Masken, Landmarken und Bildunterschriften können teuer zu erstellen sein. Selbstüberwachtes Lernen leitet Ziele aus den Bildern selbst ab, während schwache Aufsicht verrauschte oder indirekte Labels nutzt. Synthetische Daten können seltene Szenarien hinzufügen, doch Simulationslücken können verhindern, dass synthetische Leistungen auf die reale Welt übertragbar sind.
Die Qualität der Annotation muss gemessen werden. Mehrdeutige Labels, inkonsistente Grenzen und fehlende Objekte setzen eine Obergrenze für die Leistung und können Teilgruppen‑Fehler verbergen.
How vision systems are evaluated
Bei der Klassifikation werden Metriken wie Genauigkeit, Präzision, Recall, F1 und Kalibrierung verwendet. Bei der Detektion üblich sind Intersection over Union und Mean Average Precision. Segmentierung nutzt Intersection over Union oder Dice‑ähnliche Maße. Tracking fügt Identitäts‑ und Trajektorien‑Metriken hinzu.
Die Metrik muss zur Einsatzumgebung passen. Ein Modell kann in einem kuratierten Benchmark gut abschneiden und dennoch bei Regen, wenig Licht, ungewöhnlichen Kamerawinkeln, neuen Geräten oder unbekannten Populationen versagen. Die Bewertung sollte Verteilungsverschiebungen, adversariale Bedingungen und operative Latenz einschließen.
Privacy, bias, and deployment
Gesichter, Kennzeichen, Häuser, medizinische Scans und Videoaufnahmen am Arbeitsplatz können sensible Informationen offenbaren. Sammlung und Aufbewahrung sollten einer definierten rechtlichen und ethischen Grundlage folgen, mit Zugriffskontrollen und Datenminimierung. Gesichts‑Analyse und biometrische Identifikation erfordern besondere Sorgfalt, da Fehler und Überwachung ungleiche Schäden verursachen können.
Edge‑Einsatz kann Latenz und Datenübertragung reduzieren. Edge AI, Quantisierung, Pruning und spezialisierte Beschleuniger können Vision‑Systeme auf Kameras, Fahrzeugen, Robotern und mobilen Geräten praktikabel machen, doch die Kompression muss hinsichtlich Genauigkeit und Verzerrungen neu bewertet werden.
From pixels to visual tasks
Computer Vision wandelt Bilder oder Videos in Aufgaben‑Ausgaben um, wie Klassifikation, Detektion, Segmentierung, Tracking, Pose, Tiefe, optischen Fluss oder Texterkennung. Die Aufgabendefinition bestimmt die Annotation: ein Bild‑Label kann keine präzise Lokalisierung trainieren, und ein Begrenzungsrahmen kann eine Segmentierungs‑Maske nicht vollständig beschreiben. Kamerageometrie, Objektive, Belichtung, Beleuchtung, Bewegung, Kompression und Blickwinkel formen die Datenverteilung. Definieren Sie die Betriebsumgebung und die Fehlkonsequenz, bevor Sie ein Modell auswählen, da eine Benchmark‑Bildsammlung möglicherweise nicht den eingesetzten Sensor oder die Szene repräsentiert.
Eine Pipeline dekodiert und orientiert Medien, skaliert oder teilt sie, normalisiert Werte, wendet label‑erhaltende Augmentation an, führt ein Modell aus und post‑processiert Logits, Boxen, Masken oder Tracks. Objektdetektoren nutzen Vertrauens‑Schwellenwerte und Suppression; Tracker verknüpfen Erkennungen über die Zeit; Segmentierung kann morphologische Bereinigung erfordern. Bewahren Sie Koordinatentransformationen, damit Ausgaben mit dem Originalbild übereinstimmen. Teilen Sie Daten nach Person, Kamera, Ort oder Aufnahmesitzung, um zu vermeiden, dass nahezu identische Frames sowohl im Trainings‑ als auch im Test‑Set erscheinen.
Evaluation, bias, privacy, and operations
Die Metriken müssen zur Aufgabe und Nutzung passen. Klassifikation benötigt klassenspezifische Präzision und Recall; Detektion verwendet Intersection‑over‑Union und durchschnittliche Präzision über Schwellenwerte; Segmentierung nutzt IoU oder Dice; Tracking fügt Identitäts‑Wechsel hinzu; Latenz und Dauer verpasster Ereignisse sind für Video wichtig. Berichten Sie Ergebnisse nach Beleuchtung, Entfernung, Gerät, Verdeckung, Hautfarbe, Alter und anderen relevanten Bedingungen. Prüfen Sie Kalibrierung und Fehler mit hohem Vertrauen. Synthetische oder augmentierte Daten können Lücken füllen, erfordern jedoch Vergleich mit realen Einsatzdaten und dürfen keine Test‑Szenen leaken.
Vision kann Beobachter, Orte, biometrische Daten und sensibles Verhalten erfassen. Minimieren Sie Erfassung und Aufbewahrung, sichern Sie Streams, beschränken Sie die sekundäre Nutzung und geben Sie Hinweis oder Einwilligung, wo erforderlich. Testen Sie adversariale Patches, Wiederholungen, Verdeckungen, Kamerafehler und Domänen‑Shift. Überwachen Sie Sensor‑Gesundheit, Eingabe‑Statistiken, Ausgabewerte und bestätigte Ergebnisse; behalten Sie menschliche Überprüfung für entscheidende Entscheidungen bei. Unschärfe oder Beschnitt kann die Exposition reduzieren, kann aber auch Beweise entfernen. Ein hoher Laborwert rechtfertigt keine Aussagen zu Identität, Emotion oder Absicht über die validierte Aufgabe hinaus.
Worked example: pedestrian detection at a warehouse crossing
Kameras überwachen eine eingeschränkte Fahrzeugkreuzung, und das Modell erkennt Personen, ohne sie zu identifizieren. Die Daten decken Tag und Nacht, Wetter, Kleidung, Verdeckungen, Rollstuhlnutzer, Kamerapositionen und leere Szenen ab, aufgeteilt nach Aufnahmesitzung. Der Detektor wird hinsichtlich Ereignis‑Recall, Fehlalarme, Lokalisierung, Vorwarnzeit und Leistung in Entfernung bewertet. Die Sicherheitstechnik definiert die maximal tolerierbare Latenz und unabhängige physische Kontrollen.
Der Vision‑Alarm kann ein Fahrzeug abbremsen, aber Not‑Stops und Barrieren hängen nicht vom gelernten Modell ab. Kameraverdeckung, eingefrorene Frames, Netzwerkverlust und Modell‑Timeout erzeugen explizite Fehler. Die Aufbewahrung von Roh‑Video wird minimiert und der Zugriff protokolliert. Das Monitoring verfolgt Sensor‑Gesundheit, Alarm‑Raten, überprüfte Vorfälle und Beinahe‑Unfälle nach Bedingungen. Jede Kameraverlagerung oder Layout‑Änderung löst eine erneute Validierung aus, da scheinbare Bildähnlichkeit nicht dieselbe Geometrie oder dasselbe Risiko garantiert.
Implementation evidence and operational readiness
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die beabsichtigten Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluations‑Datensatz vor dem Feintuning. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungs‑Shift, Ausfall von Abhängigkeiten, Missbrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgaben‑Qualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Sie die Zuständigkeit für Freigabe, Ausnahmen, Änderungen, Rollbacks und Stilllegung festlegen. Verwenden Sie ein gestuftes Rollout, bewahren Sie ein sicheres Backup und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabe‑Qualität, Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und prüfen Sie dann Evidenz aus der Praxis nach dem Einsatz, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gewartetes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Vorfällen, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Frequently asked questions
Is computer vision the same as image recognition?
Nein. Bilderkennung bezieht sich meist auf Klassifikation oder Identifikation. Computer Vision umfasst zudem Lokalisierung, Segmentierung, Messung, Tracking, Rekonstruktion, Generierung und das Schließen über visuelle Informationen.
Does a vision system see like a human?
Nein. Ein Modell verarbeitet numerische Eingaben gemäß seiner Architektur und seinem Trainingsziel. Es kann Menschen bei einem engen Benchmark übertreffen, während es bei kleinen Änderungen, die ein Mensch leicht handhabt, versagt.
Primary references












