Grundlagen der KI
Was sind CNNs (Convolutional Neural Networks)?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
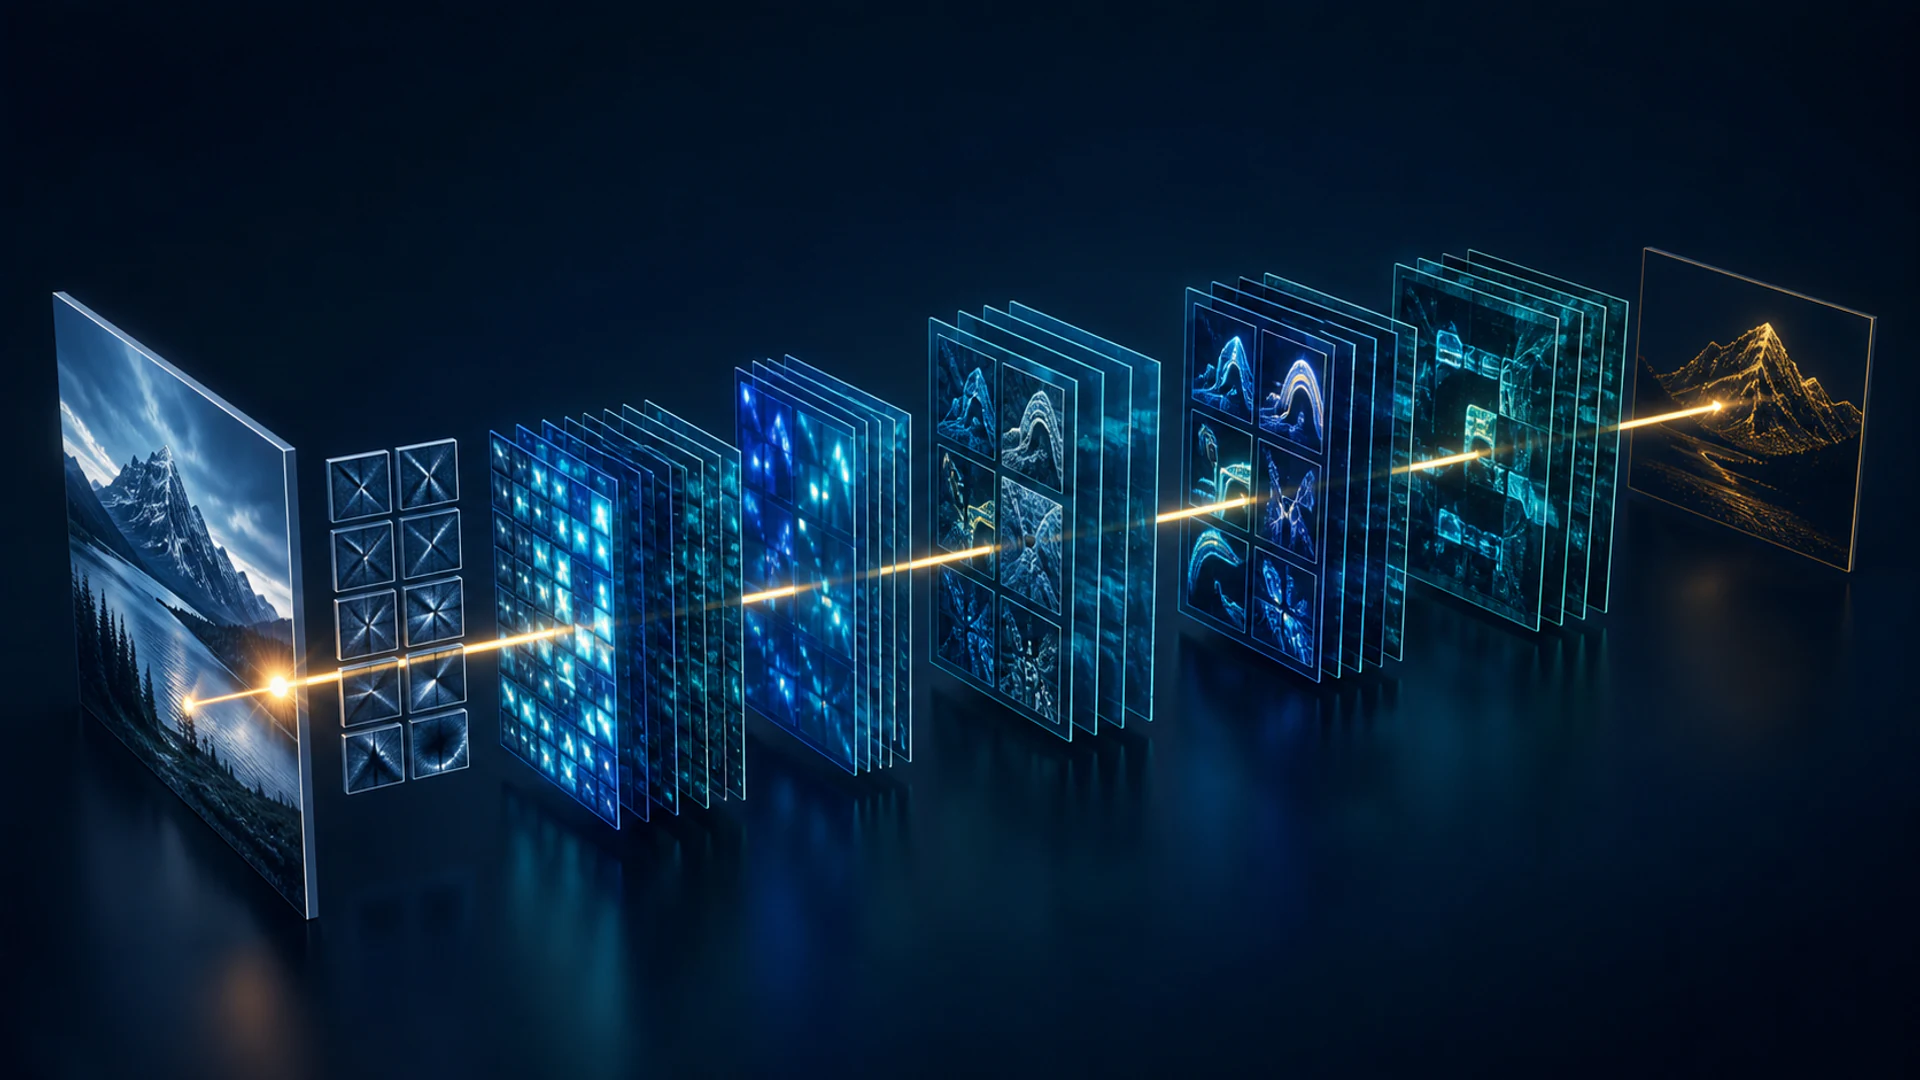
A Faltungsneuronales Netzwerk (CNN) ist eine neuronale Netzwerkarchitektur, die gelernte Filter über lokale Regionen einer Eingabe verwendet. CNNs wurden zur Grundlage der modernen Computer Vision, weil sie Muster erkennen können, egal wo diese Muster auftreten, und dieselben Parameter über ein Bild hinweg wiederverwenden.
Ein CNN wandelt ein Bild nicht von einer nicht‑numerischen in eine numerische Form um – das Bild liegt bereits als Tensor von Pixelwerten vor. Sein Zweck ist es, diesen Tensor in Feature‑Maps zu transformieren, die für Klassifikation, Erkennung, Segmentierung oder andere Aufgaben nützlich sind.
Wichtige Erkenntnisse
- Eine Faltung kombiniert lokale Eingabewerte mit einem gelernten Kernel, um eine Feature‑Map zu erzeugen.
- Stride, Padding, Dilatation und Pooling steuern die räumliche Auflösung und das rezeptive Feld.
- Gewichtsteilung macht CNNs parametereffizienter als ein vollständig verbundenes Netzwerk über Rohpixel.
- Vision‑Transformer bieten eine Alternative, doch CNNs bleiben stark für effiziente und datenbeschränkte Systeme.
Wie Faltung funktioniert
Ein Kernel ist ein kleines Gitter aus trainierbaren Gewichten. An jeder Position multipliziert das CNN die Kernel‑Werte mit den entsprechenden Eingabewerten, summiert die Ergebnisse und fügt meist einen Bias hinzu. Durch Wiederholung über die Eingabe entsteht eine Feature‑Map.
Bei einem Farbbild erstreckt sich ein Kernel über alle Eingabekanäle. Eine Schicht verwendet mehrere Kernel, um mehrere Ausgabekanäle zu erzeugen. Während des Trainings berechnet Backpropagation die Gradienten für diese Kernel‑Gewichte; die Faltungsoperation erzeugt nicht für jedes Bild einen neuen festen Satz von Gewichten.
Stride, Padding und Dilatation
- Stride steuert, wie weit der Kernel verschoben wird. Ein Stride größer als eins reduziert die räumliche Auflösung.
- Padding fügt Werte um die Eingabe herum hinzu, sodass Randinformationen verarbeitet werden können und die Ausgabengröße kontrollierbar ist.
- Dilation vergrößert den Abstand zwischen den Kernel‑Elementen, erweitert das rezeptive Feld, ohne die Parameter proportional zu erhöhen.
Das rezeptive Feld ist der Bereich der ursprünglichen Eingabe, der eine Einheit beeinflussen kann. Durch das Stapeln von Faltungen wird es erweitert, sodass spätere Merkmale Informationen aus größeren Bereichen kombinieren können.
Aktivierung, Normalisierung und Pooling
Convolutional‑Schichten werden üblicherweise von nichtlinearen Aktivierungen und Normalisierungen gefolgt. Pooling fasst lokale Regionen mittels einer Operation wie Maximum oder Mittelwert zusammen. Gelernte strided Convolutions können ebenfalls downsamplen.
Pooling ist nicht zwingend erforderlich. Viele moderne Netze verwenden globales Average‑Pooling nahe dem Ausgang, anstatt eine große Feature‑Map in einen vollständig verbundenen Stapel zu flatten. Das reduziert Parameter und ermöglicht dem Netzwerk, räumliche Evidenz zu aggregieren.
Eine moderne CNN‑Architektur
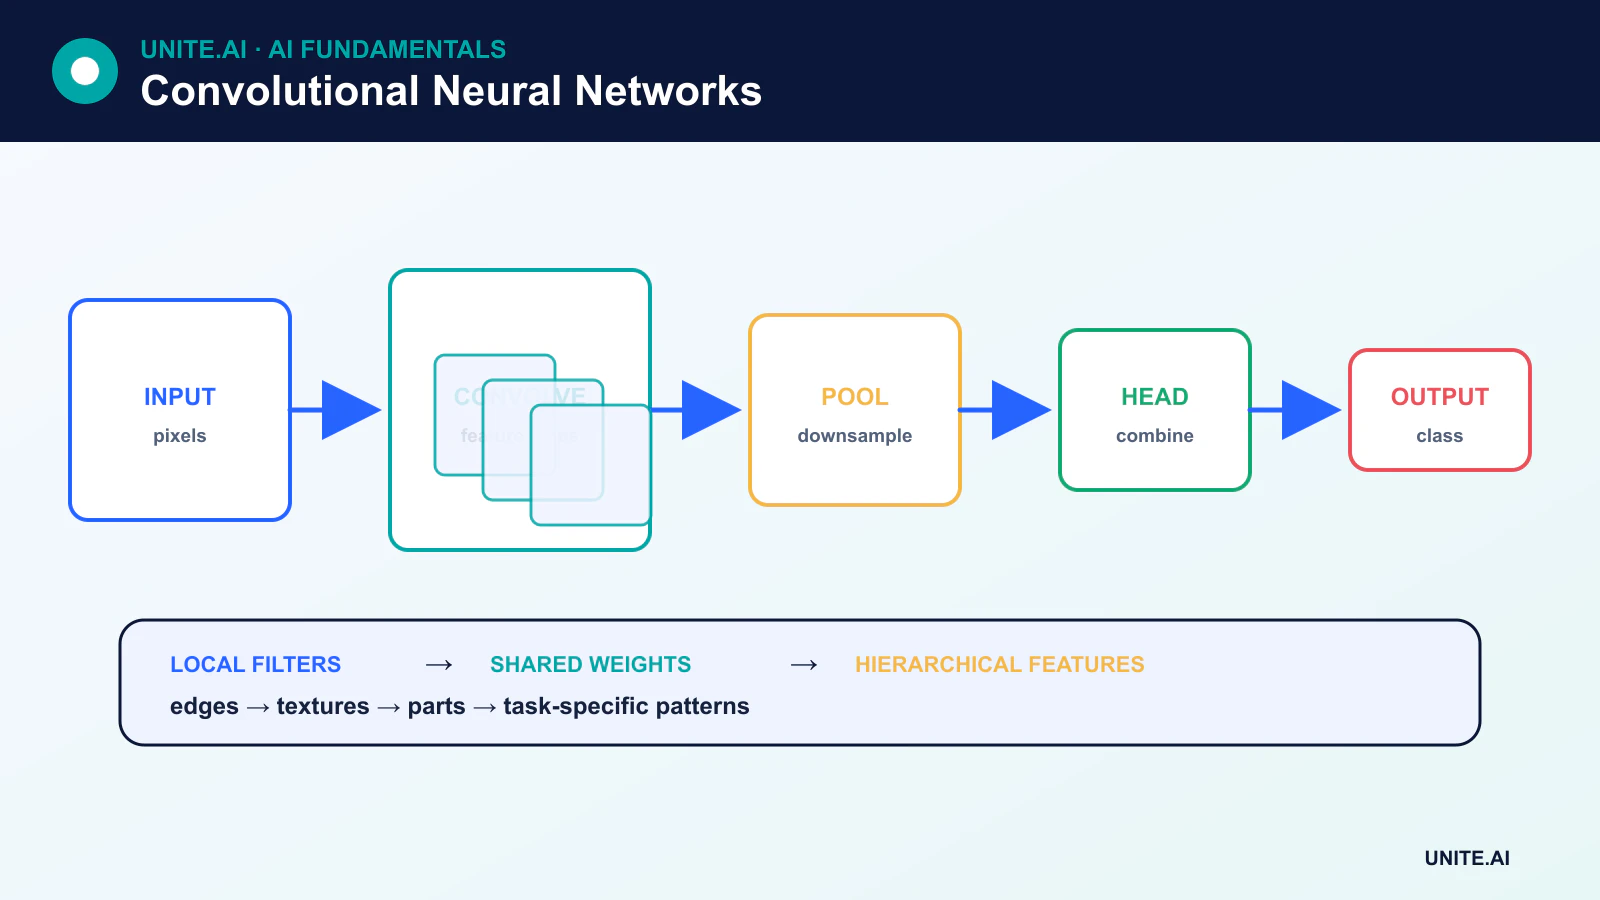
Ein typisches Vision‑Modell enthält ein Stem, eine Sequenz von Feature‑Blöcken, Downsampling‑Stufen und einen Task‑Head. Residual‑Verbindungen ermöglichen es einem Block, eine Modifikation seiner Eingabe zu lernen und bieten einen direkten Weg für Informationen und Gradienten. Der Erfolg von Residual‑Netzwerken machte es praktikabel, wesentlich tiefere CNNs zu trainieren.
Klassifikations‑Heads erzeugen Klassenscores. Detektions‑Heads sagen Kategorien und Bounding‑Boxes voraus. Segmentierungs‑Architekturen fügen Decoder‑Pfade hinzu, die räumliche Details wiederherstellen. Das gleiche CNN‑Backbone kann über Transfer‑Learning wiederverwendet werden.
Was CNN‑Schichten lernen
Es ist üblich, frühe Filter zu visualisieren, die auf Kanten oder Texturen reagieren, und spätere Darstellungen, die mit Teilen oder Objekten korrelieren. Das ist eine hilfreiche Intuition, aber keine feste Regel. Merkmale hängen von Aufgabe, Architektur, Daten, Ziel und Trainingsprozess ab, und manche Einheiten kombinieren Informationen, die nicht eindeutig einem menschlichen Konzept zugeordnet werden können.
CNNs versus Vision‑Transformer
Vision‑Transformer teilen Bilder in Patches auf und nutzen Attention, um Beziehungen zwischen ihnen zu modellieren. Sie können mit großen Pre‑Training‑Datensätzen effektiv skalieren. CNNs bauen Lokalitäts‑ und Translations‑Annahmen direkt in die Architektur ein, was sie in kleineren Umgebungen effizienter und dateneffektiver machen kann.
Viele praktische Systeme kombinieren Convolution und Attention. Die passende Architektur hängt von Genauigkeit, Latenz, Speicher, Trainingsdaten, Hardware und Deployment ab – nicht davon, welche Familie die neueste ist.
Einschränkungen und praktische Überlegungen
CNNs können empfindlich gegenüber Verteilungsverschiebungen, adversarialen Störungen, Hintergrund‑Shortcuts und verzerrten Trainingsdaten sein. Sie sind nicht vollständig invariant gegenüber Position, Rotation, Skalierung oder Blickwinkel. Datenaugmentation und architektonische Entscheidungen können die Robustheit verbessern, garantieren sie jedoch nicht.
Für das Deployment sollten End‑to‑End‑Latenz, Speicher, Durchsatz und das Verhalten von Untergruppen gemessen werden. Quantisierung und Pruning können Kosten senken, insbesondere für Edge AI, aber komprimierte Modelle müssen neu validiert werden.
Faltung, rezeptive Felder und moderne CNN‑Blöcke
Eine Convolutional‑Schicht schiebt gelernte Kernel über ein Gitter und teilt Gewichte über Positionen. Kernel‑Größe, Stride, Dilatation und Padding bestimmen die Ausgangsform und das rezeptive Feld. Frühe Schichten reagieren oft auf lokale Kanten oder Texturen; tiefere Schichten kombinieren Informationen über größere Regionen, wobei gelernte Darstellungen nicht zwingend sauber auf menschliche Konzepte abbilden. Pooling oder strided Convolution reduziert die räumliche Auflösung. Kanäle tragen Feature‑Maps, während gruppierte und depthwise separable Convolution den Kanal‑Mischungsaufwand gegen geringeren Rechenaufwand abwägen. Residual‑Verbindungen erleichtern die Optimierung sehr tiefer Netze.
Bei einer Eingabe‑Höhe und -Breite steuert Padding die Randbehandlung und Stride das Sampling. Aggressives Downsampling kann kleine Objekte entfernen; Zero‑Padding kann Randartefakte erzeugen; Dilatation erweitert den Kontext ohne gleiches Parameterwachstum, kann jedoch ein Gittermuster erzeugen. Batch‑Normalization hängt von Trainingsstatistiken ab, während Alternativen bei kleinen Batch‑Größen besser funktionieren können. Moderne Architekturen kombinieren Bottlenecks, Multi‑Scale‑Features, Attention oder invertierte Residuals. Wählen Sie die Architektur anhand von Task‑Auflösung, Speicher‑Bandbreite, Latenz und Ziel‑Hardware, nicht nur anhand der Bildklassifikations‑Genauigkeit.
Training, Interpretation und Deployment
Verwenden Sie Augmentierungen, die Labels erhalten und reale Variationen widerspiegeln, und teilen Sie die Daten nach Subjekt oder Szene, bevor Sie augmentieren. Transfer‑Learning ist üblich: Ersetzen Sie den Task‑Head, trainieren Sie ihn und lösen Sie dann vorsichtig das Backbone. Bewerten Sie klassen‑spezifische Leistung, Kalibrierung, Robustheit gegenüber Unschärfe, Kompression, Beleuchtung, Skalierung, Zuschnitt und adversarialen Störungen. Visualisierungsmethoden wie Feature‑Maps und Saliency können Shortcuts aufzeigen, sind jedoch empfindlich gegenüber Methode und Basislinie. Bestätigen Sie vermutete Abhängigkeiten mit kontrafaktischen Bildern, Occlusion‑Tests oder Änderungen des Datensatzes.
Exportierte CNNs können fusioniert, quantisiert oder für GPU, NPU, Browser oder Mikrocontroller kompiliert werden. Validieren Sie den bereitgestellten Graphen, einschließlich Vor‑ und Nachverarbeitung, auf den genauen Geräten. Messen Sie End‑to‑End‑Latenz, Speicher, Energie und thermisches Verhalten; die Eingabedekodierung kann bei kleinen Modellen dominieren. Überwachen Sie Kamera‑ und Bildstatistiken, Ausgangsverteilung und bestätigte Fehler. Signierte Model‑Artefakte, geschützte Update‑Kanäle und ein graceful Sensor‑Failure sind Teil des Produktionsdesigns. CNNs kodieren einen nützlichen Lokalitäts‑Bias, verstehen jedoch nicht automatisch Objekte oder kausale Szenen.
Praktisches Beispiel: Deployment eines CNN auf einer Inspektionskamera
Ein CNN klassifiziert Oberflächenfehler aus hochauflösenden Zeilenscan‑Bildern. Ingenieure teilen Bilder mit Überlappung, sodass kleine Defekte das Downsampling überstehen, behalten Koordinaten für die Überprüfung und validieren Augmentierungen gegenüber realen optischen Variationen. Ein Residual‑CNN und ein leichteres Depthwise‑Modell werden bei gleichem Recall verglichen. Tests umfassen Randdefekte, Blendungen, Kompression, Bewegung, Materialchargen und Kameratausch, wobei unabhängige Produktionschargen für die abschließende Bewertung reserviert werden.
Die Kompilierung fusioniert und quantisiert das Modell für einen Edge‑Accelerator, doch der bereitgestellte Graph wird anhand des Referenzmodells bei sensiblen Defektfällen verglichen. Dekodierung, Tiling, Inferenz und Merge‑Latenz werden End‑to‑End gemessen. Das System kennzeichnet tote Pixel und Belichtungsdrift getrennt von Produktdefekten. Bediener können Quell‑Tiles inspizieren und Ergebnisse überschreiben. Modell‑ und Kameraveränderungen werden schrittweise ausgerollt, und die Linie behält ein sicheres manuelles Inspektionsverfahren bei, wenn die Vision‑Pipeline nicht verfügbar ist.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die beabsichtigten Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Tuning. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Fehlgebrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Nachweise von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout sollten Zuständigkeiten für Release, Ausnahmen, Änderungen, Rollback und Stilllegung zugewiesen werden. Verwenden Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingespeisten Fehlern. Operative Telemetrie sollte Eingabequalität, Ausgabeverhalten, Modell‑ oder Regelversion, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse aufzeigen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie dann nach dem Deployment reale Evidenz, anstatt anzunehmen, dass Offline‑Leistung bestehen bleibt. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Benötigt ein CNN immer Pooling?
Nein. Ein CNN kann mit strided Convolution downsamplen und die Auflösung für dichte Vorhersagen erhalten. Pooling ist ein Design‑Werkzeug, kein zwingendes Erfordernis.
Sind CNN‑Filter handgefertigt?
In einem trainierten CNN werden die Kernel‑Werte normalerweise aus Daten gelernt. Das unterscheidet sich von klassischen Vision‑Filtern, deren Koeffizienten im Voraus für Operationen wie Kantenerkennung festgelegt werden.
Primärreferenzen