Grundlagen der KI
Was sind Support Vector Machines?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Eine Support‑Vector‑Machine (SVM) ist ein überwacht‑lernendes Verfahren, das eine Entscheidungsgrenze mit dem größtmöglichen Abstand zwischen Klassen findet. Die Trainingsbeispiele, die diese Grenze bestimmen, sind die Stützvektoren.
SVMs können lineare oder nichtlineare Klassifikation, Regression und Anomalieerkennung durchführen. Sie sind besonders nützlich für kleine bis mittlere Datensätze mit informativen Merkmalen, einschließlich hochdimensionaler spärlicher Daten, jedoch kann ihr Trainingsaufwand bei sehr großen Datensätzen unpraktisch werden.
Wesentliche Erkenntnisse
- Eine SVM maximiert den minimalen Abstand zwischen der Grenze und den nächstgelegenen Trainingspunkten.
- Stützvektoren sind Datenpunkte, keine zusätzlichen Hyperebenen.
- Der Parameter C gleicht die Breite des Abstands gegen Strafen für Verstöße aus.
- Kerne berechnen die Ähnlichkeit in einem impliziten Merkmalsraum, ohne jede transformierte Eigenschaft explizit zu materialisieren.
Die Idee des maximalen Randes
Für einen linearen binären Klassifikator ist die Entscheidungsgrenze eine Hyperebene:
w · x + b = 0
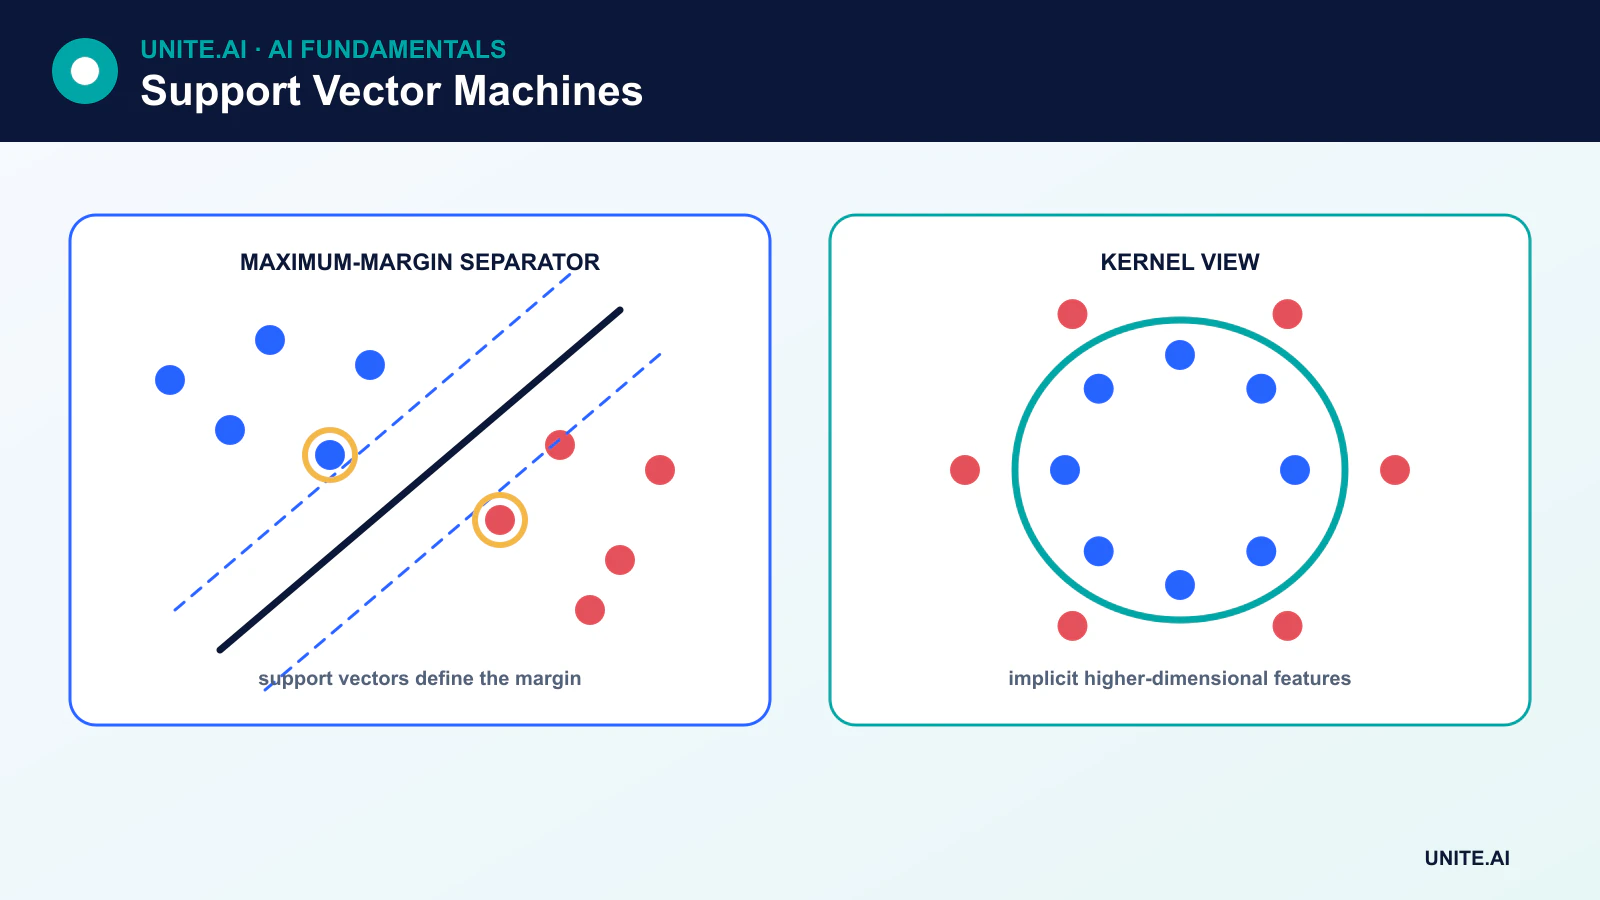
Der Vektor w bestimmt die Orientierung und b den Versatz. Viele Hyperebenen können die Trainingsklassen trennen. Die SVM wählt diejenige, die den Abstand zu den nächstgelegenen Beispielen auf beiden Seiten maximiert. Diese nächstgelegenen Beispiele sind die Stützvektoren und haben den größten Einfluss auf die angepasste Grenze.
Das Ziel ist nicht, den Abstand von der Grenze zu jedem Punkt einzeln zu maximieren. Sie maximiert den minimalen Rand, während Klassenbeschränkungen erfüllt oder bestraft werden.
Harte und weiche Ränder
Eine Hard‑Margin‑SVM erfordert eine perfekte lineare Trennung und ist empfindlich gegenüber Ausreißern. Reale Datensätze benötigen in der Regel einen weichen Rand, der Schlupfvariablen für Beobachtungen innerhalb des Randes oder auf der falschen Seite der Grenze einführt.
Der Hyperparameter C steuert die Strafe für diese Verstöße:
- Ein größerer C bestraft Verstöße stärker und erzeugt oft einen schmaleren Rand, der den Trainingsbeispielen genauer folgt.
- Ein kleinerer C erlaubt mehr Verstöße im Austausch für einen breiteren, stärker regularisierten Rand.
Die Anzahl der Stützvektoren ergibt sich aus den Daten und der Lösung; die Erhöhung von C garantiert keine bestimmte Anzahl von Stützvektoren.
Der Kernel‑Trick
Einige Klassen können im ursprünglichen Merkmalsraum nicht mit einer geraden Hyperebene getrennt werden. Ein Kernel evaluiert ein Skalarprodukt, das einem anderen Merkmalsraum entspricht. Dadurch kann die SVM eine nichtlineare Grenze anpassen, ohne jede transformierte Koordinate explizit zu berechnen.
Gängige Kerne umfassen:
- Linear: effizient für hochdimensionale spärliche Merkmale wie Text.
- Polynomial: modelliert Interaktionen bis zu einem gewählten Grad.
- Radial basis function (RBF): erzeugt flexible lokale Grenzen basierend auf dem Abstand.
- Sigmoid: ähnelt einer neuronalen Aktivierung, wird jedoch seltener als Standardwahl verwendet.
Bei einer RBF‑SVM steuert gamma, wie lokal jedes Trainingsbeispiel die Grenze beeinflusst. Ein großes Gamma kann sehr detaillierte Regionen erzeugen und zu überanpassen führen; ein kleines Gamma erzeugt einen glatteren Einfluss.
Mehrklassenklassifikation
Das klassische SVM‑Ziel ist binär. Bibliotheken erweitern es mit Strategien wie one‑vs‑rest, bei der pro Klasse ein Klassifikator trainiert wird, oder one‑vs‑one, bei der Klassifikatoren für Klassenpaare trainiert und deren Entscheidungen kombiniert werden. Mehrklassen‑SVMs zeichnen nicht einfach eine Linie weniger als die Anzahl der Klassen.
Support‑Vector‑Regression und One‑Class‑SVM
Support‑Vector‑Regression (SVR) passt eine Funktion an, während Fehler innerhalb eines epsilon‑breiten Rohrs ignoriert und größere Abweichungen bestraft werden. Eine One‑Class‑SVM schätzt eine Grenze um typische Daten und kann Anomalieerkennung unterstützen. Ein ungewöhnlicher Punkt ist nicht automatisch Betrug oder Fehler; er ist ungewöhnlich im Kontext der angepassten Darstellung.
Praktische Anforderungen
SVMs basieren auf Abständen und Skalarprodukten, daher müssen numerische Merkmale in der Regel skaliert werden. C, Kernel, Gamma und Klassen‑gewichte sollten durch Validierung ausgewählt werden. Wahrscheinlichkeits‑schätzungen sind nicht inhärent im Rand enthalten und erfordern häufig eine Kalibrierung, die Kosten verursacht und separat bewertet werden sollte.
Das Training von Kernel‑SVMs kann je nach Daten und Implementierung zwischen quadratischer und kubischer Laufzeit in Bezug auf die Stichprobenzahl skalieren. Lineare SVM‑Varianten oder stochastische lineare Modelle eignen sich besser für sehr große Datensätze. Für Rohbilder, Audio oder Sprache können gelernte Darstellungen aus Deep Learning effektiver sein, während eine SVM dennoch ein festes Embedding klassifizieren kann.
Stärken und Einschränkungen von SVMs
SVMs können bei vielen Merkmalen gut funktionieren, bieten ein klares regularisiertes Ziel und hängen zur Vorhersagezeit hauptsächlich von den Stützvektoren ab. Einschränkungen umfassen Empfindlichkeit gegenüber Skalierung und Hyperparametern, potenziell teures Training, reduzierte Interpretierbarkeit bei nichtlinearen Kernen und Anforderungen an die Wahrscheinlichkeitskalibrierung.
Ränder, Kerne und das Optimierungsziel
Eine Support‑Vector‑Machine sucht eine trennende Hyperebene mit einem großen Rand zwischen den Klassen. Nur Stützvektoren, die sich auf oder innerhalb des Randes befinden, bestimmen die Grenze. Soft‑Margin‑SVMs führen Schlupf für Überlappungen und falsch beschriftete Punkte ein; der Parameter C tauscht einen breiteren Rand gegen Trainingsverstöße aus. Eingaben sollten in der Regel skaliert werden, da Abstand und Skalarprodukte die Lösung bestimmen. Klassen‑gewichte oder Resampling helfen, wenn Fehlkosten und Prävalenz ungleich sind, doch Schwellenwerte und Wahrscheinlichkeiten benötigen weiterhin eine unabhängige Validierung.
Der Kernel‑Trick bewertet die Ähnlichkeit, als ob Eingaben in einen höherdimensionalen Merkmalsraum abgebildet würden. Lineare, polynomiale, radial‑basis‑ und spezialisierte Kerne kodieren unterschiedliche Annahmen. Bei einem RBF‑Kernel steuert Gamma, wie lokal jeder Punkt die Grenze beeinflusst: ein hohes Gamma kann komplexe Regionen erzeugen und zu Overfitting führen, während ein niedriges Gamma zu Underfitting führen kann. Kernel‑Matrizen wachsen quadratisch mit der Stichprobenzahl, wodurch nichtlineare SVMs bei großen Datensätzen teuer werden. Lineare Solver oder approximative Feature‑Maps sind bei Skalierung oft vorzuziehen.
Mehrklassen‑Einsatz, Kalibrierung und operative Grenzen
Binäre SVMs werden für Mehrklassen‑Probleme durch one‑vs‑rest, one‑vs‑one oder strukturierte Formulierungen erweitert. Hyperparameter müssen innerhalb einer Kreuzvalidierung abgestimmt werden, ggf. mit gruppierten oder zeitlichen Splits. Evaluieren Sie klassen‑spezifische Präzision und Recall, Randverteilungen, Kalibrierung und Leistung bei Datenverschiebungen. Roh‑Entscheidungswerte sind keine Wahrscheinlichkeiten; Platt‑Scaling oder isotone Kalibrierung verwendet separate Daten und kann sich verschlechtern, wenn sich die Prävalenz ändert. Vergleichen Sie mit logistischer Regression, Entscheidungsbäumen und modernen, auf Darstellungen basierenden Methoden bei vergleichbarem Vorverarbeitungs‑ und Abstimmungsaufwand.
Der Einsatz erfordert exakt denselben Skalierer, dieselbe Feature‑Reihenfolge, Kernel‑Parameter, Stützvektoren und Klassen‑Mapping. Die Vorhersagekosten einer Kernel‑SVM steigen mit der Anzahl der Stützvektoren, daher sollten Latenz und Speicherverbrauch bei realistischen Batches gemessen werden. Eingaben, die weit von den Trainings‑Stützvektoren entfernt sind, können dennoch sichere Labels erhalten; fügen Sie Out‑of‑Distribution‑Prüfungen oder eine Abstinenz‑Richtlinie hinzu, wo dies sinnvoll ist. Untersuchen Sie Fehler auf sensible Proxy‑Variablen und Datensatz‑Artefakte. SVMs bleiben für mittelgroße, hochdimensionale Probleme stark, jedoch ist ein maximaler geometrischer Rand kein Beweis für kausale Struktur oder Sicherheit.
Praktisches Beispiel: Eine SVM für seltene Dokumenten‑Routing
Ein Legal‑Operations‑Team klassifiziert kurze Einreichungen in Routing‑Kategorien mithilfe von TF‑IDF‑Merkmalen und einer linearen SVM. Es teilt nach Vorgang und Zeitpunkt, um ein Leck von Vorlagen zu verhindern, skaliert Klassen‑gewichte basierend auf den überprüften Fehlkosten und stimmt C innerhalb einer geschachtelten Validierung ab. Das lineare Modell wird mit logistischer Regression und einem Transformer verglichen. Präzision, Recall, Kalibrierung und Arbeitsbelastung der Prüfer pro Klasse sind wichtiger als die Gesamtexaktheit.
Entscheidungswerte werden auf separaten Daten kalibriert, und Dokumente mit geringem Rand oder nicht unterstützter Sprache werden manuell aufgenommen. Das Bereitstellungs‑Artefakt umfasst Tokenizer, Vokabular, Gewichtung, Modell, Kalibrierung und Label‑Mapping. Das Monitoring verfolgt neue Begriffe, Kategorisierungshäufigkeit, Ränder und korrigierte Routen. Dokumente und Stützvektoren werden geschützt, da Textmerkmale vertrauliche Informationen preisgeben können. Ein nichtlinearer Kernel wird verworfen, wenn sein geringer Qualitätszuwachs die Latenz‑, Speicher‑ und Interpretationskosten nicht rechtfertigt.
Implementierungsnachweis und operative Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenzen jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluierungsset vor dem Tuning. Testen Sie normale Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Datenverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unzureichend versorgt werden. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Zuständigkeiten für Release, Ausnahmen, Änderungen, Rollback und Stilllegung zugewiesen werden. Verwenden Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingespeisten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, die Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse aufzeigen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie danach die Evidenz aus der Praxis, anstatt anzunehmen, dass die Offline‑Leistung erhalten bleibt. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Führen SVMs nur Klassifikationen durch?
Nein. Support‑Vector‑Regression sagt kontinuierliche Zielgrößen voraus, während eine One‑Class‑SVM eine Anomalie‑Grenze schätzen kann. Jede Variante hat ein anderes Ziel und einen eigenen Satz von Hyperparametern.
Wann ist eine lineare SVM eine gute Wahl?
Lineare SVMs sind häufig effektiv für hochdimensionale spärliche Merkmale, einschließlich traditioneller Textdarstellungen, bei denen ein flexibler Kernel Kosten ohne klaren Nutzen hinzufügen würde.
Primärreferenzen