Grundlagen der KI
Was ist lineare Regression?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Lineare Regression modelliert ein kontinuierliches Ziel als lineare Kombination von einem oder mehreren Eingabefeatures. Sie wird für Vorhersage, Schätzung und als transparente Basis verwendet, um zu verstehen, ob ein komplexeres Modell einen bedeutenden Mehrwert liefert.
Die Begriffe unabhängige Variable und abhängige Variable beschreiben Rollen im Modell, nicht bewiesene Ursache‑Wirkung. Eine Regression kann eine Assoziation identifizieren, während Störfaktoren, Auswahlbias, umgekehrte Kausalität oder Messfehler die Beziehung erklären.
Wesentliche Erkenntnisse
- Das Ziel y wird aus den Eingabefeatures X modelliert; die ältere Version des Artikels vertauschte diese Bezeichnungen in einer Formelerklärung.
- Die Methode der kleinsten Quadrate minimiert die Summe der quadrierten Residuen.
- Residuen‑Diagnostik und Annahmen sind für Inferenz und Unsicherheit wichtig.
- Ridge‑ und Lasso‑Regularisierung helfen, wenn Prädiktoren zahlreich oder korreliert sind.
Einfache lineare Regression
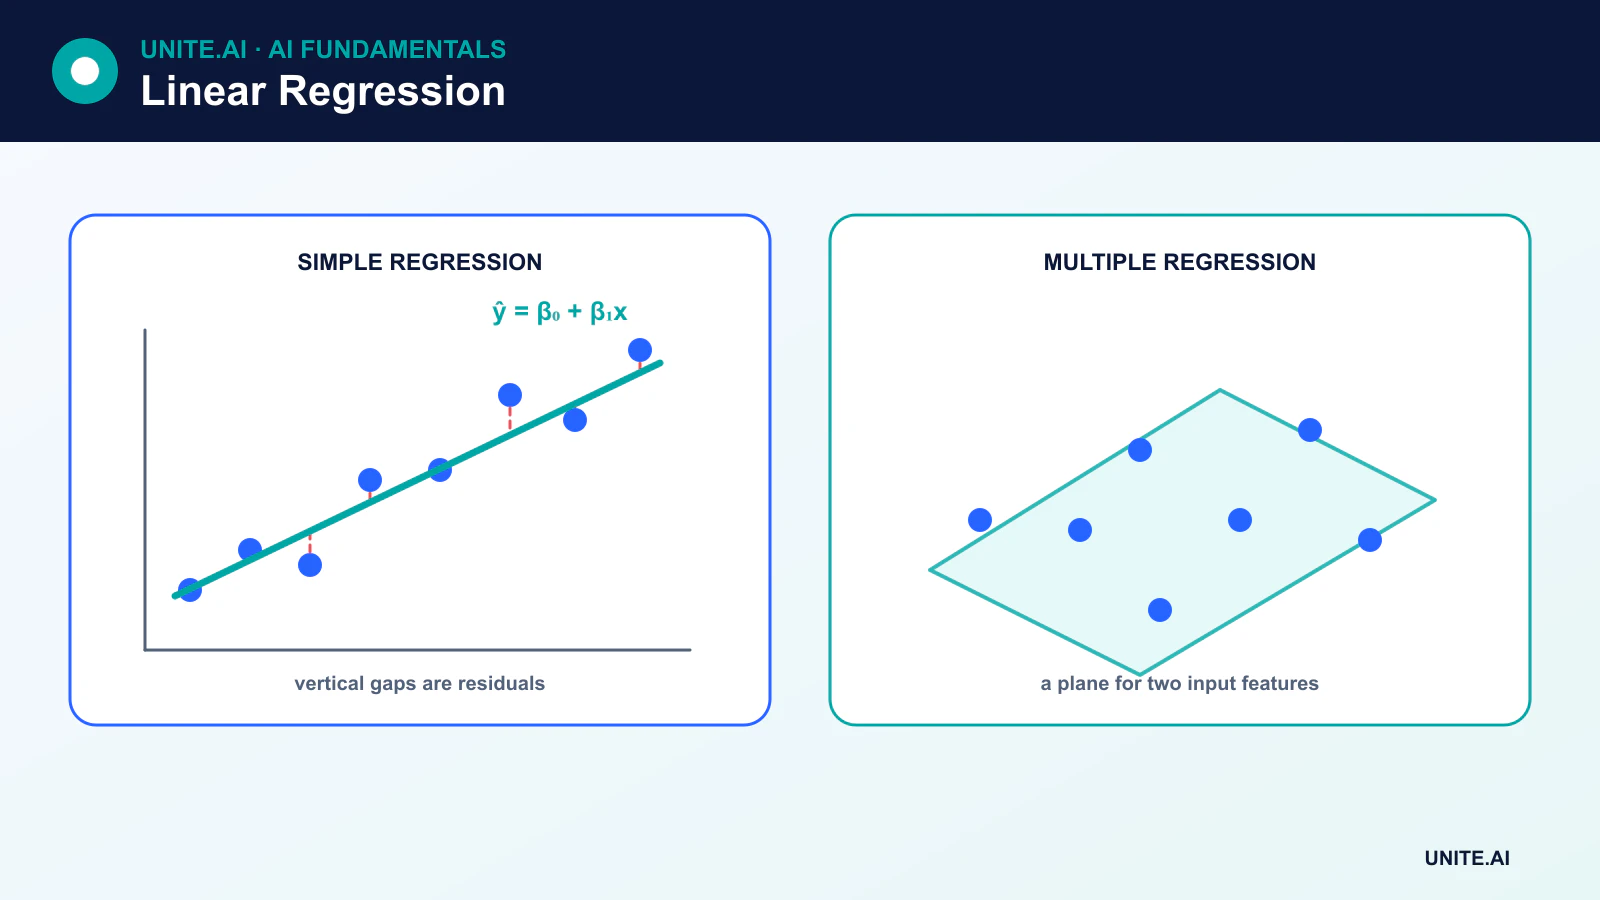
Mit einem Merkmal lautet das Modell:
ŷ = β₀ + β₁x
β₀ ist der Achsenabschnitt und β₁ die Steigung. Das Residuum für Beobachtung i ist yᵢ - ŷᵢ. Die Methode der kleinsten Quadrate (OLS) wählt Koeffizienten, die die Summe der quadrierten Residuen minimieren.
Die Steigung schätzt die erwartete Änderung des Ziels, die mit einer Einheit Änderung des Merkmals im angepassten Modell verbunden ist. Sie sollte nicht als kausaler Effekt beschrieben werden, es sei denn, Studiendesign und Annahmen unterstützen eine kausale Identifikation.
Multiple lineare Regression
Mit p Merkmalen:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Jeder Koeffizient wird bedingt auf die anderen eingeschlossenen Merkmale interpretiert. Multiple Regression kann kategoriale Variablen durch Kodierung, Polynomterme und Interaktionen einbeziehen. Sie bleibt „linear“, weil sie linear in den Koeffizienten ist, selbst wenn transformierte Merkmale wie x² enthalten sind.
Annahmen und Diagnostik
Für Vorhersagen ist die Kernfrage, wie gut das Modell verallgemeinert. Für klassische Koeffiziententests und -intervalle werden zusätzliche Annahmen wichtig:
- Linearität: Der bedingte Mittelwert wird durch die gewählte lineare Form dargestellt.
- Unabhängige oder korrekt modellierte Fehler: Wiederholte, gruppierte, räumliche oder Zeitreihen‑Beobachtungen können eine andere Fehlstruktur erfordern.
- Konstante Fehlervarianz: Heteroskedastizität beeinflusst Standardfehler und Unsicherheitsabschätzungen.
- Begrenzte Multikollinearität: Stark korrelierte Prädiktoren machen einzelne Koeffizienten instabil.
- Residuenverteilung: Normalität ist für einige Inferenz bei kleinen Stichproben relevant, jedoch keine Voraussetzung, dass jedes Merkmal normalverteilt sein muss.
Residuen‑Plots, Leverage‑ und Einfluss‑Metriken sowie eine Fach‑Review können Ausreißer, Nichtlinearität, variierende Varianz oder Beobachtungen, die die Anpassung dominieren, identifizieren.
Bewertung von Vorhersagen
- Mittlere absolute Abweichung (MAE) bildet die durchschnittliche Größe der absoluten Residuen ab.
- Mittlere quadratische Abweichung (MSE) gewichtet größere Fehler stärker.
- Wurzel‑MSE (RMSE) gibt den quadrierten Fehler in die Zieleinheiten zurück.
- R² vergleicht die Residuenvariation mit einem konstanten Basiswert auf den ausgewerteten Daten.
R² ist keine Genauigkeit, stellt keine Kausalität her und kann bei Testdaten negativ sein. Die Validierung sollte dem tatsächlichen Vorhersage‑Setting entsprechen, einschließlich zeit- oder gruppenbezogener Aufteilungen, wenn nötig.
Ridge, Lasso und Elastic Net
Ridge‑Regression fügt eine L2‑Strafe hinzu, die Koeffizienten schrumpft und korrelierte Prädiktoren stabilisiert. Lasso fügt eine L1‑Strafe hinzu und kann Koeffizienten auf Null setzen. Elastic Net kombiniert beides. Merkmale benötigen in der Regel eine kompatible Skalierung, bevor diese Strafen verglichen werden.
Regularisierung führt zu einem Bias im Austausch für geringere Varianz und kann Overfitting reduzieren. Die Stärke der Strafe wird mittels Validierung gewählt, nicht anhand des finalen Test‑Sets.
Wann lineare Regression das falsche Werkzeug ist
Ein lineares Modell kann versagen, wenn Beziehungen stark nicht‑linear sind, Fehler von vergangenen Werten abhängen, Zielverteilungen spezialisierte Modellierung erfordern oder einige Ausreißer den quadratischen Verlust dominieren. Entscheidungsbäume, generalisierte lineare Modelle, Zeitreihen‑Modelle, robuste Regression oder nicht‑lineare Verfahren können besser passen.
Selbst wenn ein komplexes Modell gewinnt, bleibt lineare Regression eine wertvolle Basislinie. Wenn ein großes System sie nicht zuverlässig übertreffen kann, ist die zusätzliche Komplexität möglicherweise nicht gerechtfertigt.
Modellannahmen, Schätzung und Diagnostik
Lineare Regression modelliert den bedingten Mittelwert eines numerischen Ergebnisses als Achsenabschnitt plus gewichtete Prädiktoren. Die Methode der kleinsten Quadrate wählt Koeffizienten, die die quadrierten Residuen minimieren. Koeffizienten beschreiben die erwartete Ergebnisänderung bei einer Einheit Änderung des Prädiktors, während andere eingeschlossene Variablen konstant gehalten werden, gemäß dem spezifizierten Modell. Dies ist eine Assoziation, sofern nicht Annahmen zur kausalen Identifikation und das Studiendesign mehr rechtfertigen. Einheiten, Kodierung, Transformationen, Interaktionen und Referenzkategorien bestimmen die Interpretation, sodass Koeffizienten ohne Daten‑Dictionary unvollständig sind.
Klassische Inferenz beruht auf Annahmen über die funktionale Form, unabhängige Fehler, konstante Varianz und Fehlerverteilung für bestimmte Tests und Intervalle. Residuen‑gegen‑angepasste‑Plots zeigen Nichtlinearität oder Heteroskedastizität; Q‑Q‑Plots beurteilen das Schwanzverhalten; Leverage‑ und Einfluss‑Diagnostik identifizieren Beobachtungen, die Schätzungen stark beeinflussen. Korrelationen zwischen Prädiktoren erhöhen die Unsicherheit und machen einzelne Koeffizienten instabil, selbst wenn Vorhersagen ausreichend sind. Robuste Standardfehler, Transformationen, Splines, hierarchische Strukturen oder ein alternatives Modell können nötig sein, anstatt unpraktische Datenpunkte zu löschen.
Regularisierung, Bewertung und verantwortungsbewusste Nutzung
Ridge‑Regression schrumpft Koeffizienten mit einer L2‑Strafe, während Lasso einige auf Null setzen kann mit einer L1‑Strafe; Elastic Net kombiniert beides. Standardisieren Sie Prädiktoren, wenn die Strafskala vergleichbar sein soll, und wählen Sie die Stärke mittels Validierung oder Kreuzvalidierung. Bewerten Sie mittlere absolute Abweichung, Wurzel‑MSE, Residuenverteilung, Kalibrierung über Bereiche und Unsicherheit, mit zeit- oder gruppenbezogenen Aufteilungen, die die Nutzung widerspiegeln. Vergleichen Sie mit einer Mittelwert‑Basislinie und nicht‑linearen Alternativen, behalten Sie jedoch lineare Modelle bei, wenn Transparenz und Stabilität wertvoll sind.
Extrapolation jenseits des beobachteten Prädiktorbereichs folgt der angepassten Linie ohne Evidenz und kann gefährlich sein. Überwachen Sie Merkmalsbereiche, Fehlende Werte, Residuen und Untergruppen‑Fehler im Produktivbetrieb. Prädiktionsintervalle beschreiben die Unsicherheit einzelner Ergebnisse und sind breiter als Konfidenzintervalle für den Mittelwert; beide erfordern Annahmen. Vermeiden Sie die Kontrolle von Variablen, die kausale Verzerrungen einführen, wenn das Ziel die Schätzung von Effekten ist. Lineare Regression ist ein präzises Werkzeug für eine definierte Beziehung, nicht eine universelle Garantie, dass die Welt linear ist oder ein Koeffizient eine Intervention darstellt.
Praktisches Beispiel: Schätzung der Lieferzeit
Ein Logistikteam modelliert die Lieferdauer anhand von Entfernung, Service‑Level, Region, Wochentag und bekannten Wetterbedingungen. Es untersucht nicht‑lineare Residuenmuster und fügt begründete Splines und Interaktionen hinzu, anstatt eine lineare Gleichung als wörtliche Physik zu behandeln. Carrier‑ und Routen‑Gruppen definieren Validierungs‑Folds. Mittlere absolute Abweichung, Tail‑Error, Intervall‑Abdeckung und systematischer Bias werden berichtet. Stornierte Lieferungen und nach Ankunft erfasste Daten werden ausgeschlossen oder explizit modelliert.
Koeffizienten werden in Einheiten dokumentiert und auf Instabilität bei korrelierten Prädiktoren geprüft. Das Modell verweigert Extrapolation jenseits der validierten Distanz‑ und Regionsbereiche. Prädiktionsintervalle begleiten die Schätzungen, und die nachgelagerte Planung nutzt deren Unsicherheit. Monitoring verfolgt Merkmalsbereiche, Residuen, Intervall‑Abdeckung und Bias nach Netzwerkänderungen. Eine kausale Behauptung über Carrier oder Wetter wird nicht aus prädiktiven Koeffizienten abgeleitet; operationelle Experimente oder stärkere Identifikation wären erforderlich, um Interventionen zu unterstützen.
Implementierungsnachweis und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluations‑Datensatz vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Zuständigkeiten für Release, Ausnahmen, Änderungen, Rollback und Stilllegung festgelegt werden. Verwenden Sie eine gestufte Einführung, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabequalität, Ausgabeverhalten, Modell‑ oder Regelversion, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für Reaktionen, und prüfen Sie nach der Bereitstellung Evidenz aus der Praxis, anstatt anzunehmen, dass Offline‑Leistung bestehen bleibt. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Incidents, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Zeitpunkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Erfordert lineare Regression nur eine Eingabevariable?
Nein. Einfache Regression hat einen Prädiktor, während multiple lineare Regression viele numerische, kodierte kategoriale, transformierte und Interaktions‑Features verwenden kann.
Kann lineare Regression Kausalität nachweisen?
Nein. Eine kausale Interpretation erfordert ein verteidigungsfähiges Forschungsdesign und Annahmen über Störfaktoren, Auswahl, Messung und Intervention. Ein alleiniger prädiktiver Koeffizient beschreibt lediglich eine Assoziation im angepassten Modell.
Primärreferenzen