
Grundlagen der KI
Was ist K-Means-Clustering?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
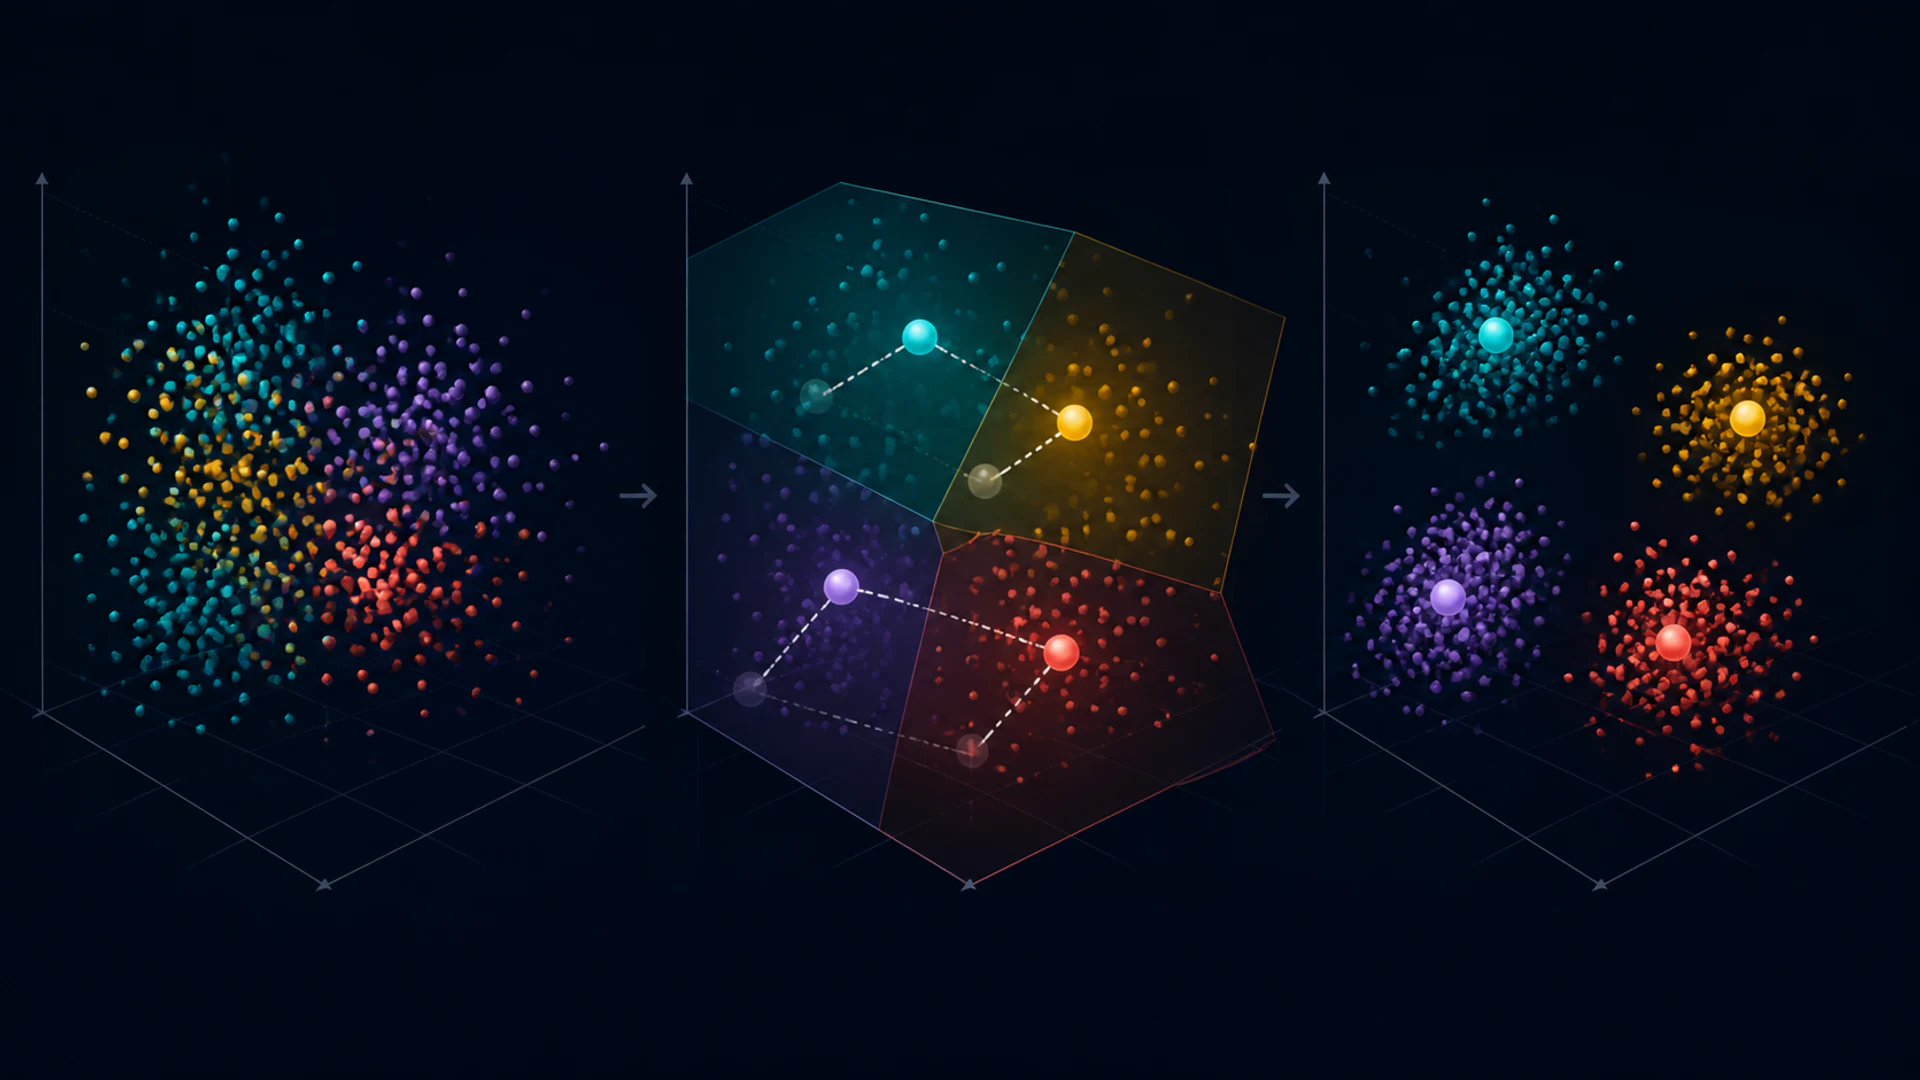
K-means ist ein unüberwachter Algorithmus, der numerische Beobachtungen in k Cluster aufteilt. Er wechselt zwischen der Zuordnung jedes Punktes zu seinem nächsten Schwerpunkt und der Neuberechnung jedes Schwerpunkts als Mittelwert seiner zugewiesenen Punkte.
Der Algorithmus ist schnell und nützlich, aber sein Ergebnis wird durch Skalierung, Distanz, Initialisierung und das gewählte k geprägt. Ein Cluster ist eine mathematische Partition, nicht automatisch eine reale Kategorie.
Wesentliche Erkenntnisse
- K-means minimiert die innerhalb eines Clusters quadratische euklidische Distanz zu den Schwerpunkten.
- Die Initialisierung ist wichtig; k-means++ verteilt die Anfangsschwerpunkte und verbessert in der Regel die Ergebnisse.
- Standardisieren Sie Merkmale, wenn deren Einheiten oder Skalen vergleichbar beitragen sollen.
- K-means hat Schwierigkeiten mit Ausreißern, nicht‑sphärischen Clustern, ungleichen Dichten und kategorialen Daten.
Das Ziel und die Aktualisierungsschleife
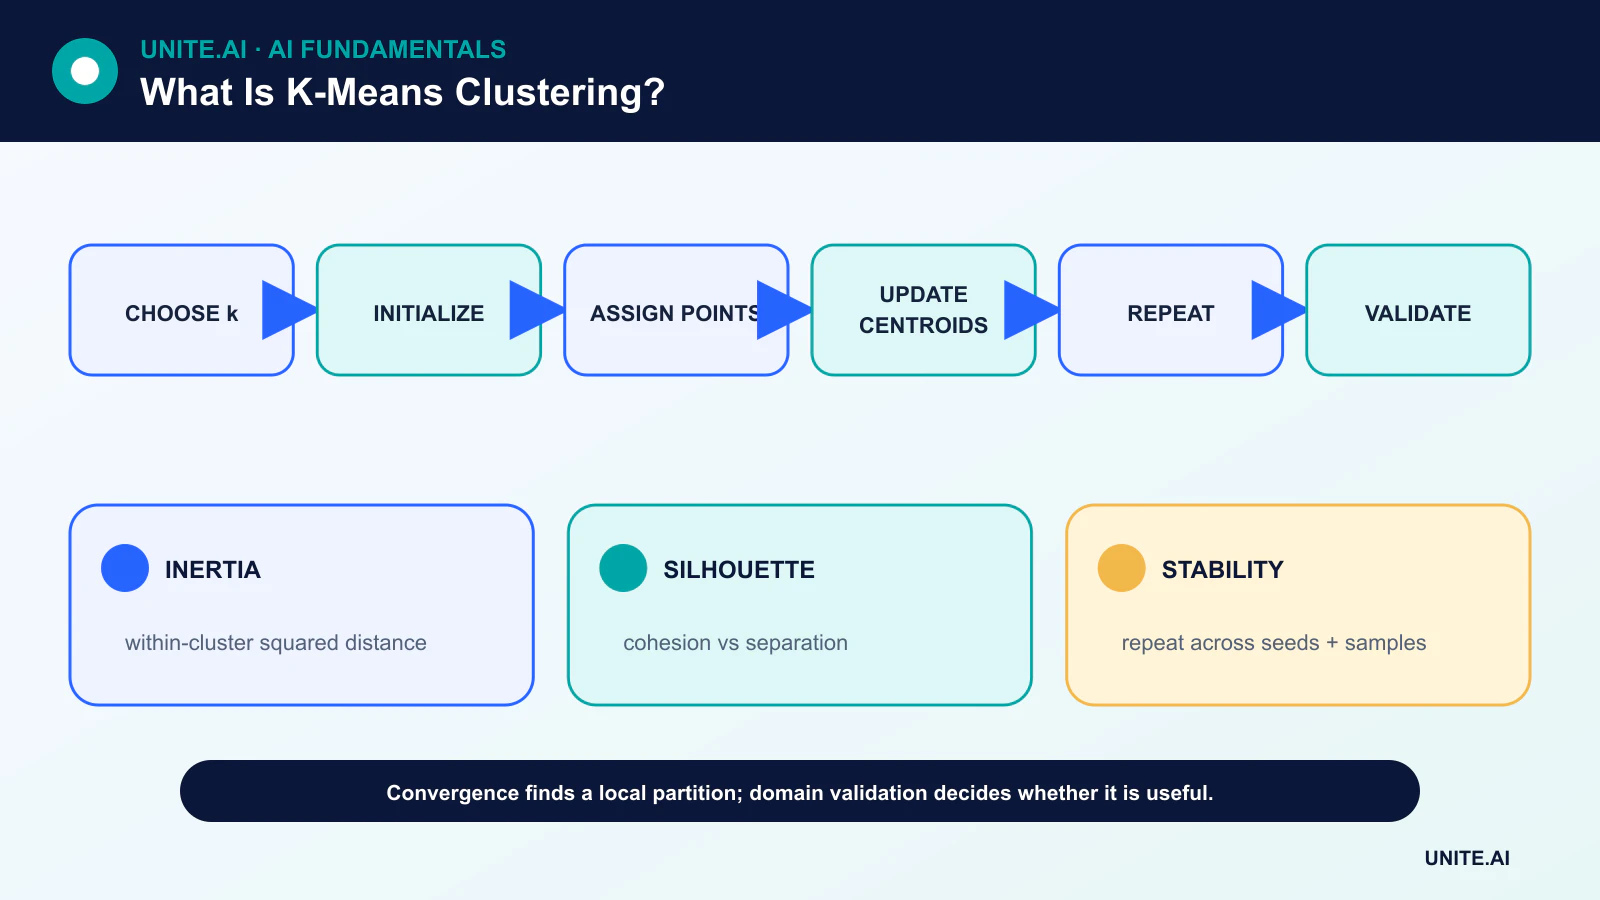
Gegeben k Schwerpunkte weist der Zuordnungsschritt jede Beobachtung dem nächsten zu. Der Aktualisierungsschritt ersetzt jeden Schwerpunkt durch den Mittelwert seiner zugewiesenen Beobachtungen. Die innerhalb des Clusters berechnete Summe der Quadrate kann durch diese Schritte nicht zunehmen, sodass der Prozess zu einem lokalen Optimum konvergiert.
Konvergenz garantiert nicht das globale Optimum. Unterschiedliche Anfangsschwerpunkte können zu unterschiedlichen Partitionen führen, weshalb Implementierungen mehrere Initialisierungen durchführen und die Lösung mit der geringsten Trägheit (Inertia) behalten.
Initialisierung und k-means++
Die zufällige Auswahl aller Anfangsschwerpunkte aus einer dichten Region kann zu einer schlechten Lösung oder langsamer Konvergenz führen. k-means++ wählt Startpunkte mit einer Wahrscheinlichkeit, die von der Distanz zu bereits vorhandenen Punkten abhängt, und fördert so eine bessere Abdeckung des Datensatzes.
Mehrere Durchläufe bleiben nützlich. Protokollieren Sie den Zufalls‑Seed und die Anzahl der Initialisierungen, damit die Ergebnisse reproduzierbar sind.
Skalierung und Distanz
Die quadratische euklidische Distanz macht K-means empfindlich gegenüber Einheiten. Ein Merkmal, das in Tausenden gemessen wird, kann ein anderes, das zwischen null und eins liegt, dominieren. Standardisierung ist üblich, doch das Domänenwissen sollte entscheiden, ob gleiche standardisierte Varianz gleichbedeutende Wichtigkeit widerspiegelt.
Ausreißer können den Mittelwert weit von typischen Punkten entfernen. Robuste Skalierung, Trimmen oder auf Medoiden basierende Methoden können besser sein. One‑Hot‑kodierte kategoriale Merkmale erzeugen eine Distanzgeometrie, die möglicherweise nicht mit der Ähnlichkeit der Kategorien übereinstimmt.
Auswahl von k und Validierung von Clustern
Die Trägheit (Inertia) sinkt, sobald k erhöht wird, sodass sie k nicht allein bestimmen kann. Die Ellenbogen‑Heuristik sucht nach abnehmenden Verbesserungen. Die Silhouetten‑Analyse vergleicht Kohäsion und Trennung. Stabilität über Stichproben und Seeds liefert eine weitere Prüfung.
Die stärkste Validierung ist die Nützlichkeit für die beabsichtigte Domäne. Vergleichen Sie Cluster mit bekannten Ergebnissen, Expertenbewertungen oder einer nachgelagerten Aufgabe, ohne vorzugeben, dass nachträgliche Labels objektiv entdeckt wurden.
Grenzen und Alternativen
K-means bevorzugt kompakte, annähernd sphärische Gruppen ähnlicher Skalierung. Gaussian‑Mixture‑Modelle repräsentieren probabilistische ellipsoide Komponenten; DBSCAN‑artige Verfahren identifizieren dichte Regionen und Rauschen; hierarchisches Clustering erzeugt einen Baum von Zusammenführungen.
Dimensionality Reduction kann die Geschwindigkeit erhöhen oder Eingaben entrauschen, aber das Anpassen an den vollständigen Datensatz kann die Validierungsfrage verändern. Mini‑Batch‑K‑means reduziert die Berechnung für große Datensätze auf Kosten einer approximativen Aktualisierung.
Ziel, Initialisierung und Konvergenz
K-means partitioniert numerische Beobachtungen in k Cluster, indem es die innerhalb des Clusters quadratische euklidische Distanz zu den Schwerpunkten minimiert. Lloyds Algorithmus wechselt zwischen der Zuordnung jedes Punktes zu seinem nächsten Schwerpunkt und der Neuberechnung der Schwerpunkte, bis sich Zuordnungen oder Ziel stabilisieren. Er konvergiert zu einem lokalen Optimum, nicht unbedingt dem global besten. Die k-means++‑Initialisierung verteilt die Anfangszentren und verbessert meist die Ergebnisse, doch mehrere Seeds bleiben wichtig. Merkmale sollten standardisiert werden, wenn Einheiten vergleichbar beitragen sollen, da die quadratische Distanz hochskalierte Variablen und Ausreißer verstärkt.
Die Methode geht von annähernd kompakten, sphärischen, ähnlich skalierten Clustern unter euklidischer Geometrie aus. Sie hat Schwierigkeiten mit langgestreckten Mannigfaltigkeiten, ungleicher Dichte, kategorialen Daten, starken Ausreißern und verschachtelten Strukturen. Leere Cluster und doppelte Punkte erfordern eine definierte Handhabung. Mini‑Batch‑k‑means skaliert für große Datenmengen mit einem Approximationskompromiss. Für spärlichen Text kann kosinusorientiertes sphärisches k‑means die Richtung besser erfassen, während Mischungen, Dichte‑Methoden, hierarchisches Clustering oder k‑medoids andere Annahmen kodieren.
Auswahl von k und Validierung der Bedeutung
Ellenbogen‑Kurven, Silhouetten‑Scores, Informationskriterien in verwandten Modellen und Stabilität können Hinweise auf k geben, aber keines entdeckt eine eindeutig korrekte Zahl. Der geschäftliche Nutzen und die domänenspezifische Interpretation sind entscheidend. Wiederholtes Anpassen über Stichproben und Seeds, Vergleich von Schwerpunktbewegungen und Zuordnungs‑Konsistenz sowie Validierung der Cluster an unabhängigen Ergebnissen, die nicht zur Bildung verwendet wurden, sind wichtig. Eine zweidimensionale Projektion kann die Trennung verzerren, daher sollten Entfernungen und Beispiele im ursprünglichen oder validierten Repräsentationsraum untersucht werden.
Cluster sind beschreibende Gruppen, die durch die ausgewählten Merkmale und die Metrik entstehen; sie sind keine natürlichen Arten oder kausalen Segmente. Profile, die auf denselben Variablen basieren, die für das Clustering verwendet wurden, können zirkulär sein. Verwenden Sie zurückgehaltene Attribute und qualitative Prüfungen und prüfen Sie, ob Cluster hauptsächlich Geografie, Datenquelle oder sensible Merkmale reproduzieren. Kleine Cluster können Anomalien oder Artefakte sein. Das Benennen eines Clusters macht nicht, dass jedes Mitglied dem Label entspricht.
Bereitstellung und Wartung
Speichern Sie Skalierung, Feature‑Reihenfolge, Schwerpunkte, Distanzdefinition und Cluster‑Labels gemeinsam. Für neue Punkte überwachen Sie die Distanz zum zugewiesenen Schwerpunkt und den Anteil, der weit über die Trainingsunterstützung hinausgeht; bieten Sie einen unbekannten Zustand an, anstatt jeden Fall in ein Cluster zu zwingen. Verfolgen Sie im Laufe der Zeit Clustergrößen, Schwerpunkte und die Relevanz der Ergebnisse. Ein erneutes Training ändert die Cluster‑Identitäten, daher sollten nachgelagerte Regeln gemappt oder versioniert werden, anstatt stillschweigend alte Namen zu verwenden. K-means ist ein nützliches Kompressions‑ und Segmentierungs‑Baseline, wenn seine Geometrie zur Fragestellung passt, nicht jedoch eine universelle Entdeckungs‑Engine.
Praktisches Beispiel: Kundensegmentierung mit k-means
Ein Abonnement‑Unternehmen standardisiert Nutzungsmerkmale über ein festes Zeitfenster, entfernt Konten‑Identifikatoren und testet k über verschiedene Seeds. Stabilität, Silhouette und zurückgehaltene Geschäftsergebnisse werden geprüft, aber Produktteams untersuchen auch repräsentative und Grenz‑Accounts. Sie entdecken, dass ein Cluster einfach neue Kunden mit kürzerer Beobachtungsdauer enthält, sodass die Vertragsdauer explizit behandelt wird. K-means wird mit hierarchischen und dichtebasierten Alternativen verglichen, anstatt als selbstverständlich passend angenommen zu werden. Die Übung wird als unüberwachtes Lernen behandelt, nicht als Label‑Entdeckung.
Segmente leiten Forschung und Messaging‑Experimente, nicht die Berechtigung oder Preisgestaltung. Neue Konten, die weit von allen Schwerpunkten entfernt sind, erhalten eine unbekannte Zuordnung. Skalierung, Merkmale, Schwerpunkte und Namen werden versioniert, und ein erneutes Training mappt neue Cluster nur mit Evidenz auf alte. Das Monitoring verfolgt Clustergröße, Distanz und Ergebnisrelevanz. Sensible Attribute und Proxy‑Variablen werden geprüft, und das Team vermeidet es, Cluster als natürliche Persönlichkeitstypen zu beschreiben, da sie mathematische Partitionen des ausgewählten Verhaltens sind.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Verantwortlichen und die Konsequenzen jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Ausgangsbasis und ein versioniertes Evaluierungsset vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Verantwortlichkeiten für Release, Ausnahmen, Änderungen, Rollback und Stilllegung zugewiesen werden. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion und prüfen Sie anschließend reale Evidenz nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung bestehen bleibt. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Ist K-means überwacht oder unüberwacht?
Es ist unüberwacht, weil es Merkmale und eine gewählte Anzahl von Clustern erhält, jedoch keine Ziel‑Labels.
Klassifiziert K-means neue Daten?
Nach dem Anpassen kann ein neuer Punkt seinem nächsten Schwerpunkt zugewiesen werden. Das ist eine Cluster‑Zuordnung, nicht unbedingt eine überwachte Klassen‑Vorhersage.
Primärreferenzen












