Grundlagen der KI
Was ist ein KNN (K-Nearest Neighbors)?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
K-nearest neighbors (KNN) sagt ein Ergebnis basierend auf den gekennzeichneten Trainingsbeispielen voraus, die dem Abfragepunkt am nächsten liegen. Bei der Klassifikation stimmen die Nachbarn über die Klasse ab. Bei der Regression werden ihre Zielwerte gemittelt oder anderweitig kombiniert.
KNN ist ein instanzbasiertes, nicht verallgemeinerndes Verfahren: das Training speichert im Wesentlichen die Trainingsbeispiele und optional einen Suchindex. Das beseitigt nicht die Notwendigkeit von Trainings‑, Validierungs‑ und Test‑Aufteilungen. Die Auswertung an zurückgehaltenen Daten ist entscheidend, um k, die Distanzmetrik, die Merkmalsverarbeitung und die Abstimmungsregel zu wählen.
Wesentliche Erkenntnisse
- KNN sagt lokal voraus; es teilt den Datensatz nicht zuerst in Cluster auf.
- Feature‑Scaling ist entscheidend, weil die Distanz bestimmt, welche Beispiele als Nachbarn gelten.
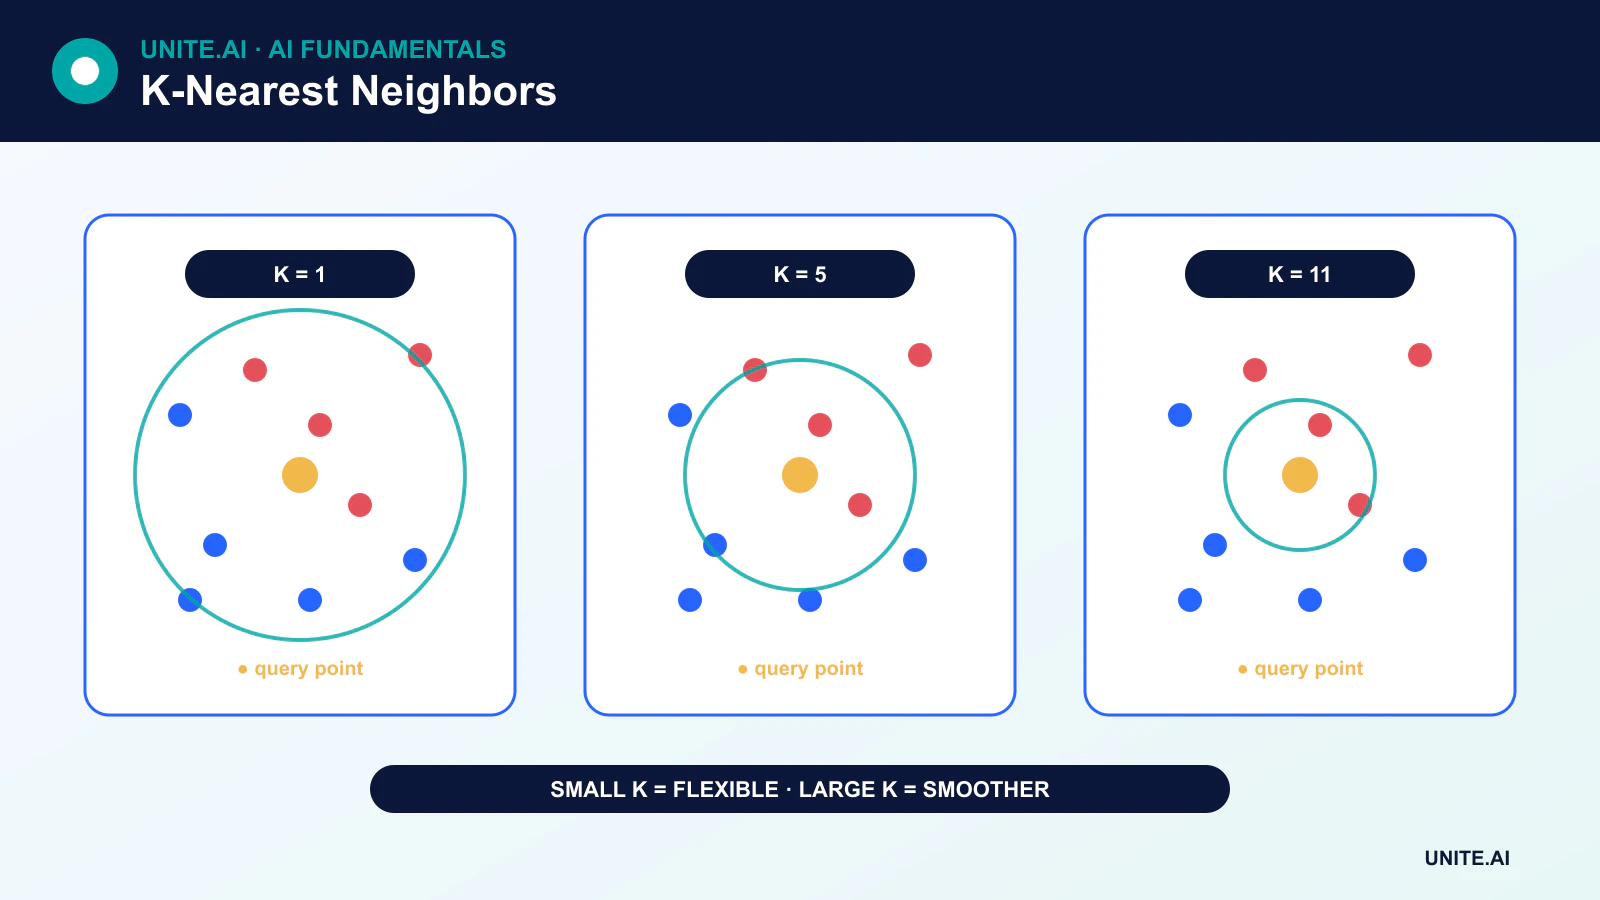
- Ein kleines k kann verrauscht sein, während ein großes k die lokale Struktur glätten kann.
- Hohe Dimensionalität, irrelevante Merkmale, Klassenungleichgewicht und langsame Suche können die Leistung einschränken.
Wie KNN‑Klassifikation funktioniert
- Stelle die Abfrage und die Trainingsbeispiele im selben Merkmalsraum dar.
- Berechne die Distanz von der Abfrage zu den Trainingsbeispielen.
- Wähle die k nächsten Beispiele aus.
- Sag die Mehrheitsklasse voraus oder verwende distanzgewichtete Abstimmung.
Distanzgewichtete Abstimmung gibt näheren Nachbarn mehr Einfluss. Bei Unentschieden ist eine dokumentierte Regel erforderlich, und Nachbarn mit gleicher Distanz aber unterschiedlichen Labels können das Ergebnis von der Reihenfolge oder Implementierungsdetails abhängig machen.
KNN‑Regression
Bei der Regression ist die Vorhersage üblicherweise der Mittelwert der Zielwerte benachbarter Beispiele. Distanzgewichtung kann den Einfluss weiter entfernter Beobachtungen verringern. Median‑ oder robuste Aggregation kann nützlich sein, wenn lokale Zielwerte Ausreißer enthalten.
Distanzmetriken
Die euklidische Distanz ist üblich für kontinuierliche Merkmale, die Manhattan‑Distanz summiert absolute Differenzen, und die Kosinus‑Distanz fokussiert auf die Richtung statt auf die Größe. Andere Metriken gelten für binäre, kategoriale, geografische, sequenzielle oder gelernte Einbettungsdaten.
KNN als „nicht‑parametrisch“ zu bezeichnen bedeutet, dass es keine feste, endlich‑dimensionale Funktionsform für die Entscheidungsgrenze annimmt. Es geht jedoch davon aus, dass die gewählte Darstellung und Metrik nahe Punkte zueinander relevant machen.
Warum Skalierung wichtig ist
Wenn ein Merkmal von 0 bis 1 reicht und ein anderes von 0 bis 100 000, wird die gewöhnliche euklidische Distanz vom zweiten Merkmal dominiert. Standardisierung, Normalisierung oder domänenspezifische Transformationen sollten auf dem Trainings‑Split angepasst und anschließend auf Validierungs‑, Test‑ und Produktionsdaten angewendet werden.
Irrelevante Merkmale verzerren ebenfalls Nachbarschaften. Merkmalsauswahl, Dimensionsreduktion oder gelernte Repräsentationen können helfen, doch jede Entscheidung muss ohne Datenleckage validiert werden.
Auswahl von k
Bei k = 1 kann das Modell Rauschen und falsch gekennzeichnete Beispiele nachverfolgen. Mit wachsendem k werden Vorhersagen glatter und weniger empfindlich gegenüber einzelnen Punkten. Wird k zu groß, dominieren entfernte Klassen oder Regionen und das Modell unterpasst.
Wähle k mittels Kreuzvalidierung auf den Trainingsdaten. Für binäre Klassifikation reduziert ein ungerades k Unentschieden, eliminiert sie aber nicht. Klassen‑Gewichte, stratifizierte Aufteilungen, Schwellenwertwahl und geeignete Metriken sind wichtig, wenn Klassen unausgewogen sind.
Der Fluch der Dimensionalität
In hochdimensionalen Räumen können Distanzen weniger aussagekräftig werden, weil Beispiele spärlich sind und die nächsten sowie entferntesten Distanzen relativ ähnlich werden. KNN kann enorme Datenmengen benötigen, um sinnvolle lokale Nachbarschaften aufrechtzuerhalten. Das ist der Fluch der Dimensionalität.
Dimensionalitätsreduktion oder aufgabenspezifische Einbettungen können helfen, aber die Geometrie einer Einbettung sollte für die beabsichtigte Ähnlichkeitsdefinition validiert werden.
Suchleistung
Eine brute‑force‑Abfrage vergleicht den neuen Punkt mit jedem gespeicherten Beispiel. KD‑Bäume und Ball‑Bäume beschleunigen einige exakte Suchen, obwohl ihr Nutzen in hohen Dimensionen abnimmt. Approximate‑Nearest‑Neighbor‑Indizes tauschen einen geringen Rückruf‑Verlust gegen große Geschwindigkeits‑ und Speichergewinne aus. Diese Idee liegt auch der Vektor‑Ähnlichkeitssuche zugrunde.
Stärken und Einschränkungen
KNN ist einfach, unterstützt unregelmäßige Entscheidungsgrenzen und liefert eine intuitive, beispielbasierte Erklärung. Es kann jedoch viel Speicher benötigen, sensible Trainingsbeispiele preisgeben, langsam vorhersagen und sich schlecht verhalten, wenn Distanz nicht sinnvoll ist. Es ist ein nützliches Basismodell – jedoch keine Methode, die standardmäßig bei den meisten Problemen hochgenau ist.
Distanz, Nachbarschaften und Hyperparameter‑Verhalten
K-nearest neighbors speichert Trainingsbeispiele und sagt basierend auf den k nächsten unter einer gewählten Distanz voraus. Die Klassifikation verwendet eine Mehrheits‑ oder distanzgewichtete Abstimmung; die Regression mittelt die Zielwerte der Nachbarn. Skalierung ist entscheidend, weil ein Merkmal mit großem Wertebereich die euklidische Distanz dominieren kann. Kategoriale, spärliche, sequenzielle oder geografische Daten können Hamming‑, Kosinus‑, Edit‑, Großkreis‑ oder gelernte Distanzen erfordern. Die Metrik ist eine Modellannahme über Ähnlichkeit und sollte gegen die tatsächliche Bedeutung nahe Fälle validiert werden.
Ein kleines k erzeugt flexible, hochvariante Grenzen und Empfindlichkeit gegenüber Rauschen; ein großes k glättet Vorhersagen und kann Minderheitsstrukturen auslöschen. Ein ungerades k vermeidet nur einige binäre Unentschieden und ist keine allgemeine Regel. Wähle k, Distanz, Gewichtung, Merkmalsmenge und Vorverarbeitung innerhalb der Kreuzvalidierung. Klassenungleichgewicht kann dazu führen, dass lokale Mehrheitsabstimmungen seltene Ergebnisse ignorieren, daher sollten Recall pro Klasse und Nachbarschaftszusammensetzung geprüft werden. Hochdimensionale Distanzen neigen zur Konzentration, und irrelevante Merkmale verschlechtern Nachbarschaften; Auswahl, Dimensionsreduktion oder gelernte Einbettungen können helfen.
Indexierung, Unsicherheit und Produktionseinsatz
Naive Inferenz vergleicht eine Abfrage mit jedem Trainingspunkt. KD‑Bäume und Ball‑Bäume helfen in geeigneten niedrigen Dimensionen; Approximate‑Nearest‑Neighbor‑Indizes tauschen Genauigkeit gegen Geschwindigkeit und Skalierbarkeit. Miss die Rückruf‑Rate der Nachbarschaftssuche separat von der Vorhersagequalität. Der Speicher umfasst gespeicherte Merkmale, Labels und Indexstrukturen. Updates sind konzeptionell einfach, können jedoch Index‑Neuerstellungen, Versionskonsistenz und Lösch‑Propagation erfordern. Schütze sensible Trainingsbeispiele, da das Zurückgeben von Nachbarn oder Distanzen Datensätze preisgeben kann.
KNN kann Beispiele bereitstellen, die eine Vorhersage nachvollziehbar machen, aber Nähe ist weder Kausalität noch Fairness. Gib Distanz, Abstimmungs‑Margin und eine Abstimmungs‑Regel an, wenn Nachbarschaften spärlich oder widersprüchlich sind. Überwache Abfrage‑Distanz, Nachbar‑Labels, Feature‑Drift, Latenz und bestätigte Ergebnisse. Halte Vorverarbeitung und Index‑Versionen synchron und teste exakte gegenüber approximativen Ergebnissen nach Änderungen. KNN ist ein effektives lokales Basismodell und Retrieval‑Verfahren, wenn die Distanz sinnvoll ist; es hat Schwierigkeiten, wenn Ähnlichkeit nicht durch die verfügbaren Merkmale dargestellt werden kann.
Praktisches Beispiel: KNN für Produktersatz
Ein Händler repräsentiert Produkte mit standardisierten numerischen Attributen, kategorialer Kompatibilität und einer gelernten Texteinbettung und definiert anschließend eine von Merchandisern geprüfte gewichtete Distanz. K und Gewichte werden anhand späterer Produkteinführungen ausgewählt, nicht anhand zufälliger Artikelzeilen. Die Bewertung prüft den relevanten Ersatz‑Recall, inkompatible Empfehlungen, Distanz, Kategoriedeckung und Ergebnisse für seltene Artikel. Ein Beliebtheits‑Baseline zeigt, ob lokale Ähnlichkeit Mehrwert liefert.
Ein approximativer Index wird gegen exakte Nachbarn hinsichtlich Recall und Latenz benchmarked. Abfragen ohne nahen kompatiblen Artikel geben keinen Vorschlag zurück, anstatt einen erzwungenen Nachbarn zu liefern. Produktlöschungen und Attributkorrekturen werden über versionierte Updates in den Index propagiert. Das Monitoring verfolgt Distanzverteilungen, leere Ergebnisse, Overrides und kommerzielle Resultate, ohne Verkäufe mit echter Kompatibilität zu verwechseln. Sensible Lieferantenbedingungen werden aus Erklärungen ausgeschlossen, und zurückgegebene Beispiele bleiben ein Hinweis auf Ähnlichkeit – nicht die Behauptung, dass Produkte gleichwertig sind.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definiere die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Verantwortliche und die Konsequenzen jedes wichtigen Fehlers. Etabliere ein reproduzierbares Baseline‑Modell und einen versionierten Evaluationsdatensatz vor dem Tuning. Teste reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Datenverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Miss die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentiere jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Beweise von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout sollte die Zuständigkeit für Veröffentlichung, Ausnahmen, Änderungen, Rollbacks und Stilllegung zugewiesen werden. Nutze ein gestuftes Rollout, bewahre ein sicheres Fallback und prüfe das Monitoring mit bewusst eingespeisten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definiere Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfe dann reale Evidenz nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Hat KNN eine Trainingsphase?
Es gibt nur wenig Parameteranpassung, aber es hat dennoch einen Entwicklungsprozess: Vorverarbeitung wird aus den Trainingsdaten gelernt, ein Index kann erstellt werden, und k, Metrik, Gewichte und Merkmale werden mittels Validierung ausgewählt.
Ist KNN dasselbe wie K-means?
Nein. KNN ist primär ein überwacht‑lokales Vorhersageverfahren. K-means ist ein unbeaufsichtigter Clustering‑Algorithmus, bei dem K die Anzahl der Cluster‑Zentren ist.
Primärreferenzen