
Grundlagen der KI
Was ist ein Generatives Adversarial Network (GAN)?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
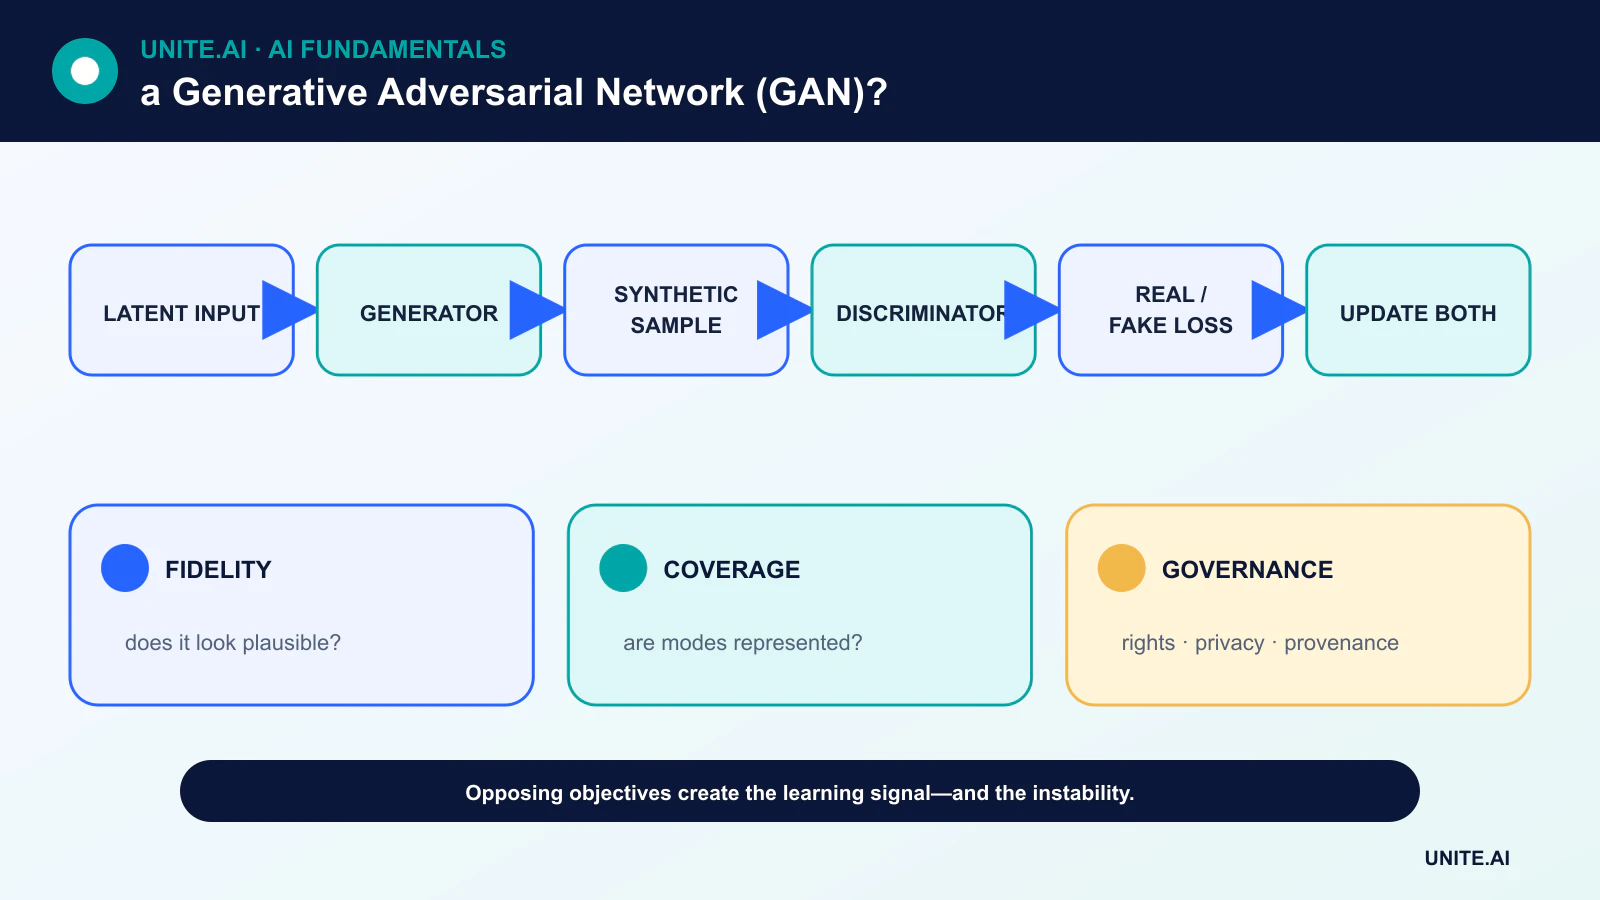
generatives adversariales Netzwerk (GAN) trainiert zwei neuronale Netze im Wettbewerb. Ein Generator wandelt zufällige oder bedingte Eingaben in synthetische Stichproben um. Ein Diskriminator versucht, erzeugte Stichproben von echten Trainingsbeispielen zu unterscheiden. Das Feedback jedes Netzwerks ändert das Lernproblem des anderen.
GANs können scharfe Bilder und kontrollierbare synthetische Daten erzeugen, doch das adversarielle Training ist schwer zu stabilisieren. Visuelle Realitätsnähe beweist weder Vielfalt, faktische Gültigkeit noch die Erlaubnis zur Nutzung der Trainingsdaten.
Wesentliche Erkenntnisse
- Der Generator erzeugt Stichproben; der Diskriminator lernt ein Entscheidungssignal zwischen echt und generiert.
- Das Training strebt ein Gleichgewicht an, doch wechselnde Gegner können Instabilität, Oszillation oder Modus‑Kollaps verursachen.
- Bedingte GANs steuern die Erzeugung mittels Labels, Text oder anderem Kontext.
- Die Bewertung sollte Treue, Abdeckung, Memorierung und nachgelagerte Risiken prüfen – nicht nur die Bildqualität.
Das adversarielle Spiel
Die ursprüngliche Formulierung ist ein Zwei‑Spieler‑Minimax‑Spiel. Der Diskriminator verbessert seine Fähigkeit, reale Daten von generierten Daten zu trennen, während der Generator besser darin wird, Stichproben zu erzeugen, die der Diskriminator als echt klassifiziert. Beide werden mittels Backpropagation trainiert.
Wird der Diskriminator zu genau, kann sein Feedback für den Generator wenig nützlich sein. Ist er zu schwach, kann der Generator leichte Abkürzungen ausnutzen. Das Training wechselt daher die Aktualisierungen und balanciert Kapazität, Verlustfunktionen und Optimierungseinstellungen sorgfältig.
Modus‑Kollaps und Trainingsstabilität
Modus‑Kollaps tritt auf, wenn viele latente Eingaben ähnliche Ausgaben erzeugen, sodass die Stichproben plausibel wirken, aber nur einen Teil der Datenverteilung abdecken. Weitere Fehler umfassen Oszillation, explodierende Gradienten und Empfindlichkeit gegenüber zufälliger Initialisierung.
Wasserstein‑Ziele, Gradienten‑Penalties, spektrale Normalisierung, architektonische Änderungen und abgestimmte Update‑Verhältnisse können die Stabilität verbessern. Sie ersetzen jedoch nicht die Notwendigkeit, die Vielfalt zu prüfen und Experimente mit mehreren Zufallssamen zu wiederholen.
Bedingte Erzeugung und latente Kontrolle
Ein bedingtes GAN versorgt Generator und Diskriminator mit einem Label oder anderem Kontext, wodurch gezielte Klassen oder Attribute ermöglicht werden. Stilbasierte Architekturen trennen Aspekte der latenten Kontrolle auf verschiedenen Auflösungen und haben hochrealistische Bilder erzeugt.
Latente Richtungen können mit menschlichen Konzepten korrelieren, doch die Bearbeitung eines Attributs kann andere verändern, weil die Trainingsdaten korrelierte Merkmale enthalten. Behauptungen zur Kontrollierbarkeit sollten über verschiedene Identitäten und Kontexte hinweg getestet werden.
Bewertung, Datenschutz und Herkunft
Metriken wie der Fréchet Inception Distance vergleichen Merkmalsverteilungen, übernehmen jedoch Annahmen des Merkmalsmodells und können Memorierung oder Fehlfunktionen in Untergruppen übersehen. Nearest‑Neighbor‑Analysen, Präzisions‑/Recall‑artige Abdeckungstests und menschliche Prüfungen liefern ergänzende Evidenz.
Ein GAN kann seltene Beispiele memorisieren, Vorurteile reproduzieren oder täuschende Medien erzeugen. Teams sollten Datensätze, Rechte, Filterungen, Wasserzeichen‑ oder Herkunftsmechanismen sowie Missbrauchskontrollen dokumentieren. Synthetische Daten sind nicht automatisch anonym.
GANs, VAEs und Diffusionsmodelle
Variationale Autoencoder optimieren ein wahrscheinlichkeitbasiertes latentes Ziel und tauschen häufig Bildschärfe gegen einen strukturierten latenten Raum. Diffusionsmodelle lernen, einen Rauschprozess umzukehren, und haben sich zu einer verbreiteten Grundlage für die Bildgenerierung entwickelt.
GANs bleiben nützlich, wenn schnelle Ein‑Pass‑Stichproben, spezifische Bild‑zu‑Bild‑Abbildungen oder kompakte Bereitstellung wichtig sind. Die geeignete Methode hängt von Qualität, Vielfalt, Latenz, Trainingsstabilität und Governance ab – nicht davon, welche Architektur am neuesten ist.
Adversarielle Ziele und Trainingsdynamik
Ein generatives adversariales Netzwerk trainiert einen Generator, um Stichproben zu erzeugen, und einen Diskriminator, um generierte von echten Daten zu unterscheiden. Im ursprünglichen Minimax‑Spiel schätzt der Diskriminator ein signal, das mit dem Dichte‑Verhältnis zusammenhängt, und der Generator versucht, ihn zu täuschen. Das Training wechselt die Aktualisierungen, sodass jedes Netzwerk gegen einen sich bewegenden Gegner statt gegen einen festen Verlust lernt. Wird der Diskriminator zu stark, können die Gradienten des Generators wenig hilfreich sein; ist er zu schwach, stagniert die Qualität der erzeugten Daten. Der reine Verlustwert korreliert nicht direkt mit der Stichprobenqualität.
Modus‑Kollaps tritt auf, wenn der Generator nur begrenzte Varianten erzeugt, die den Diskriminator täuschen. Oszillation, Empfindlichkeit gegenüber Hyperparametern und instabile Normalisierung sind ebenfalls häufig. Wasserstein‑Ziele, Gradienten‑Penalties, spektrale Normalisierung, Feature‑Matching, Minibatch‑Statistiken und sorgfältig ausbalancierte Update‑Pläne adressieren verschiedene Fehlermodi. Bedingte GANs verwenden Labels, Text oder Bilder, um die Ausgabe zu steuern; stilbasierte Architekturen trennen latente Einflüsse. Die Qualität und Abdeckung des Datensatzes bleiben grundlegend, da der Generator die Verteilung, die er sieht, reproduziert und neu kombiniert.
Bewertung und verantwortungsbewusste Nutzung
Bewerten Sie Treue und Vielfalt getrennt. Der Fréchet Inception Distance vergleicht Merkmalsverteilungen, hängt jedoch von Stichprobengröße, Merkmalsmodell, Vorverarbeitung und Domäne ab; der Inception Score verzichtet auf den Vergleich mit echten Daten. Präzision und Recall für generative Modelle, Nearest‑Neighbor‑Analysen, Memorierungs‑Checks und menschliche Aufgabenbewertungen liefern zusätzliche Evidenz. Für wissenschaftliche oder medizinische Synthese sollten domänenspezifische Metriken und nachgelagerte Validierung verwendet werden. Bewahren Sie einen zurückgehaltenen echten Datensatz auf und vergleichen Sie mit Diffusions‑ oder autoregressiven Baselines bei gleicher Rechenleistung und Auflösung.
GANs können Daten ergänzen, Domänen übersetzen, Bilder hochskalieren, Medien synthetisieren und Simulationen unterstützen, doch synthetische Daten können Vorurteile verstärken oder Trainingsbeispiele preisgeben. Prüfen Sie Lizenzierung, Einwilligung, Identität und Herkunft. Schützen Sie vor nicht einvernehmlicher Nachahmung und täuschender Nutzung, kennzeichnen oder signieren Sie Ausgaben, wo nötig, und bewahren Sie Metadaten der Erzeugung auf. Ein fotorealistisches Bild ist kein Dokumentationsbeweis; Unsicherheit und synthetische Herkunft müssen sichtbar bleiben, wenn die Ergebnisse Entscheidungen beeinflussen.
Bereitstellung und Reproduzierbarkeit
Protokollieren Sie Generator, Diskriminator, Optimierer, Datensatz, Zufallsseed, Trunkierung und Sampling‑Einstellungen. Quantisierung oder Export können Normalisierung und Ausgabe verändern, daher sollte das bereitgestellte Artefakt validiert werden. Überwachen Sie die Verteilung von Eingabeaufforderungen oder Bedingungen, Sicherheitsfilter, Ausgabevielfalt, Latenz und Berichte. Verwenden Sie Ratenbegrenzungen und Identitätsschutz in öffentlichen Systemen. Das Training von GANs ist ein gekoppeltes Optimierungsexperiment: ausgewählte Beispielbilder können keine Robustheit, Abdeckung oder das Fehlen von Memorierung beweisen, und ein Modell sollte auf der gesamten Verteilung der beabsichtigten Generierungsaufgaben evaluiert werden.
Praktisches Beispiel: synthetische Defektbilder mit einem GAN
Ein Hersteller trainiert ein bedingtes GAN, um seltene Oberflächen‑Defektbilder zu erzeugen. Er prüft, dass die Trainingsbilder Rechte besitzen und trennt Produktionschargen vor dem Training und der Bewertung. Generierte Stichproben werden auf Nearest‑Neighbor‑Memorierung, Defektgeometrie, Hintergrundartefakte, Vielfalt und fachliche Plausibilität geprüft. Ein mit synthetischer Augmentierung trainierter Klassifikator wird ausschließlich an unabhängigen echten Defekten evaluiert, im Vergleich zum gleichen Klassifikator mit konventioneller Augmentierung.
Synthetische Daten werden nur akzeptiert, wenn der Recall in der Praxis steigt, ohne dass Fehlablehnungen oder Untergruppen‑Fehler zunehmen. Generierungseinstellungen und Herkunft bleiben an jedem Bild verankert, und synthetische Dateien gelangen niemals in den Test‑ oder Beweis‑Archiv als echte Inspektionen. Bediener können den Generator nicht nutzen, um Prüfungsnachweise zu fälschen. Das Team vergleicht Diffusions‑Alternativen und die Kosten für die Erhebung weiterer realer Beispiele und erkennt, dass ein realistisches Erscheinungsbild nicht beweist, dass das GAN den physikalischen Fehlprozess erfasst hat.
Implementierungsnachweis und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Verantwortlichen und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluationsdatensatz vor der Feinabstimmung. Testen Sie normale Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am ehesten benachteiligt werden. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout sollten Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollbacks und Stilllegung festgelegt werden. Verwenden Sie eine gestufte Einführung, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit gezielt injizierten Fehlfunktionen. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, die Modell‑ oder Regelversion, den Zustand von Abhängigkeiten, menschliche Eingriffe und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und prüfen Sie nach der Bereitstellung reale Evidenz, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Zeitpunkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Versteht ein GAN die Bilder, die es erzeugt?
Ein GAN lernt statistische Strukturen, die für die Erzeugung nützlich sind. Das allein begründet jedoch kein menschliches, semantisches oder kausales Verständnis.
Sind von GANs erzeugte Stichproben sicher als Trainingsdaten zu verwenden?
Nur nach Prüfung von Abdeckung, Label‑Gültigkeit, Memorierung, Verzerrungen und ob die synthetische Verteilung auf einem echten, zurückgehaltenen Testdatensatz hilft.
Primärreferenzen












