
Grundlagen der KI
Was ist Deep Reinforcement Learning?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
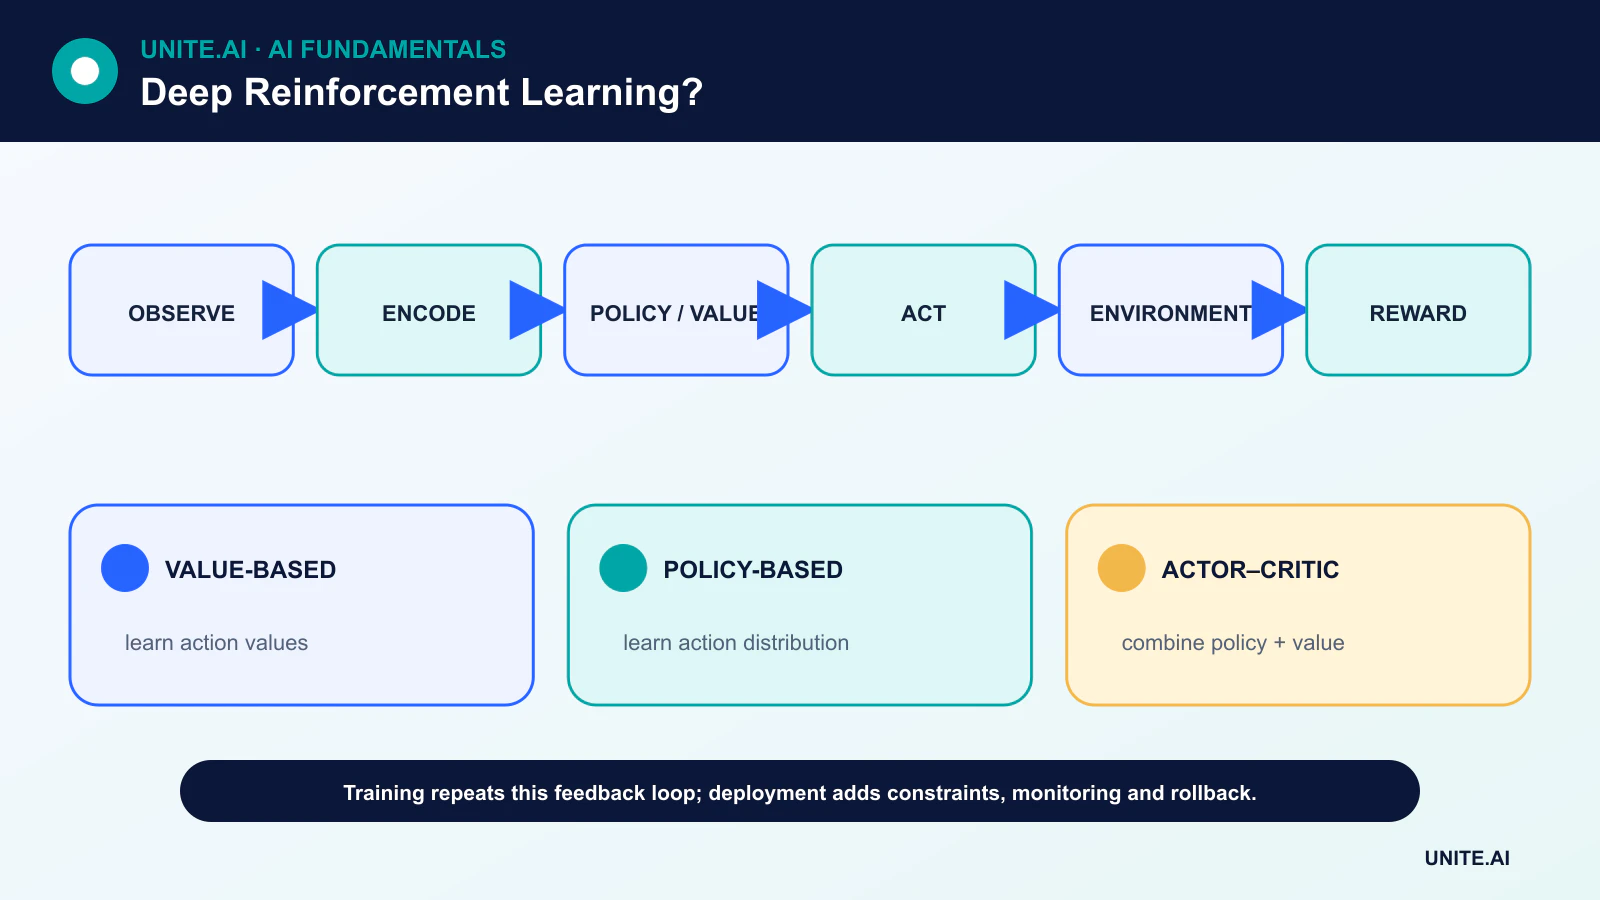
Deep Reinforcement Learning (deep RL) kombiniert Reinforcement Learning mit tiefen neuronalen Netzen. Ein Agent beobachtet einen Zustand, wählt eine Aktion, erhält eine Belohnung und eine neue Beobachtung und passt anschließend eine Politik oder Wertfunktion an, um zukünftige Entscheidungen zu verbessern.
Das tiefe Netzwerk beseitigt nicht die schwierigen Aspekte des Reinforcement Learning. Es bietet eine flexible Möglichkeit, Bilder, Sensorsignale, große Aktionsräume oder komplexe Wertfunktionen darzustellen. Exploration, verzögerte Rückmeldung, instabiles Training und sichere Evaluation in der realen Welt bleiben zentrale ingenieurtechnische Probleme.
Wesentliche Erkenntnisse
- Deep RL lernt sequenzielle Entscheidungen aus Interaktionen statt aus einer festen Tabelle gelabelter Beispiele.
- Wertbasierte Methoden schätzen, wie gut Aktionen sind; Politik‑Methoden lernen die Aktionsverteilung direkt; Actor‑Critic‑Methoden kombinieren beides.
- Replay‑Puffer, Zielnetzwerke und sorgfältige Belohnungsgestaltung können das Training verbessern, aber keines garantiert zuverlässiges Verhalten.
- Ein hoher Simulatorscore beweist weder Robustheit, Sicherheit noch einen erfolgreichen Transfer in die physische Welt.
Das Entscheidungsproblem: Zustände, Aktionen und Belohnungen
Viele Deep‑RL‑Aufgaben werden als Markov‑Entscheidungsprozess modelliert. Zum Zeitpunkt t erhält der Agent den Zustand oder die Beobachtung st, wählt die Aktion at und erhält anschließend die Belohnung rt+1 sowie den nächsten Zustand. Das Ziel ist die erwartete, diskontierte Rückkehr, nicht nur die unmittelbar nächste Belohnung.
Der Diskontfaktor bestimmt, wie stark entfernte Belohnungen gewichtet werden. Eine Belohnungsfunktion legt fest, was der Optimierungsprozess verfolgt; ein unvollständiger Proxy kann ein Verhalten erzeugen, das technisch erfolgreich, aber betrieblich unerwünscht ist. Deshalb verdienen Belohnungsdesign und Constraint‑Tests dieselbe Aufmerksamkeit wie die Modellarchitektur.
Wertbasierte, politikbasierte und Actor‑Critic‑Methoden
Ein wertbasierter Algorithmus schätzt einen Zustandswert oder Aktionswert. Deep‑Q‑Netzwerke nutzen ein neuronales Netz, um Q‑Werte zu approximieren, und wählen typischerweise die Aktion mit der höchsten Schätzung, wobei ein gewisses Maß an Exploration erhalten bleibt. Ein Policy‑Gradient‑Algorithmus optimiert stattdessen eine parametrische Politik, die eine Aktionsverteilung ausgibt.
Actor‑Critic‑Systeme besitzen sowohl einen Actor, der Aktionen vorschlägt, als auch einen Critic, der deren Wert schätzt. Dieses Design unterstützt kontinuierliche Steuerung, führt jedoch zu interagierenden Quellen von Schätzfehlern. Deep RL beruht daher auf denselben Grundlagen wie deep learning, gradient descent und backpropagation.
Warum Replay‑Puffer und Zielnetzwerke helfen
Aufeinanderfolgende Erfahrungssamples sind korreliert, während ein Netzwerk‑Update die von späteren Updates genutzten Ziele verändert. Experience Replay bricht einen Teil dieser zeitlichen Korrelation, indem ältere Transitionen zufällig ausgewählt werden. Ein Zielnetzwerk ändert sich langsamer als das Online‑Netzwerk, wodurch bootstrappte Ziele weniger volatil werden.
Diese Mechanismen verbessern die Trainingsstabilität, aber die Feinabstimmung bleibt wichtig. Lernrate, Explorationsplan, Belohnungsskala, Replay‑Zusammensetzung und Netzwerk‑Kapazität können das Ergebnis beeinflussen. Mehrere Zufalls‑Seeds sollten angegeben werden, da ein einzelner Lauf irreführend sein kann.
Offline‑RL, modellbasiertes RL und Sim‑zu‑Real
Offline‑RL lernt aus einem festen, protokollierten Datensatz, ohne neue Interaktionen zu sammeln. Es kann nützlich sein, wenn Exploration kostenintensiv oder unsicher ist, aber die Politik muss Aktionen vermeiden, die im Log kaum vertreten sind. Modellbasiertes RL lernt oder nutzt ein Übergangsmodell zur Planung und tauscht zusätzliche Annahmen gegen Stichprobeneffizienz aus.
In der Robotik wird häufig in Simulationen trainiert, physikalische Parameter randomisiert und anschließend auf Hardware feinjustiert oder validiert. Die Realitätslücke kann weiterhin Fehler in Wahrnehmung, Timing, Kontaktdynamik und nicht modellierten Randfällen offenbaren. Ein reinforcement‑learning-System sollte unter Störungen, Verteilungsverschiebungen und expliziten Sicherheitsbeschränkungen evaluiert werden.
Evaluation und Bereitstellung
Eine sinnvolle Evaluation trennt Trainings‑ und Testumgebungen, gibt Rückkehr‑Verteilungen anstelle eines einzigen Bestwerts aus und prüft Verstöße gegen Beschränkungen, Eingriffs‑Häufigkeit sowie das Worst‑Case‑Verhalten. Für reale Systeme benötigen Teams zudem Überwachung, Rollback‑Verfahren, begrenzte Aktionsräume und eine menschliche Übersteuerung.
Deep RL ist besonders überzeugend, wenn Entscheidungen sequenziell sind, Feedback verfügbar ist und handgeschriebene Steuerungsregeln unzureichend sind. Es ist eine schlechte Wahl, wenn überwachte Labels im Überfluss vorhanden sind, ein konventioneller Optimierer das Problem löst oder Exploration Menschen oder Vermögenswerte gefährden würde.
Deep‑RL‑Architekturen und Trainingssignale
Deep Reinforcement Learning verwendet neuronale Netze, um eine Wertfunktion, Politik, Umgebungsmodell oder eine Kombination davon darzustellen. Ein Deep‑Q‑Netzwerk sagt Aktionswerte voraus und lernt aus Temporal‑Difference‑Zielen; Experience Replay reduziert die Korrelation zwischen Updates, während ein Zielnetzwerk das bewegliche Ziel stabilisiert. Policy‑Gradient‑Methoden optimieren die erwartete Rückkehr direkt, und Actor‑Critic‑Methoden nutzen einen gelernten Critic, um die Gradientenvarianz zu reduzieren. Kontinuierliche Aktionen erfordern häufig deterministische oder stochastische Actor‑Critic‑Varianten, während diskrete hochdimensionale Aktionen sorgfältige Exploration und Ausgabegestaltung benötigen.
Das Training ist nicht stationär, weil die Politik die gesammelten Daten verändert. Replay‑Daten werden off‑policy, bootstrappte Ziele hängen von aktuellen Schätzungen ab, und Funktionsapproximation kann Fehler verstärken – die Kombination wird manchmal als die tödliche Triade bezeichnet. Doppelte Schätzer reduzieren die Überbewertung von Werten; Advantage‑Funktionen verbessern die Kreditzuweisung; Entropie‑Bonusse fördern Exploration; abgeschnittene Ziele verhindern destruktive Politik‑Updates. Beobachtungen und Belohnungen sollten nur mit einem leak‑sicheren Zustand normalisiert werden, und Umgebung, Wrapper, Aktionswiederholung, Terminierung sowie Belohnungs‑Preprocessing sollten aufgezeichnet werden, da jeder das Problem verändert.
Evaluation, Simulatoren und Sicherheit bei der Bereitstellung
Geben Sie Rückkehr‑Verteilungen über unabhängige Seeds und Umgebungsinstanzen an, nicht nur den besten Lauf. Bewerten Sie Stichprobeneffizienz, Verstöße gegen Beschränkungen, katastrophale Ergebnisse, Empfindlichkeit gegenüber der Belohnungsskala und Robustheit gegenüber Beobachtungsrauschen, Verzögerungen, Aktuatorfehlern und geänderten Dynamiken. Vergleichen Sie mit skriptgesteuerter Regelung, klassischer Regelung, überwachter Imitation und einfacheren RL‑Ansätzen. Halten Sie Umweltvariationen zurück und testen Sie belohnungsfreie Ergebnismetriken, da ein Agent die programmierte Belohnung ausnutzen kann, während er die beabsichtigte Aufgabe verfehlt. Video‑ und Trajektorien‑Inspektionen enthüllen häufig Verhalten, das durch aggregierte Rückkehr verborgen bleibt.
Simulation ermöglicht Exploration, führt jedoch zu einer Realitätslücke. Randomisieren Sie relevante Physik und Wahrnehmung, kalibrieren Sie anhand realer Messungen und verwenden Sie einen konservativen Transfer. Protokollierte Daten oder Offline‑RL vermeiden Online‑Exploration, können jedoch Aktionen, die von der Verhaltens‑Politik nicht unterstützt werden, nicht zuverlässig bewerten. Produktionssysteme sollten den Aktionssatz, die Rate, Ressourcen und das Betriebsenvelop begrenzen; Genehmigungen für hochwirksame Aktionen verlangen und einen verifizierten sicheren Controller oder Stopp‑Mechanismus einbinden. Überwachen Sie Policy‑Eingaben, Aktionsverteilung, Belohnung, reale Ergebnisse und Eingriffe, mit Rollback zu einer getesteten Policy‑Version.
Ein konkretes Steuerungsbeispiel
Für die Routenplanung von Lagerrobotern definieren Sie den Zustand anhand von Standort, Last, Batteriestatus, nahegelegenem Verkehr und Aufgabenwarteschlange; Aktionen basieren auf zulässigen Bewegungen und Ladestrategien; die Belohnung ergibt sich aus erledigter Arbeit, Energieverbrauch, Stau und Sicherheitsbeschränkungen. Trainieren Sie zunächst in einem kalibrierten Simulator mit randomisiertem Bedarf und Sensorschäden und übernehmen Sie anschließend reale Entscheidungen im Schattenbetrieb. Lassen Sie die gelernte Politik niemals die Kollisionsvermeidung umgehen. Bewerten Sie den Durchsatz zusammen mit Beinahe‑Unfällen, Deadlocks, Batterie‑Notfällen und Worst‑Case‑Verzögerungen. Das Projekt ist nur erfolgreich, wenn das gestapelte System die Abläufe verbessert, ohne ein unakzeptables Explorationsrisiko auf Personen oder Geräte zu übertragen.
Praktisches Beispiel: DRL für die Kühlung von Rechenzentren
Ein Rechenzentrum beschränkt einen RL‑Agenten auf genehmigte Kühl‑Sollwerte und trainiert ihn in einem Simulator, der aus historischen Wetterdaten, Workload, Temperaturen und Geräteantworten kalibriert wurde. Die Belohnung umfasst Energie, während harte Beschränkungen separat Temperatur, Luftfeuchtigkeit und Gerätezyklen schützen. Model‑Predictive‑Control und bestehende Regeln dienen als Baselines. Die Evaluation erstreckt sich über Jahreszeiten, Sensorsignale, Aktuatordelay, Geräteaussfälle, ungewöhnliche Lasten und mehrere Seeds und berichtet Energieverbrauch, Verstöße, Varianz und Wiederherstellung.
Die gelernte Politik läuft im Schattenmodus, bevor ein begrenzter Zonenversuch durchgeführt wird. Ein externer Sicherheitscontroller beschneidet Aktionen und Bediener können übersteuern. Aktionsrate, Zustandsabdeckung, Modellunsicherheit und tatsächliche Anlagenresultate werden überwacht; ein Simulations‑Mismatch oder wiederholte Eingriffe lösen einen Rollback aus. Aktualisierte Geräte oder Steuerungslogik erzeugen eine neue Umgebungs‑Version und Validierung. Energieeinsparungen werden nur akzeptiert, wenn Zuverlässigkeit, thermische Reserve, Wartung und Reaktion auf Fehler mindestens so stark wie die Basislinie bleiben.
Implementierungsnachweise und betriebliche Bereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Feintuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Nachweise von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zugewiesen werden. Verwenden Sie eine gestufte Einführung, bewahren Sie ein sicheres Fallback und verifizieren Sie das Monitoring mit bewusst eingespielten Fehlfunktionen. Operative Telemetrie sollte die Eingabequalität, das Ausgabeverhalten, die Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Übersteuerungen und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und prüfen Sie anschließend reale Evidenz nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Vorfalls‑Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist Deep Reinforcement Learning dasselbe wie Deep Learning?
Nein. Deep Learning liefert die Funktionsapproximationen; Reinforcement Learning liefert die Interaktion, die Belohnung und das Ziel sequenzieller Entscheidungen.
Bedeutet eine hohe Belohnung, dass der Agent das gewünschte Verhalten erlernt hat?
Nicht unbedingt. Es bedeutet, dass die Politik ein Verhalten gefunden hat, das unter der implementierten Belohnung und Umgebung gut abschneidet. Unabhängige Sicherheits‑ und Ziel‑Ausrichtungstests sind weiterhin erforderlich.
Primärreferenzen












