
Grundlagen der KI
Was ist Reinforcement Learning?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
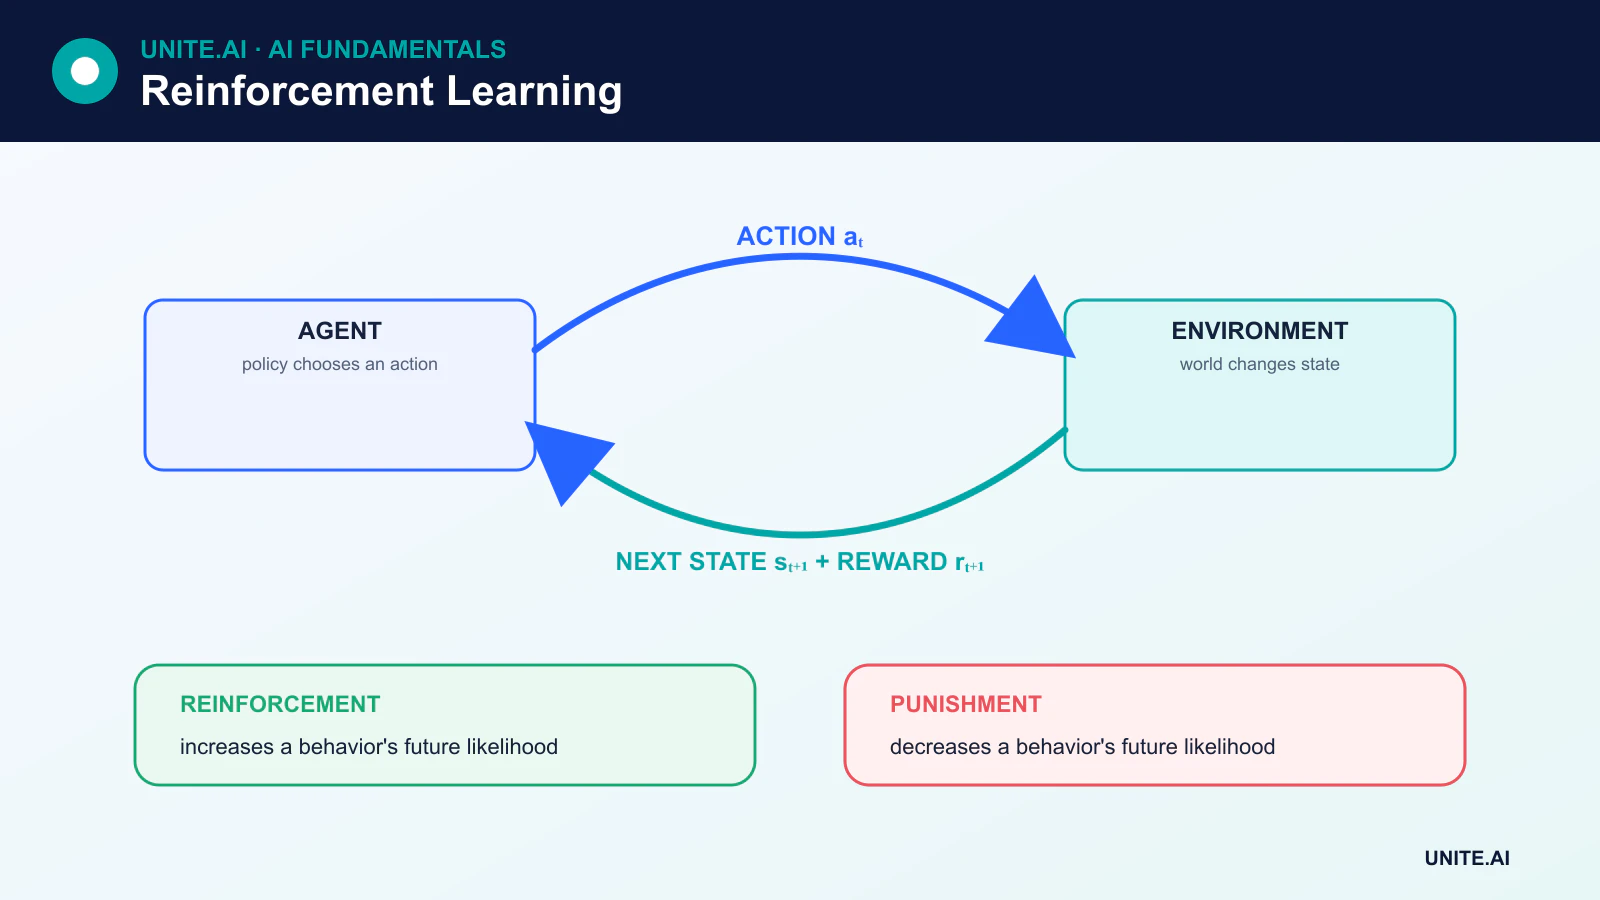
Reinforcement Learning (RL) ist ein Machine-Learning‑Framework, bei dem ein Agent lernt, wie er handeln soll, indem er mit einer Umgebung interagiert. Nach jeder Aktion ändert sich die Umgebung und kann eine Belohnung zurückgeben. Das Ziel des Agenten ist es, eine Politik zu erlernen, die die erwartete kumulative Belohnung maximiert, nicht nur die Belohnung des nächsten Schrittes.
RL wird eingesetzt, wenn Entscheidungen über die Zeit hinweg getroffen werden und eine Aktion das Folgende beeinflusst. Es unterscheidet sich konzeptionell vom überwachten Lernen, bei dem ein Datensatz für jedes Trainingsbeispiel eine Zielantwort liefert.
Wesentliche Erkenntnisse
- Ein RL‑Problem enthält einen Agenten, eine Umgebung, Zustände, Aktionen, Belohnungen und eine Politik.
- Positive und negative Verstärkung erhöhen beide das Verhalten; Bestrafung verringert das Verhalten.
- Der Agent muss das Erkunden unbekannter Aktionen mit dem Ausnutzen bereits bekannter, funktionierender Aktionen ausbalancieren.
- Wertbasierte, politikbasierte, Actor‑Critic‑, modellbasierte und Offline‑Methoden lösen unterschiedliche RL‑Szenarien.
Die Komponenten des Reinforcement Learning
Viele RL‑Probleme werden als Markov-Entscheidungsprozess (MDP) modelliert. Ein MDP umfasst:
- Zustand: Informationen, die die aktuelle Situation beschreiben.
- Aktion: eine dem Agenten zur Verfügung stehende Wahl.
- Übergang: wie sich der Zustand nach einer Aktion ändert.
- Belohnung: unmittelbares Feedback, das durch einen Übergang erzeugt wird.
- Politik: die Strategie des Agenten zur Auswahl von Aktionen.
- Discount‑Faktor: wie stark zukünftige Belohnungen im Vergleich zu unmittelbaren Belohnungen gewichtet werden.
Ein Zustand muss nicht alles über die Welt offenbaren. Wenn wichtige Informationen verborgen sind, kann das Problem teilweise beobachtbar sein und der Agent benötigt möglicherweise ein Gedächtnis oder einen Glaubenszustand.
Verstärkung ist nicht dasselbe wie Bestrafung
Die Terminologie stammt aus der Verhaltenspsychologie. Positive Verstärkung fügt eine Konsequenz hinzu, die ein Verhalten wahrscheinlicher macht. Negative Verstärkung entfernt einen unangenehmen Zustand und erhöht ebenfalls die Wahrscheinlichkeit eines Verhaltens. Eine Strafe, die dazu gedacht ist, eine Handlung weniger wahrscheinlich zu machen, ist Bestrafung, nicht negative Verstärkung.
Im Machine Learning sprechen Praktiker häufiger direkt von positiven Belohnungen, negativen Belohnungen, Kosten und Strafen. Das Wesentliche ist, wie diese Signale die Rückgabe formen, die der Agent zu maximieren versucht.
Rückgabe, Wert und Kreditzuweisung
Eine Belohnung beschreibt einen Übergang. Die Rückgabe kombiniert Belohnungen über die Zeit hinweg, wobei in der Regel zukünftige Belohnungen abgezinst werden. Eine Zustandswertfunktion schätzt die erwartete Rückgabe aus einem Zustand, während eine Aktionswertfunktion die erwartete Rückgabe nach Ausführung einer bestimmten Aktion in diesem Zustand schätzt.
Damit entsteht das Kreditzuweisungs‑Problem: Wenn ein nützliches Ergebnis erst viel später eintritt, welche früheren Aktionen verdienen die Anerkennung? RL‑Algorithmen unterscheiden sich darin, wie sie diese Beziehung schätzen.
Monte‑Carlo‑ und Temporal‑Difference‑Lernen
Monte‑Carlo‑Methoden lernen aus vollständigen gesampelten Rückgaben, typischerweise nach dem Ende einer Episode. Temporal‑Difference‑Methoden (TD) aktualisieren eine Schätzung vor dem endgültigen Ergebnis, indem sie die beobachtete Belohnung mit einer Schätzung des Folgenden kombinieren. TD‑Lernen bootstrapt daher aus den aktuellen Wertschätzungen.
Keine der beiden Familien ist allgemein überlegen. Monte‑Carlo‑Ziele sind unter der gesampelten Politik unverzerrt, können jedoch eine hohe Varianz aufweisen und erfordern den Abschluss einer Episode. TD‑Methoden können online und aus fortlaufenden Aufgaben lernen, aber ihre bootstrapped Ziele führen zu Verzerrungen.
Erkundung versus Ausbeutung
Erkundung sammelt Informationen, indem Aktionen ausprobiert werden, deren Wert unsicher ist. Ausbeutung wählt die Aktion, von der man aktuell glaubt, dass sie die beste Rückgabe bietet. Ein Agent, der nie erkundet, kann sich mit einer schlechten Strategie zufriedengeben; ein Agent, der nie ausbeutet, profitiert nicht von dem, was er gelernt hat.
Einfache Strategien umfassen epsilon‑greedy Aktionsauswahl, vertrauensbasierte Erkundung, Entropie‑Bonusse und intrinsische Belohnungs‑Methoden. In sicherheitskritischen Umgebungen kann uneingeschränkte Erkundung inakzeptabel sein, sodass Simulation, Einschränkungen, Offline‑Daten oder menschliche Aufsicht wichtig werden.
Wichtige Reinforcement‑Learning‑Ansätze
Wertbasierte Methoden
Q‑Learning und verwandte Algorithmen lernen Aktionswerte und leiten eine Politik ab, indem sie hochbewertete Aktionen auswählen. Deep Reinforcement Learning verwendet neuronale Netze, um Wertfunktionen oder Politiken zu approximieren, wenn die Zustandsräume zu groß für eine Tabelle sind.
Policy‑Gradient‑Methoden
Policy‑Gradient‑Methoden passen eine parametrische Politik direkt an, um die erwartete Rückgabe zu verbessern. Sie sind nützlich für kontinuierliche Aktionen und stochastische Politiken, können jedoch Gradienten‑Schätzungen mit hoher Varianz erzeugen.
Actor‑Critic‑Methoden
Ein Actor wählt Aktionen, während ein Critic den Wert schätzt und ein Lernsignal liefert. Dies kombiniert direkte Politikoptimierung mit Wertschätzung.
Modellbasiertes und modellfreies RL
Modellbasierte Systeme lernen oder nutzen ein Modell von Übergängen und Belohnungen, sodass sie planen können. Modellfreie Systeme lernen Werte oder Politiken, ohne die Umgebung explizit zu modellieren. Modellbasierte Methoden können Erfahrung effizient nutzen, aber Fehler im gelernten Modell können die Planung in die Irre führen.
Offline‑Reinforcement‑Learning
Offline‑RL lernt aus einem festen Datensatz, anstatt während des Trainings neue Interaktionen zu sammeln. Es kann die Kosten oder das Risiko von Erkundung reduzieren, aber der Agent muss vermeiden, Aktionen, die im Datensatz schlecht vertreten sind, zu überschätzen.
RLHF und menschliche Präferenzen
Reinforcement Learning from Human Feedback (RLHF) verwendet Präferenzdaten, um ein Belohnungssignal zu trainieren oder eine Politik direkt zu optimieren. Es wurde eingesetzt, um das Verhalten von Sprachmodellen an menschliche Urteile anzupassen. Präferenzoptimierung garantiert weder Wahrheit noch Sicherheit: die Ergebnisse hängen davon ab, wer das Feedback lieferte, was beurteilt wurde und wie das Ziel gestaltet wurde.
Einschränkungen
RL kann enorme Mengen an Interaktionen erfordern, während des Trainings instabil sein und unbeabsichtigte Abkürzungen in einer Belohnungsfunktion ausnutzen. Die Bewertung ist schwierig, weil Ergebnisse je nach Zufalls‑Seeds und Umgebungsdetails variieren können. Gute Praxis umfasst mehrere Durchläufe, transparente Baselines, eingeschränkte Ziele, Tests außerhalb der Verteilung und das Monitoring von Reward‑Hacking.
Entwurf eines RL‑Problems: Zustand, Aktion, Belohnung und Zeithorizont
Reinforcement Learning modelliert sequentielle Entscheidungen. Die Umgebung erzeugt eine Beobachtung, der Agent wählt unter einer Politik eine Aktion aus, und ein Übergang liefert eine Belohnung sowie die nächste Beobachtung. Ein Markov‑Entscheidungsprozess geht davon aus, dass der Zustand die Informationen enthält, die nötig sind, um zukünftige Übergänge und Belohnungen vorherzusagen; partielle Beobachtbarkeit erfordert Gedächtnis, Glaubenszustand oder rekurrente Darstellungen. Das Discounting steuert das Gewicht verzögerter Ergebnisse, während episodische und fortlaufende Aufgaben unterschiedliche Rückgabe‑Definitionen benötigen. Eine schlechte Zustands‑ oder Aktionsgestaltung kann ein lösbares Ziel nicht erlernbar machen.
Die Gestaltung der Belohnung legt das Verhalten indirekt fest und ist eine Hauptursache für Fehler. Ein Proxy kann ausgenutzt werden: ein Agent, der für Geschwindigkeit belohnt wird, könnte die Sicherheit vernachlässigen, während ein Agent, der nur beim Abschluss der Aufgabe belohnt wird, zu wenig Lernsignal erhält. Fügen Sie auf realen Anforderungen basierende Einschränkungen und Abbruchregeln hinzu, testen Sie die Empfindlichkeit der Belohnung und prüfen Sie Trajektorien auf unbeabsichtigte Strategien. Erkundungsmethoden balancieren das Sammeln von Informationen mit der Ausbeutung des aktuellen Wissens. Off‑Policy‑Daten können die Stichprobeneffizienz steigern, aber ein Missverhältnis zwischen Verhalten‑ und Ziel‑Politik erfordert dafür konzipierte Algorithmen.
Bewertung, Simulation und sichere Bereitstellung
Wertbasierte Methoden schätzen die erwartete Rückgabe für Zustände oder Aktionen; Policy‑Gradient‑Methoden optimieren eine parametrische Politik; Actor‑Critic‑Methoden lernen beides. Modellbasiertes RL lernt oder nutzt Übergangsdynamiken zum Planen. Die geeignete Familie hängt von Aktionstyp, Daten, Simulatortreue, Zeithorizont und Stabilitätsanforderungen ab. Vergleichen Sie mit heuristischen, überwachten und regelungstheoretischen Baselines. Bewerten Sie durchschnittliche und schlechteste Rückgabe, Verstöße gegen Einschränkungen, Stichprobeneffizienz, Robustheit gegenüber Umweltänderungen und die Varianz über verschiedene Seeds, anstatt nur den Lauf mit der besten Lernkurve auszuwählen.
Online‑Erkundung kann im Gesundheitswesen, Finanzwesen, in der Robotik und Infrastruktur inakzeptabel sein. Trainieren Sie nach Möglichkeit in Simulationen oder mit protokollierten Daten, quantifizieren Sie die Lücke zwischen Simulator und Realität und nutzen Sie Off‑Policy‑Evaluation vorsichtig, da unbekannte Aktionen keine Unterstützung haben. Die Bereitstellung sollte Aktionen, Rate, Ressourcen und Betriebsbereich einschränken; menschliche Genehmigung für folgenschwere Entscheidungen einbeziehen und einen sicheren Controller oder Abschaltung bereitstellen. Überwachen Sie die Belohnung zusammen mit den tatsächlichen Ergebnissen, da ein Agent seine Punktzahl verbessern kann, während er das angestrebte Ziel schädigt. Validieren Sie nach Änderungen an Umgebung, Politik oder Belohnung erneut.
Praktisches Beispiel: Energie‑Steuerung mit Reinforcement Learning
Ein Gebäudebetreiber modelliert Temperatur, Belegung, Wetter, Gerätezustand und Strompreis, wobei die Aktionen auf sichere Sollwert‑Anpassungen beschränkt sind. Die Belohnung kombiniert Komfort, Energie, Nachlastgebühren und Geräteeinschränkungen, doch tatsächliche Komfortverstöße werden separat bewertet, sodass die Optimierung der Belohnung keinen Schaden verbergen kann. Historische Regelungen und modellprädiktive Regelungen dienen als Baselines. Das Training nutzt einen kalibrierten Simulator mit zufälligem Wetter, Sensorsignalen und Geräteeffizienz.
Bevor das Gebäude beeinflusst wird, läuft die Politik gegen Live‑Beobachtungen, ohne zu handeln. Ingenieure prüfen Trajektorien, Einschränkungs‑Margen und das Verhalten während Feiertagen, Hitzewellen, Stromausfällen und fehlenden Sensoren. Die Bereitstellung begrenzt Aktionsrate und -bereich und behält den bestehenden Sicherheitscontroller bei. Ein Mensch kann jederzeit eingreifen. Das Monitoring vergleicht Energie und Komfort mit passenden Zeiträumen, protokolliert Eingriffe und rollt zurück, wenn Verstöße, unerwartete Zyklen oder Modellabweichungen die definierten Schwellen überschreiten.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor der Feinabstimmung. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Verantwortlichkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zugewiesen werden. Nutzen Sie eine gestufte Einführung, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingespeisten Fehlern. Operative Telemetrie sollte Eingabequalität, Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Eingriffe und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie anschließend die Evidenz aus der Praxis, anstatt anzunehmen, dass die Offline‑Leistung erhalten bleibt. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Vorfällen, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Zeitpunkt, zu dem es deaktiviert oder ersetzt werden sollte.
Primärreferenzen












