
Grundlagen der KI
Was ist AIOps? Künstliche Intelligenz für IT-Operationen

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
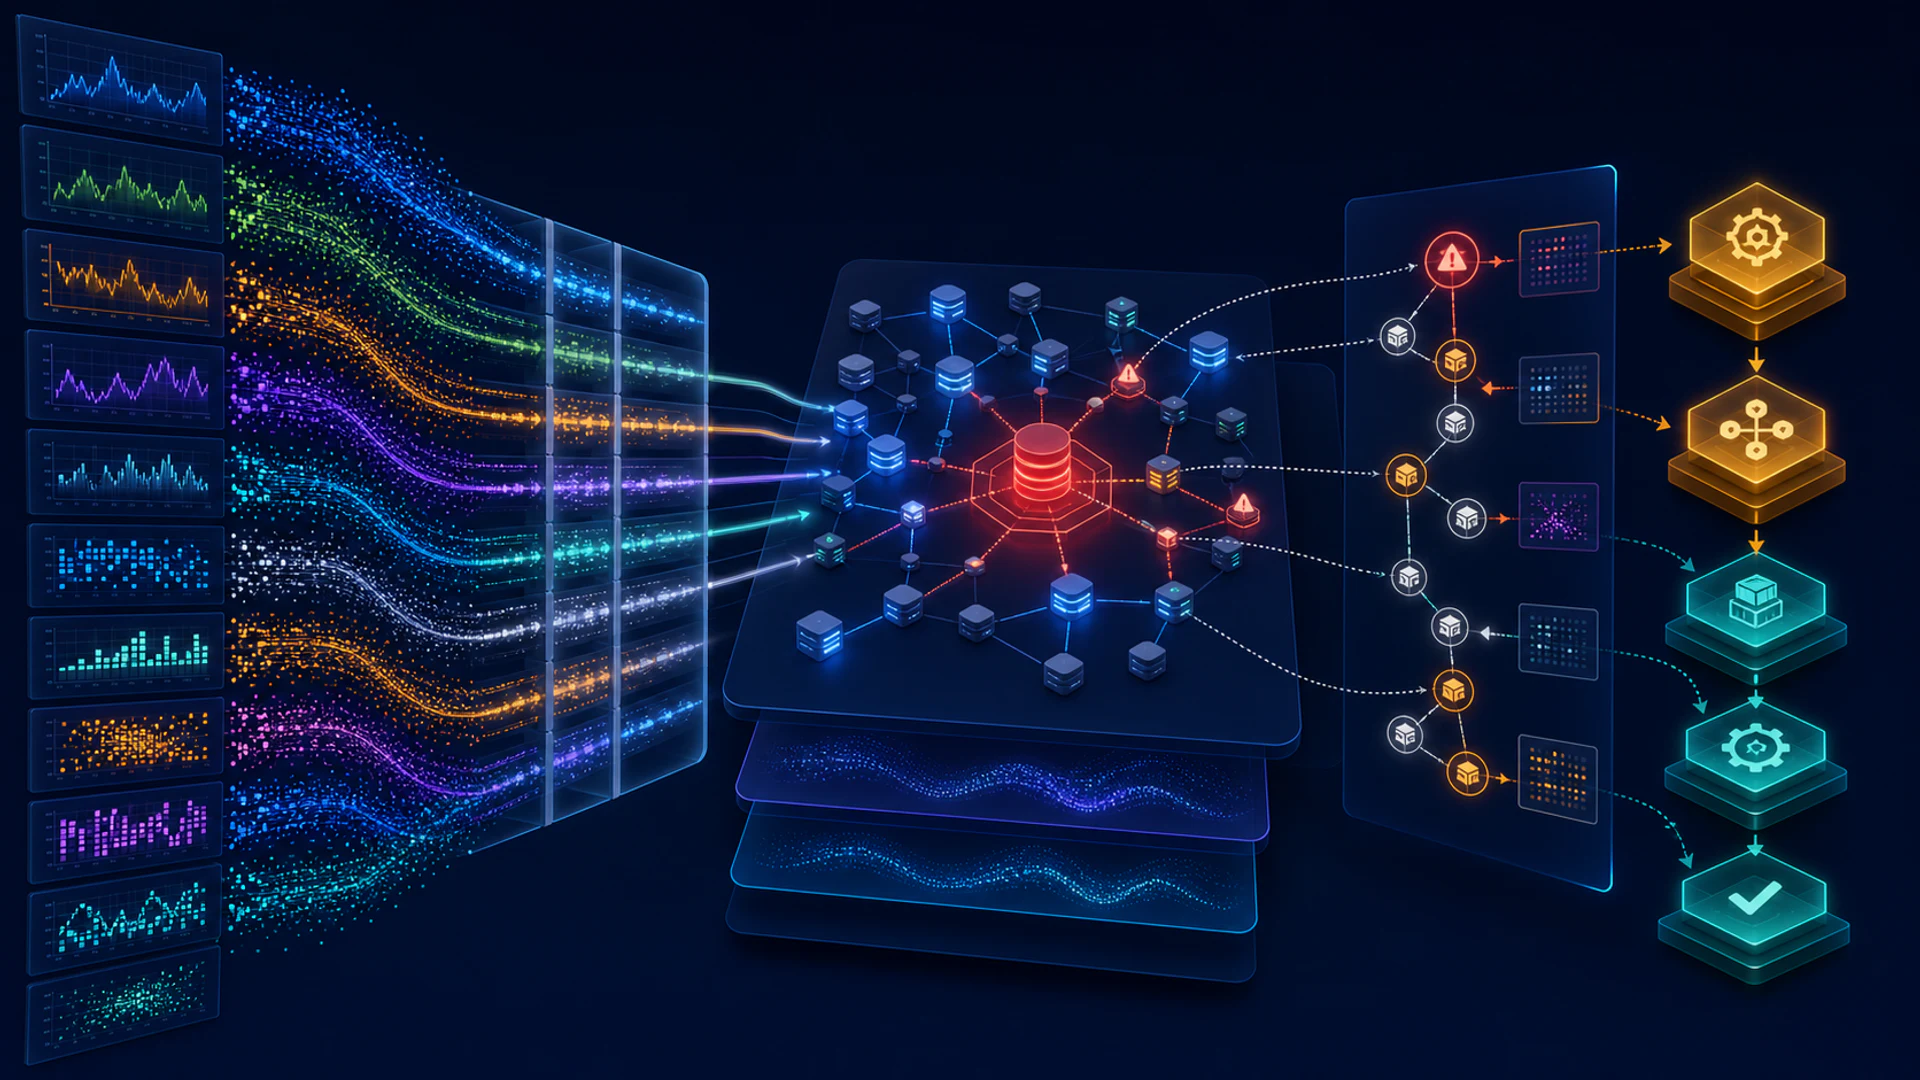
AIOps wendet maschinelles Lernen und Automatisierung auf IT‑Betriebsdaten an, sodass Teams ungewöhnliches Verhalten erkennen, doppelte Alarme reduzieren, zusammengehörige Ereignisse verbinden, wahrscheinliche Ursachen bewerten und Reaktionsmaßnahmen empfehlen oder ausführen können.
AIOps ist kein autonomer Ersatz für den Betrieb. Es ist eine Schicht innerhalb eines ITOps-Systems, und sein Nutzen hängt von der Qualität der Telemetrie, der Service‑Topologie, der Änderungshistorie, menschlichem Feedback und sicheren Automatisierungsgrenzen ab.
Wichtige Erkenntnisse
- Ereignisse normalisieren und Service‑Kontext hinzufügen, bevor komplexe Modelle angewendet werden.
- Anomalieerkennung identifiziert Abweichungen, nicht unbedingt Fehler oder Ursachen.
- Korrelation und Rangfolge wahrscheinlicher Ursachen sollten Evidenz und Unsicherheit aufzeigen.
- Automatisierte Behebung erfordert geringste Berechtigungen, Genehmigungen, Canary‑Tests, Rollbacks und Ergebnis‑Monitoring.
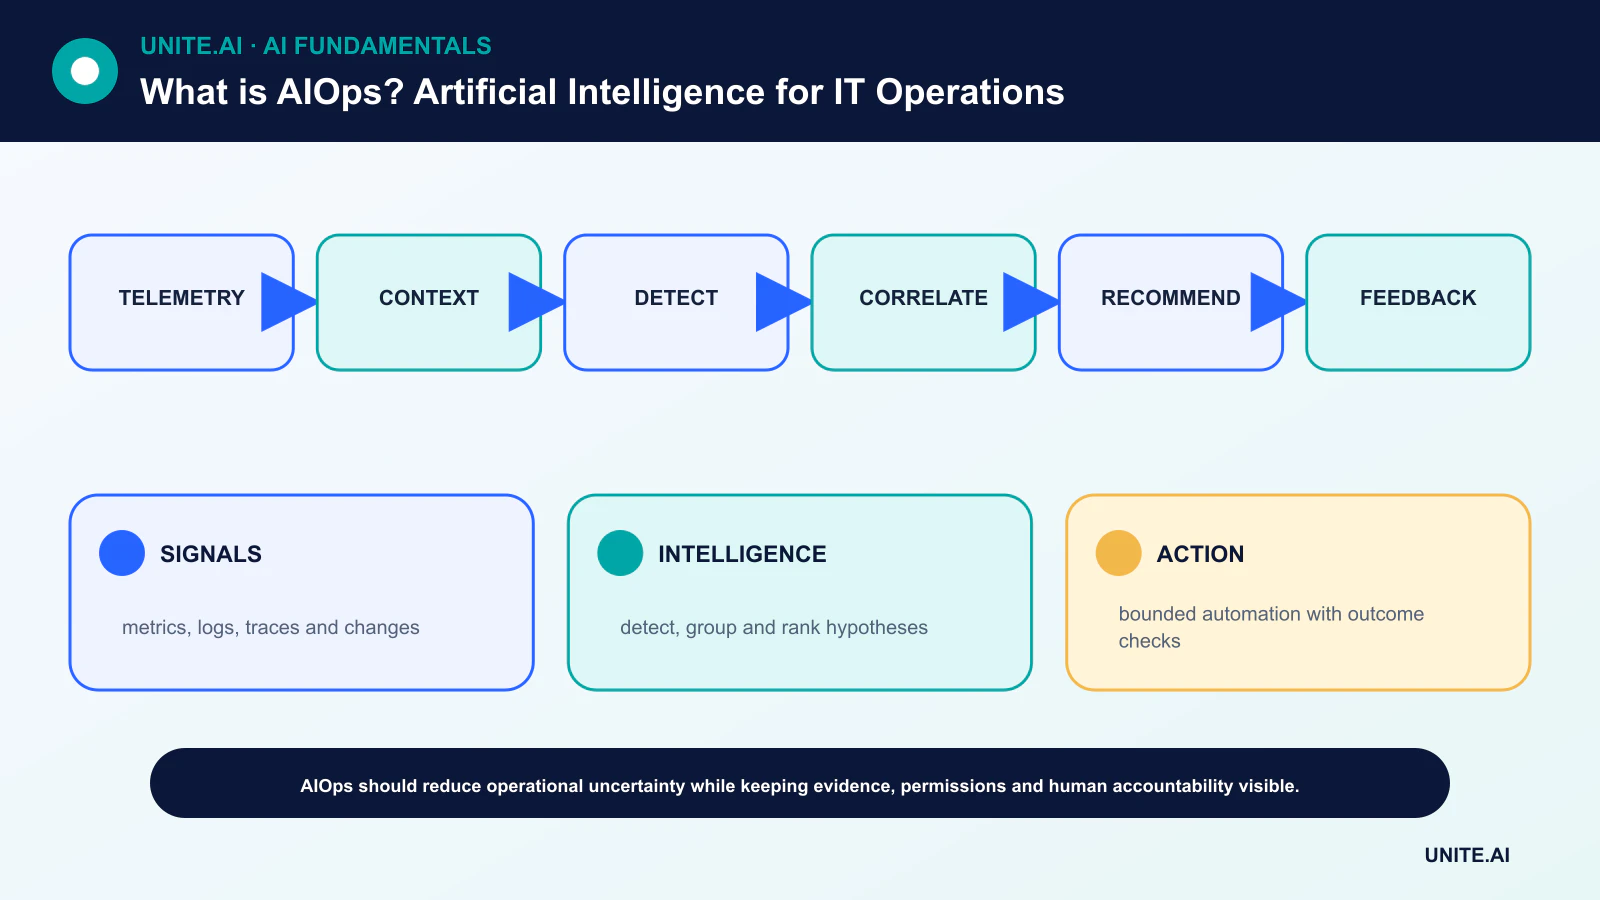
Eine operative Datenschicht aufbauen
AIOps‑Plattformen erfassen Metriken, Protokolle, Traces, Alarme, Tickets, Topologien, Deployments und Konfigurationsänderungen. Zeitstempel, Kennungen und Service‑Eigentumszuordnungen müssen abgeglichen werden, damit das System Signale, die sich auf denselben Vorfall beziehen, verbinden kann.
Fehlender oder inkonsistenter Kontext führt zu falschen Korrelationen. Datenaufbewahrung, Zugriff und Datenschutz sind ebenfalls wichtig, da Protokolle Anmeldeinformationen oder persönliche Daten enthalten können. Es sollte dieselbe Governance wie bei anderen produktiven Datensystemen angewendet werden.
Erkennung und Rauschunterdrückung
Statische Schwellenwerte funktionieren für bekannte Grenzen; statistische und maschinelle Lernmethoden können Saisonalität oder multivariate Muster modellieren. Deduplizierung fasst wiederholte Benachrichtigungen zusammen, während Unterdrückung Alarme entfernt, die nach definierten Regeln nicht handlungsfähig sind.
Eine Anomalie ist lediglich eine Abweichung vom erwarteten Verhalten. Geplante Releases, Traffic‑Kampagnen und Geschäftszyklen können ungewöhnlich, aber gesund sein. Statt die Anzahl entfernter Alarme zu feiern, sollten Präzision, Recall, Erkennungsverzögerung und Arbeitsaufwand der Betreiber bewertet werden.
Korrelation und wahrscheinliche Ursache
Ereigniskorrelation verbindet Symptome über einen Abhängigkeitsgraphen und ein Zeitfenster hinweg. Ein Modell für wahrscheinliche Ursachen kann Komponenten oder jüngste Änderungen, die den Vorfall erklären könnten, rangieren. Dies priorisiert die Untersuchung; es stellt keine Kausalität fest.
Zeigen Sie beitragende Evidenz, alternative Hypothesen und das Vertrauen. Erklärbare KI ist besonders wichtig, wenn ein Betreiber entscheiden muss, ob ein Service isoliert oder ein Deployment zurückgerollt werden soll.
Von Empfehlung zu Automatisierung
Ein Runbook kann Diagnosen sammeln, einen zustandslosen Worker neu starten oder Kapazität skalieren. Copiloten können Vorfälle zusammenfassen und Verfahren abrufen. Agenten können Werkzeugaufrufe planen, doch Produktionsberechtigungen sollten eng gefasst sein und Aktionen gegen den aktuellen Zustand validiert werden.
Beginnen Sie mit schreibgeschützten Empfehlungen. Reife Aktionen sollten durch Simulation, menschliche Genehmigung, Canary‑Tests und automatischen Rollback gefördert werden. Dokumentieren Sie Eingaben, Modellversion, Autorisierung und Ergebnis jeder Aktion.
Bewertung und betriebliche Rückmeldung
Spielen Sie historische Vorfälle erneut ab, ohne deren endgültige Labels in Merkmale zu lecken. Testen Sie neue Services und Änderungen, messen Sie falsche Unterdrückungen, Erkennungszeit, Behebungszeit, Akzeptanz der Betreiber und Wiederholungen. Vergleichen Sie mit bestehenden Regeln und einfachen Baselines.
Drift entsteht, wenn sich Architektur, Traffic oder Reaktionspraktiken ändern. Schließen Sie den Kreislauf, indem Sie Betreiber Korrelationen und Ergebnisse korrigieren lassen und anschließend prüfen, ob das System Aufwand reduziert, ohne Risiken zu verbergen oder eine Selbstzufriedenheit durch Automatisierung zu erzeugen.
AIOps‑Daten‑ und Analyse‑Pipeline
AIOps wendet statistische und maschinelle Lernmethoden auf Betriebsdaten wie Metriken, Protokolle, Traces, Ereignisse, Topologien, Tickets und Änderungen an. Die Pipeline sammelt und normalisiert Signale, reichert sie mit Service‑ und Eigentumskontext an, erkennt Anomalien, korreliert verwandte Ereignisse, schätzt wahrscheinliche Ursachen und empfiehlt oder löst Aktionen aus. Die Qualität hängt von Zeitstempeln, Kennungen, Topologie und Änderungsprotokollen ab. Ein komplexes Modell kann Alarme, die sich auf denselben Service unter inkonsistenten Namen beziehen, nicht zuverlässig korrelieren.
Anomalieerkennung lernt Baselines nach Service, Saison und Betriebszustand; statische Schwellenwerte können für bekannte Sicherheitsgrenzen besser geeignet sein. Ereigniskorrelation fasst Symptome zu einem Vorfall zusammen, basierend auf Zeit, Topologie, Text und historischen Mustern. Die Rangliste der Ursachen schlägt Hypothesen vor, kann jedoch den zuerst beobachteten Fehler mit der wahren Ursache verwechseln oder eine gemeinsam genutzte Abhängigkeit, die in der Topologie fehlt, übersehen. Zusammenfassungen in natürlicher Sprache können Helfern unterstützen, müssen jedoch auf Roh‑Evidenz verweisen und Unsicherheit angeben.
Automatisierung, Bewertung und Rückmeldung
Beginnen Sie mit Entscheidungsunterstützung und risikogeringer reversibler Behebung. Jede automatisierte Aktion benötigt Autorisierung, Vorbedingungen, begrenzten Umfang, Timeout, Überprüfung der Nachbedingungen, Rollback und ein Audit‑Protokoll. Das Modell darf sich nicht selbst Berechtigungen erteilen oder Protokolltexte als vertrauenswürdige Anweisungen behandeln. Menschliche Reagierende sollten Empfehlungen akzeptieren, ablehnen oder korrigieren, und diese Ergebnisse sollten Regeln oder Trainingsdaten durch Überprüfung aktualisieren, statt unkontrolliertes Selbst‑Lernen zu ermöglichen.
Bewerten Sie die Alarmreduktion, ohne Vorfälle zu verpassen, sowie Erkennungslead‑time, Korrelation‑Präzision, Rangliste der Ursachen, Erfolg der Behebung, Wiederherstellungszeit, Wiederholungen und Arbeitsaufwand der Reagierenden. Nutzen Sie historische Wiedergaben und injizierte Fehler, berücksichtigen Sie jedoch unvollständige Vorfall‑Labels. Messen Sie nach Service und Vorfalltyp; ein Durchschnitt kann gefährliche Fehler in seltenen kritischen Systemen verbergen. Vergleichen Sie mit deterministischen Regeln und verbesserter Observierbarkeit, bevor Sie KI‑Komplexität hinzufügen.
Governance und Fehlermodi
AIOps kann Telemetrielücken verstärken, eine falsche Diagnose automatisieren oder korrelierte, flächenweite Aktionen erzeugen. Isolieren Sie Umgebungen, begrenzen Sie Parallelität, halten Sie einen Not‑Ausschalter außerhalb des Modells bereit und proben Sie das Versagen der AIOps‑Plattform selbst. Schützen Sie Protokolle und Tickets, die Geheimnisse oder personenbezogene Daten enthalten. Überwachen Sie Modell‑Drift, Topologie‑Aktualität, falsche Aktionen und Overrides. AIOps unterstützt zuverlässige Abläufe, wenn es Evidenz und begrenzte Aktionen schneller bereitstellt; es ist kein autonomer Ersatz für Service‑Eigentum, Incident‑Command oder technisches Urteil.
Praktisches Beispiel: AIOps für einen Zahlungs‑Vorfall
AIOps fasst einen Anstieg von API‑Fehlern, Datenbank‑Sättigung und regionalen Alarmen zu einem Vorfall zusammen und reichert ihn mit einem kürzlichen Deployment, der Topologie und dem Eigentümer an. Es rangiert das Deployment als wahrscheinlichen Mitverursacher, zeigt jedoch Roh‑Telemetrie und Alternativen. Eine deterministische Richtlinie pausiert weitere Rollouts; ein menschlicher Incident‑Commander genehmigt die Traffic‑Umleitung, nachdem er geprüft hat, dass Kapazität und Datenkonsistenz sicher sind.
Das System misst die Präzision der Gruppierung, die Erkennungslead‑time, die Genauigkeit der Rangliste, die Akzeptanz der Reagierenden, die Wiederherstellung und falsche Behebungen in historischen Wiedergaben und Simulations‑Tagen. Alle automatisierten Aktionen besitzen Grenzen, Idempotenz, Nachbedingungen‑Prüfungen und Rollback. Protokolle werden gesäubert und bösartiger Text kann nicht zu einem Befehl werden. Nach dem Vorfall aktualisieren bestätigte Ursache und Aktions‑Ergebnisse die überprüften Regeln und Bewertungsdaten. Die AIOps‑Plattform unterstützt Evidenz und Koordination; sie ersetzt niemals Incident‑Command oder externe Autorisierung.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluierungsset vor dem Tuning. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout sollten Sie die Zuständigkeit für Releases, Ausnahmen, Änderungen, Rollbacks und Stilllegungen festlegen. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, die Modell‑ oder Regelversion, den Gesundheitszustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und überprüfen Sie nach der Bereitstellung reale Evidenz, anstatt anzunehmen, dass Offline‑Leistungen fortbestehen. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Incident‑Lernen, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist AIOps dasselbe wie Observability?
Nein. Observability liefert und untersucht Systemsignale; AIOps nutzt Analytik und Automatisierung über diese Signale. Beide können unabhängig voneinander existieren.
Kann AIOps die Ursache automatisch bestimmen?
Es kann Hypothesen rangieren und Evidenz sammeln, doch kausale Aussagen erfordern Topologie, Änderungskontext und Validierung. Viele Vorfälle haben mehrere, miteinander interagierende Ursachen.
Primärreferenzen












