
Grundlagen der KI
Was ist Incident-Automatisierung? Workflows, Leitplanken und Anwendungsfälle

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Incident-Automatisierung verwendet Software, um betriebliche oder sicherheitsrelevante Vorfälle zu erkennen, anzureichern, zuzuordnen, zu koordinieren und manchmal zu beheben. Sie verbindet Überwachungssignale mit Runbooks, Ticketing, Kommunikation, Zugriffskontrollen und Wiederherstellungsmaßnahmen, sodass Einsatzkräfte weniger Zeit mit dem Kopieren von Daten und mehr Zeit mit Entscheidungen verbringen.
Automatisierung bedeutet nicht den Wegfall menschlicher Verantwortung. Ein sicheres Programm unterscheidet risikoarme deterministische Schritte von Aktionen, die Kunden oder die Produktion beeinträchtigen können, und wendet dann Genehmigungen, eingeschränkte Anmeldeinformationen, Prüfpfade, Zeitlimits und Rollbacks je nach Auswirkung an.
Wesentliche Erkenntnisse
- Automatisieren Sie wiederholbare Beweiserhebungen, bevor Sie eine autonome Behebung versuchen.
- Verwenden Sie Schweregrad, Vertrauen, Auswirkungsradius und Umkehrbarkeit, um ein Genehmigungsniveau auszuwählen.
- Betrachten Sie jedes Runbook als versionierten Produktionscode mit Tests und einem Verantwortlichen.
- Messen Sie Erkennung, Bestätigung, Wiederherstellung, Wiederholungen und Benutzerimpact – nicht nur das Alarmvolumen.
Vom Signal zur koordinierten Reaktion
Ein Workflow kann Alarme deduplizieren, aktuelle Deployments und Protokolle anhängen, den Service‑Owner ermitteln, einen Vorfallsdatensatz öffnen, das Bereitschaftsteam anrufen, einen Kommunikationskanal erstellen und eine Zeitleiste starten. Diese Schritte reduzieren die kognitive Belastung, ohne automatisch eine riskante Diagnose zu stellen.
Die Korrelation muss Beweise bewahren. Wenn eine Plattform Symptome zu aggressiv zusammenfasst, kann sie gleichzeitig auftretende Vorfälle verbergen. Verknüpfen Sie die Automatisierung mit der Verantwortlichkeit für IT‑Operationen und behalten Sie die Rohsignale, die Einsatzkräfte benötigen könnten.
Aktionen nach Risiko auswählen
Nur‑Lese‑Abfragen, Snapshots und reversible Traffic‑Umleitungen lassen sich im Allgemeinen leichter automatisieren als das Löschen von Daten, das Rotieren umfassender Anmeldeinformationen oder das Ändern eines Produktionsschemas. Definieren Sie Vorbedingungen, ein Ausführungs‑Timeout, Nachbedingungen und ein Rollback für jede Aktion.
Verwenden Sie Service‑Identitäten mit minimalen Rechten und trennen Sie die Autorisierung von der Workflow‑Engine. Schritte mit hoher Auswirkung sollten einen identifizierten Genehmiger erfordern. Wenn AIOps eine Ursache oder Lösung vorschlägt, benötigen Einsatzkräfte weiterhin unterstützende Beweise und eine sichere Möglichkeit, diese abzulehnen.
Zuverlässige Runbooks erstellen
Ein Runbook sollte Eingaben, Abhängigkeiten, Verantwortlichen, Umfang, Fehlverhalten und erzeugte Beweise deklarieren. Testen Sie es in einer Staging‑Umgebung und während Game‑Days. Idempotente Schritte sind wertvoll, weil deren Wiederholung keinen zusätzlichen Schaden verursacht.
Versionieren und überprüfen Sie Automatisierung wie andere Software. Überwachen Sie das Ablaufen von Anmeldeinformationen, API‑Änderungen, Rate‑Limits, Teil‑Ausführungen und versteckte Kopplungen zwischen Services. Manuelle Verfahren bleiben notwendig, wenn die Automatisierungsplattform selbst nicht verfügbar ist.
Nach der Wiederherstellung lernen
Automatisierung sollte einen zeitgestempelten Nachweis von Signalen, Entscheidungen, Aktionen, Genehmigungen und Ergebnissen bewahren. Eine schuldlose Überprüfung kann dann die beitragenden Systembedingungen vom endgültigen Auslöser trennen und Erkenntnisse in getestete Verbesserungen umwandeln.
Nützliche Kennzahlen umfassen die mittlere Zeit bis zur Bestätigung und Wiederherstellung, den Prozentsatz sicherer automatisierter Schritte, die Fehlerrate von Aktionen, wiederholte Vorfälle und den Kundenimpact. Verknüpfen Sie die Erkenntnisse mit DevOps‑Planung, anstatt die Anzahl geschlossener Tickets zu optimieren.
Arten der Incident-Automatisierung
Ereignis‑Automatisierung normalisiert und reichert eingehende Signale an. Koordinations‑Automatisierung erstellt einen Vorfallsdatensatz, ruft Eigentümer an, eröffnet Kommunikationskanäle und veröffentlicht Status‑Updates. Diagnose‑Automatisierung führt Nur‑Lese‑Abfragen aus oder erstellt Snapshots. Behebungs‑Automatisierung ändert den Systemzustand, während Wiederherstellungs‑Automatisierung die Service‑Gesundheit prüft und temporäre Abhilfemaßnahmen schließt.
Diese Kategorien sollten nicht dieselbe Standard‑Vertrauensstufe teilen. Anreicherung kann häufig automatisch ausgeführt werden; ein Produktions‑Failover kann Vertrauensprüfungen und einen Genehmiger erfordern; Datenwiederherstellung benötigt in der Regel einen Incident‑Commander und den Anwendungs‑Owner. Die Kontrolle sollte dem potenziellen Impact folgen, nicht der Frage, ob der Schritt durch eine Regel oder ein Machine‑Learning‑Modell implementiert wird.
Sicherheitsvorfälle fügen Anforderungen zur Beweiserhaltung hinzu. Automatisierung muss vermeiden, einen kompromittierten Host zu verändern, bevor flüchtige Daten erfasst wurden, sensible Indikatoren in öffentlichen Kanälen preiszugeben oder gemeinsam genutzte Infrastruktur zu isolieren, ohne den Auswirkungsradius zu verstehen. Operative und forensische Runbooks können sich überschneiden, jedoch kann deren Reihenfolge variieren.
Workflow‑Design und Steuerungsebene
Modellieren Sie das Runbook als explizite Zustände mit Vorbedingungen und Endergebnissen. Jede Aktion sollte melden, ob sie gestartet, erfolgreich, fehlgeschlagen, abgelaufen oder übersprungen wurde, zusammen mit einem unveränderlichen Ausführungs‑Identifier. Ein zentraler Orchestrator kann Schritte koordinieren, doch nachgelagerte Services sollten ihre eigene Autorisierung durchsetzen und Eingaben eigenständig validieren.
Verwenden Sie eingeschränkte, kurzlebige Anmeldeinformationen und beschränken Sie Netzwerkpfade vom Automatisierungs‑Engine. Trennen Sie Entwicklungs‑, Test‑ und Produktions‑Runner. Geheimnisse dürfen nicht in Chat‑Transkripten oder Protokollen erscheinen. Für Aktionen mit hoher Auswirkung sollte eine Zwei‑Personen‑Genehmigung oder eine Break‑Glass‑Rolle erforderlich sein, deren Nutzung sofort einen Prüfpfad erzeugt.
Planen Sie für Teil‑Fehlschläge. Ein Ticket kann erstellt werden, während das Anrufen fehlschlägt; eine Traffic‑Umleitung kann in einer Region erfolgreich sein und in einer anderen ablaufen. Kompensationsaktionen, Reconciliations‑Jobs und klare Verantwortlichkeiten verhindern, dass der Workflow Erfolg meldet, nur weil der Orchestrierungsprozess beendet ist.
Beispiele, Tests und Reifegrad
Ein ausgereifter erster Anwendungsfall ist die Erschöpfung von Datenbankverbindungen: Sammeln Sie Pool‑Metriken, aktuelle Deployments, langsame Abfragen und Eigentümerinformationen; öffnen Sie einen Vorfall; schlagen Sie eine reversible Skalierung oder Traffic‑Aktion vor; verlangen Sie Genehmigung; und prüfen Sie anschließend Fehlerrate und Latenz. Das gleiche Muster kann bei Zertifikatsablauf, Platten‑Druck, fehlgeschlagenen Jobs oder verdächtiger Kontenaktivität eingesetzt werden.
Testen Sie Runbooks mittels Unit‑Tests, gemockter APIs, Staging‑Vorfällen, Game‑Days und kontrollierten Produktions‑Übungen. Injizieren Sie veraltete Daten, Berechtigungsausschlüsse, langsame Abhängigkeiten, doppelte Ereignisse und widersprüchliche Vorfälle. Bestätigen Sie, dass Wiederholungen sicher sind und dass Einsatzkräfte die manuelle Kontrolle übernehmen können, ohne gegen die Automatisierung anzukämpfen.
Der Reifegrad entwickelt sich von Benachrichtigung über Anreicherung zu geführten Aktionen bis hin zu begrenzter Auto‑Behebung. Fortschritt sollte auf Beweisen basieren: stabile Diagnose, niedrige Fehlerraten, verifizierte Rollbacks und klarer Nutzen für den Nutzer. Autonome Abschlüsse sollten selten sein, bis das System die Wiederherstellung nachweisen und genügend Beweise für späteres Lernen bewahren kann.
Durchgeführtes Beispiel: Automatisierung eines Produktions‑Service‑Vorfalls
Betrachten Sie eine Zahlungs‑API, deren Fehlerrate nach einem Deployment ansteigt. Das Monitoring erzeugt einen strukturierten Alarm mit Service, Umgebung, Region, Version, Fehlerbudget und Runbook‑Link. Die Automatisierung reichert ihn mit dem Änderungs‑Record, dem Gesundheitszustand von Abhängigkeiten, aktuellen Protokollen und Eigentumsinformationen an und fasst doppelte Alarme zu einem Vorfall zusammen. Eine deterministische Richtlinie kann die weitere Ausrollung sofort pausieren; ein Rollback sollte Beweise erfordern, dass die neue Version die Ursache ist und dass ein Rollback sicher ist.
Der Workflow weist einen Incident‑Commander zu, eröffnet Kommunikationskanäle, protokolliert eine Zeitleiste und schlägt Diagnose‑Schritte vor. Automatisierte Behebung beginnt mit risikoarmen reversiblen Aktionen, etwa dem Umleiten von Traffic zu einer gesunden Instanz. Jede Aktion benötigt Autorisierung, Parallelitäts‑Limits, ein Timeout, verifizierte Nachbedingungen und ein Rollback. Generative Zusammenfassungen können Einsatzkräfte unterstützen, doch die Quell‑Telemetrie und Befehle bleiben sichtbar, sodass das Team eine falsche Darstellung hinterfragen kann.
Messen Sie die Zeit bis zur Erkennung, Bestätigung, Eindämmung und Wiederherstellung; das Alarm‑Volumen; die Unterdrückung von Duplikaten; den Erfolg der Behebung; Wiederholungen und durch Automatisierung verursachte Schäden. Führen Sie Game‑Days für abgelaufene Anmeldeinformationen, Teil‑Regionen, irreführende Alarme und fehlgeschlagene Rollbacks durch. Nach der Wiederherstellung bewahren Sie die faktische Zeitleiste, identifizieren beitragende technische und organisatorische Bedingungen, aktualisieren Runbooks und Tests und verfolgen Korrekturmaßnahmen bis zum Abschluss, anstatt eine schnelle Eindämmung als Ende der Zuverlässigkeitsarbeit zu betrachten.
Praktische Implementierungs‑Checkliste
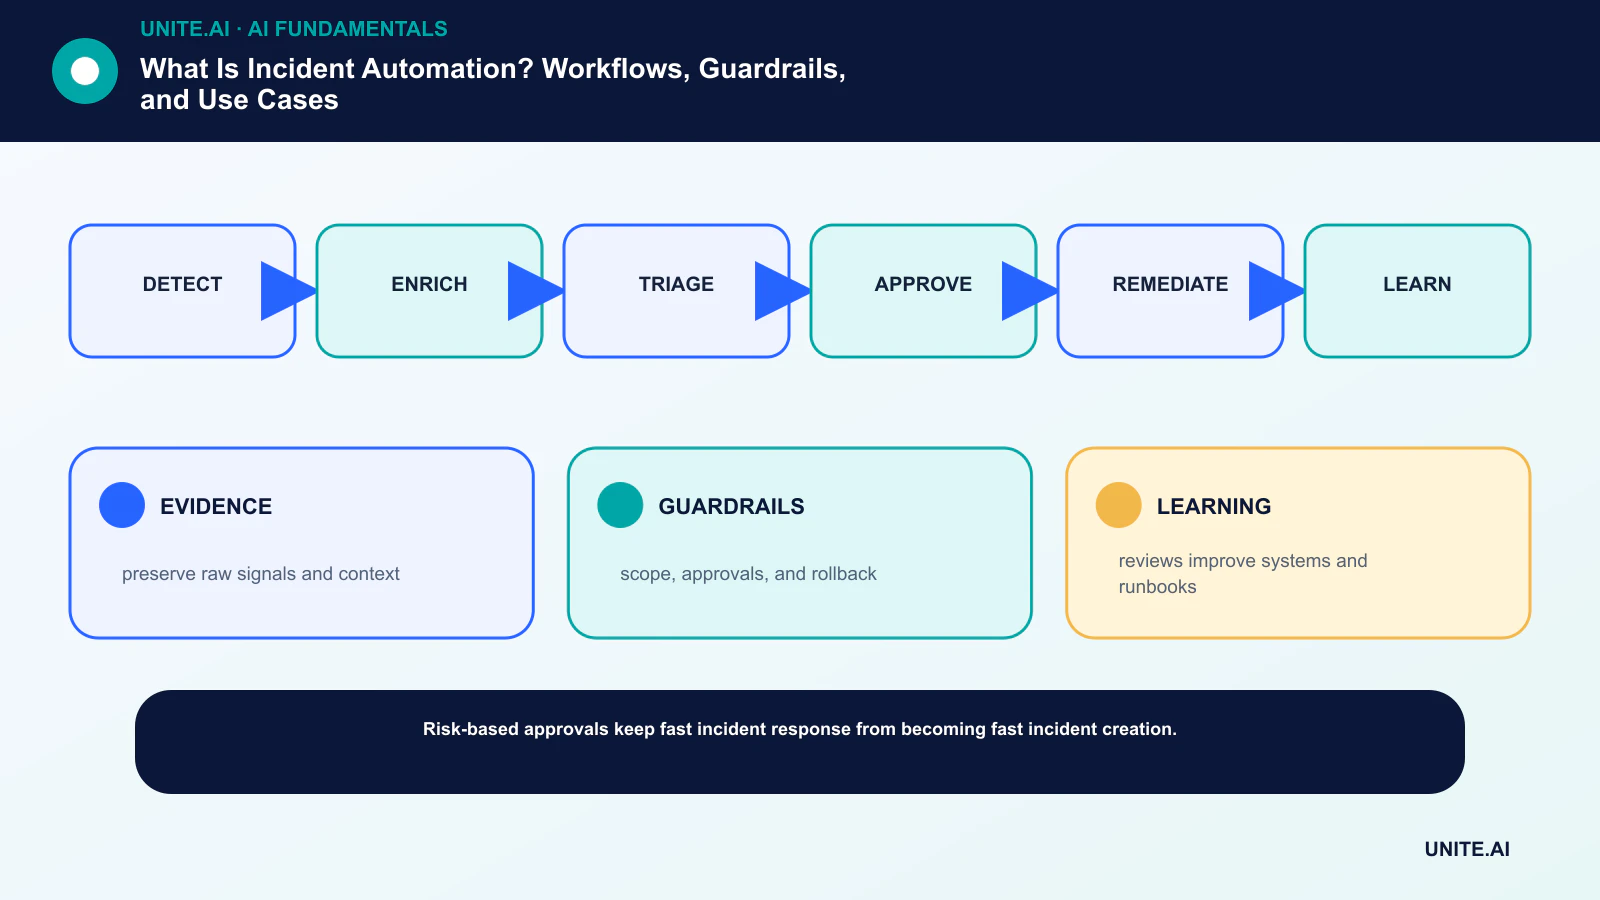
Verwandeln Sie das Konzept in einen abgegrenzten, testbaren Workflow: Erkennen → Anreichern → Triagieren → Genehmigen → Beheben → Lernen. Benennen Sie einen verantwortlichen Owner, dokumentieren Sie Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, setzen Sie Akzeptanz‑ und Stopp‑Kriterien, testen Sie repräsentative Fehlerszenarien und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Bereitschafts‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Abhängigkeits‑Fehler und Fehlgebrauch; bewahren Sie die Beweise und ungelösten Risiken. Definieren Sie, wer die Freigabe, Schwellenwertänderungen, Ausgabeveroverride oder das Stoppen des Betriebs genehmigen darf. Überprüfen Sie die Entscheidung erneut, sobald reale Daten vorliegen, da ein technisch erfolgreicher Pilot keine zuverlässige Leistung im größeren Maßstab garantiert.
- BEWEISE: Rohsignale und Kontext bewahren.
- LEITPLANKEN: Umfang, Genehmigungen und Rollback.
- LERNEN: Reviews verbessern Systeme und Runbooks.
Häufig gestellte Fragen
Ist Incident‑Automatisierung dasselbe wie AIOps?
Nein. AIOps wendet Analytik oder Machine Learning auf Betriebsdaten an. Incident‑Automatisierung ist die umfassendere Ausführungs‑ und Koordinierungsebene; sie kann einfache Regeln, AIOps‑Ergebnisse oder beides nutzen.
Was sollte zuerst automatisiert werden?
Beginnen Sie mit hochfrequenten, risikoarmen, gut verstandenen Schritten wie Anreicherung, Eigentümer‑Lookup, Beweiserfassung, Status‑Updates und reversiblen Diagnosen.
Primärreferenzen











