
Grundlagen der KI
Was ist IT-Betrieb (ITOps)?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
IT-Operations (ITOps) ist die Tätigkeit, die technologische Dienste, von denen eine Organisation abhängt, betreibt. Sie umfasst Rechenleistung, Netzwerke, Identität, Endgeräte, Cloud‑Plattformen, Datenbanken, Speicher, Backups und die Betriebsprozesse, die diese Komponenten verfügbar, sicher und wartbar halten.
Moderne ITOps beschränkt sich nicht mehr auf ein Network Operations Center, das Dashboards beobachtet. Teams verwalten zunehmend softwaredefinierte Infrastruktur, Plattform‑Dienste, Automatisierung und verteilte Verantwortung, während sie weiterhin für Vorfälle, Kapazität, Kontinuität und Service‑Level‑Ziele verantwortlich bleiben.
Wesentliche Erkenntnisse
- ITOps verwaltet Dienste und deren Abhängigkeiten über On‑Premises-, Cloud‑ und Edge‑Umgebungen hinweg.
- Beobachtbarkeit, Konfiguration und Inventar liefern den Kontext, der zur Interpretation von Fehlfunktionen nötig ist.
- Vorfallsmanagement stellt den Service wieder her; Problem‑Management behandelt wiederkehrende oder systemische Ursachen.
- ITOps überschneidet sich mit ITSM, SRE, DevOps, SecOps und AIOps, ist aber keiner dieser Begriffe identisch.
Dienste, Assets und Konfiguration
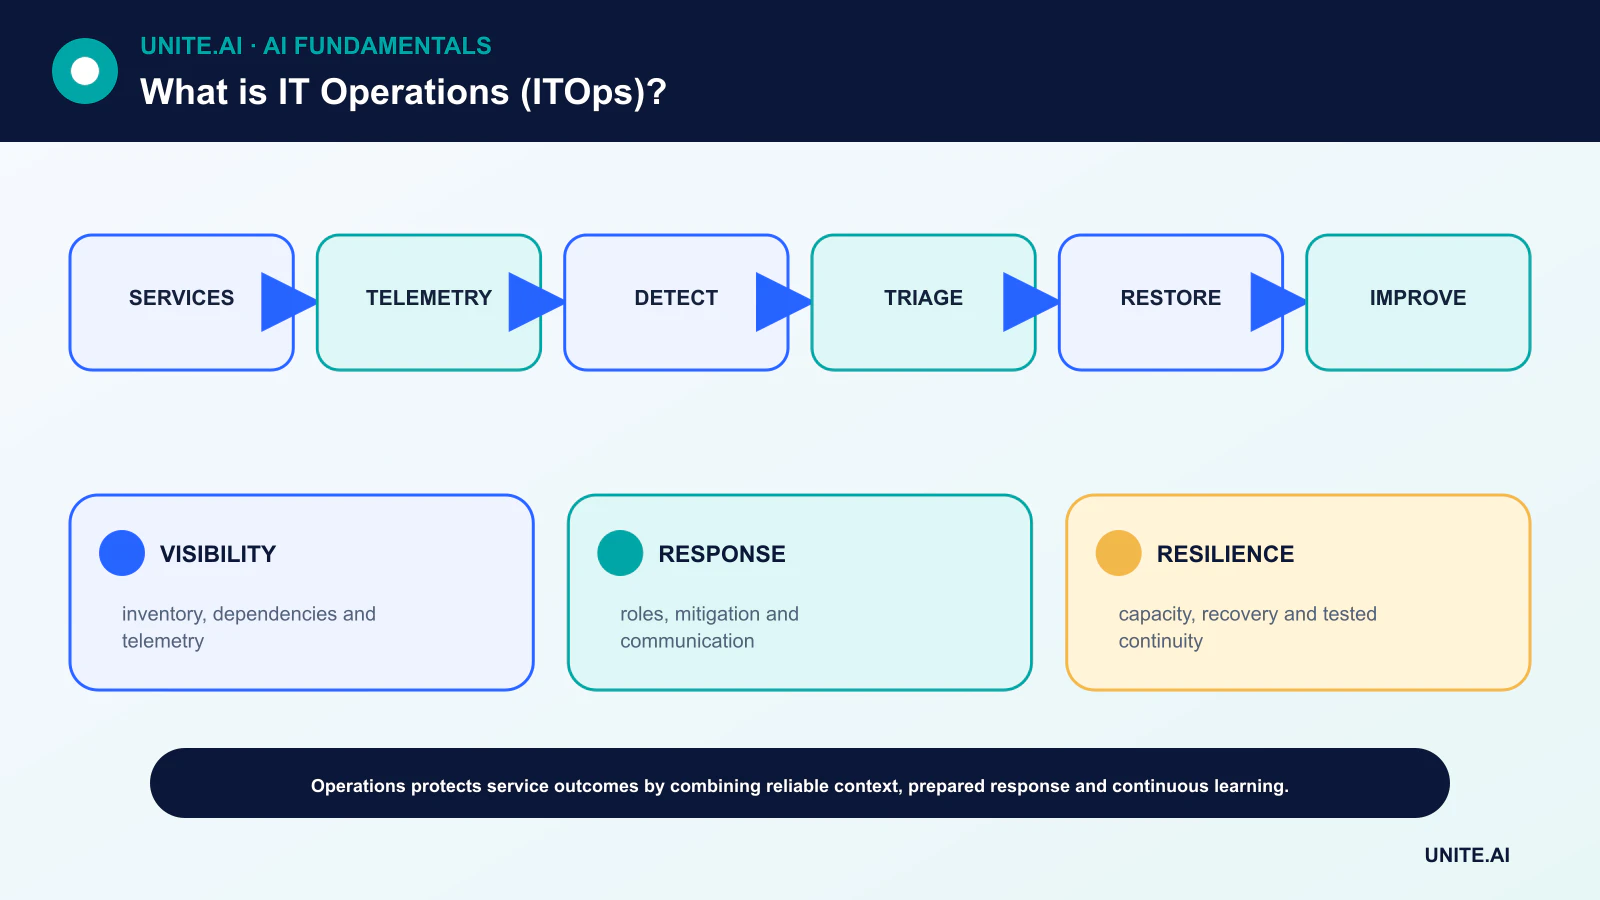
Der Betrieb beginnt damit, zu wissen, welche Dienste existieren, wer sie besitzt, welche Nutzer von ihnen abhängen und welche Infrastruktur sie unterstützt. Das Asset‑Inventar erfasst Komponenten; das Konfigurations‑Management dokumentiert relevante Beziehungen und den kontrollierten Zustand.
Ein Inventar, das nie abgeglichen wird, wird irreführend. Automatisieren Sie die Erkennung dort, wo sie sinnvoll ist, identifizieren Sie autoritative Quellen und erfassen Sie Vertrauenswürdigkeit oder Aktualität, anstatt vorzugeben, dass jede Abhängigkeitskarte vollständig ist.
Beobachtbarkeit und Service‑Ziele
Metriken quantifizieren Verhalten, Logs protokollieren Ereignisse und Traces verfolgen Arbeit über Dienste hinweg. Synthetische Prüfungen können eine Nutzerreise testen. Nützliche Beobachtbarkeit beginnt mit Fragen und Service‑Zielen und sammelt dann die Signale, die zur Beantwortung nötig sind.
Alarmierung sollte Bedingungen identifizieren, die zeitnahes Handeln erfordern. Schwellenwerte ohne Nutzer‑Auswirkung erzeugen Rauschen, während fehlender Kontext zu Abhängigkeiten die Diagnose verlangsamt. AIOps kann bei der Korrelation helfen, benötigt jedoch vertrauenswürdige Telemetrie und betriebliches Feedback.
Vorfalls-, Problem- und Änderungsmanagement
Vorfallsmanagement koordiniert Erkennung, Triage, Eindämmung, Kommunikation und Wiederherstellung. Klare Rollen reduzieren Verwirrung unter Druck. Eine temporäre Umgehung kann den Service wiederherstellen, während eine spätere Problem‑Untersuchung tiefere Ursachen adressiert.
Änderungsmanagement bewertet und dokumentiert Risiken, ohne jede Änderung zu einer Warteschlange zu machen. Standard‑, automatisierte und risikoarme Änderungen können vorab genehmigte Pfade folgen; Änderungen mit hohem Einfluss erfordern stärkere Evidenz, Terminplanung und Rollback‑Vorbereitung.
Kapazität, Resilienz und Kontinuität
Teams prognostizieren Ressourcenbedarf, beseitigen Engpässe und testen das Verhalten unter Last. Backups sind nur dann nützlich, wenn die Wiederherstellung getestet wird. Redundanz hilft nur, wenn Fehlermodi unabhängig sind und das Failover tatsächlich funktioniert.
Business‑Continuity definiert Prioritäten, Wiederherstellungszeit und akzeptablen Datenverlust. Abhängigkeiten von Identität, DNS, Cloud‑Control‑Planes und Anbietern sollten in Übungen einbezogen werden, anstatt deren Verfügbarkeit vorauszusetzen.
ITOps, ITSM, SRE und DevOps
IT Service Management liefert Prozesse, um Dienste an organisatorische Bedürfnisse anzupassen. Site Reliability Engineering wendet Software‑Engineering auf den Betrieb an und nutzt Service‑Level‑Objectives und Error‑Budgets. DevOps verbindet Entwicklung und Betriebs‑Feedback.
SecOps fokussiert sich auf Bedrohungen und Reaktion, während ITOps die breitere Service‑Gesundheit aufrechterhält. Organigramme unterscheiden sich; die wesentliche Anforderung ist explizite Besitzverhältnisse und geteilte Evidenz über diese Disziplinen hinweg.
Das ITOps‑Betriebsmodell
IT‑Operations hält die Technologie‑Dienste einer Organisation verfügbar, performant, sicher und wiederherstellbar. Der Umfang umfasst typischerweise Endgeräte, Identität, Netzwerke, Server, Cloud, Speicher, Zusammenarbeit, Datenbanken, Monitoring, Service‑Desk, Backup und Anbieter‑Dienste. Moderne ITOps erstreckt sich über eigene Infrastruktur und verwaltete Plattformen, sodass die Verantwortung explizit sein muss, selbst wenn der Betrieb ausgelagert wird. Ein Konfigurations‑ oder Service‑Inventar verknüpft technische Komponenten mit Eigentümern, Nutzern, Abhängigkeiten, Datenklassifizierung und geschäftlicher Kritikalität.
Service‑Management organisiert Vorfälle, Anfragen, Probleme, Änderungen, Assets, Wissen und Service‑Levels. Vorfallsmanagement stellt den Service wieder her; Problem‑Management untersucht wiederkehrende Ursachen; Change‑Enablement bewertet und koordiniert Risiken. Jede Änderung als langsame Genehmigung zu behandeln erzeugt Umgehungen, während ungovernierte Automatisierung unkontrollierte Fehler erzeugt. Standard‑risikofreie Änderungen können vorab autorisiert und automatisiert werden; hochriskante Änderungen benötigen Evidenz, Kommunikation, Rollback und Terminplanung basierend auf dem Impact.
Zuverlässigkeit, Kapazität und Kontinuität
Monitoring sollte Nutzer‑fokussierte Dienste und deren Abhängigkeiten verfolgen, nicht nur Geräte‑Anzahl. Definieren Sie Verfügbarkeit, Latenz, Kapazität, Frische und Support‑Ziele gemeinsam mit den Geschäfts‑Eigentümern. Alarmieren Sie bei handlungsfähigen Symptomen und beim Verbrauch des Error‑Budgets; reichern Sie Ereignisse mit Besitz‑ und Änderungsinformationen an. Kapazitätsplanungs‑Modelle berücksichtigen Nachfrage, Sättigung, Lizenzen und Vorlaufzeit. Cloud‑Elastizität reduziert Bereitstellungs‑Verzögerungen, eliminiert jedoch nicht Kontingente, regionale Limits oder Kosten‑Kontrollen.
Business‑Continuity erfordert getestete Backups, Wiederherstellung, Identitäts‑Recovery, Netzwerk‑Alternativen, Anbieter‑Kontakte und manuelle Verfahren. Definieren Sie Wiederherstellungs‑Zeit‑ und Wiederherstellungs‑Punkt‑Ziele pro Service. Ein Backup ist kein Beweis für Wiederherstellung, solange es nicht restauriert und validiert wurde. Üben Sie Ransomware, Regionen‑Ausfall, abgelaufene Zertifikate, Identitäts‑Ausfall und Lieferanten‑Fehler. Verfolgen Sie Konfiguration und Infrastruktur‑als‑Code, wo möglich, sodass die Wiederherstellung reproduzierbar ist.
Sicherheit, Automatisierung und Metriken
Setzen Sie das Prinzip der minimalen Rechte, Patch‑ und Schwachstellen‑Management, Endgeräte‑Kontrollen, Netzwerk‑Segmentierung, Logging und Incident‑Response ein. Automatisieren Sie wiederkehrende Arbeiten mit Idempotenz, Limits, Genehmigungen und Audits. Messen Sie Service‑Verfügbarkeit, Vorfalls‑Wiederholungsrate, Anfrage‑Erfüllung, Änderungs‑Fehlschläge, Wiederherstellung, Patch‑Auswirkungen, Kapazität, Kosten und Nutzer‑Zufriedenheit – nicht nur Ticket‑Schließungen. ITOps ist erfolgreich, wenn Technologie die Arbeit vorhersehbar unterstützt und von Fehlern erholen kann, nicht wenn Infrastruktur „beschäftigt“ wirkt oder Dashboards nur grüne Anzeigen zeigen.
Praktisches Beispiel: Wiederherstellung eines Kollaborationsdienstes
Ein Unternehmen definiert ein Wiederherstellungs‑Zeit‑Ziel von vier Stunden und ein Wiederherstellungs‑Punkt‑Ziel von einer Stunde für eine Kollaborationsplattform. Es inventarisiert Identität, DNS, Netzwerk, Daten, Schlüssel, Konfiguration, Integrationen und Anbieter‑Abhängigkeiten. Eine Wiederherstellungs‑Übung geht davon aus, dass die primäre Region und das Administratorkonto nicht verfügbar sind. Betreiber aktivieren eine unabhängig geschützte Notfall‑Identität, stellen Service‑Konfiguration und Daten in einer isolierten Region wieder her und validieren Berechtigungen, Nachrichten, Integrationen und Client‑Zugriff. Geschäfts‑Eigentümer prüfen den wiederhergestellten Service mit realistischen Nutzer‑Reisen, anstatt sich nur auf Infrastruktur‑Health‑Checks zu verlassen.
Die Übung protokolliert tatsächlichen Datenverlust, verstrichene Zeit, manuelle Schritte, fehlgeschlagene Kontakte und verborgene Abhängigkeiten. Ein Backup, das Dateien, aber nicht Verschlüsselungs‑Schlüssel oder Identitäts‑Richtlinien wiederherstellt, wird als unvollständig markiert. Korrektur‑Maßnahmen erhalten Verantwortliche und Termine, das Runbook wird aktualisiert und erneut getestet. Monitoring‑ und Kommunikations‑Templates werden eingebunden. Die Organisation misst Wiederherstellungs‑Evidenz statt nur den Erfolg des Backup‑Jobs und erkennt, dass verlässliche ITOps den Service, den Nutzer benötigen, unter realistischen Fehlerszenarien wiederherstellen müssen.
Implementierungsnachweise und operative Einsatzbereitschaft
Eine Produktions‑Entscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebs‑Umfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes kritischen Fehlers. Etablieren Sie einen reproduzierbaren Baseline‑Zustand und ein versioniertes Evaluations‑Set, bevor Sie Feinabstimmungen vornehmen. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungs‑Shift, Ausfall von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie Aufgaben‑Qualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototypen unterscheiden kann.
Vor dem Roll‑out weisen Sie Verantwortlichkeiten für Release, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Nutzen Sie ein gestaffeltes Roll‑out, bewahren Sie ein sicheres Fallback und verifizieren Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabe‑Qualität, Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, Gesundheits‑Status von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für Reaktionen, prüfen Sie dann reale Evidenz nach dem Deployment, anstatt anzunehmen, dass Offline‑Performance anhält. Überprüfen Sie regelmäßig, wenn Daten‑Quellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Vorfalls‑Lern‑, Lösch‑ und Aufbewahrungs‑Prozesse sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Was ist das Hauptziel von ITOps?
Die Bereitstellung und Wiederherstellung zuverlässiger Technologie‑Dienste innerhalb vereinbarter Sicherheits‑, Leistungs‑, Kontinuitäts‑ und Kosten‑Grenzen.
Wird die Cloud‑Infrastruktur vollständig vom Cloud‑Anbieter betrieben?
Nein. Anbieter betreiben Teile der zugrunde liegenden Plattform, während Kunden für Konfiguration, Identität, Daten, Workloads, Monitoring und viele service‑level‑Entscheidungen verantwortlich bleiben.
Primärreferenzen












