
Grundlagen der KI
Was ist Plattform‑Engineering? Plattformen, Entwicklererfahrung und Leitplanken

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Plattform‑Engineering ist die Praxis, gemeinsam genutzte interne Fähigkeiten zu bauen und zu betreiben, die Software‑Teams dabei unterstützen, Anwendungen über unterstützte Self‑Service‑Workflows zu liefern und zu betreiben. Die Plattform wird als Produkt behandelt, dessen Nutzer Entwickler und andere technische Teams sind.
Eine Plattform ist nicht automatisch ein Portal, ein Kubernetes‑Cluster oder eine Sammlung von Skripten. Sie wird nützlich, wenn sie die kognitive Belastung und Durchlaufzeit reduziert und gleichzeitig Zuverlässigkeit, Sicherheit, Beobachtbarkeit und organisatorische Konsistenz verbessert.
Wesentliche Erkenntnisse
- Beginnen Sie mit Entwickler‑Forschung und wiederkehrenden Reibungen, nicht mit einem vorbestimmten Tool‑Stack.
- Bieten Sie optionale, unterstützte Goldene Pfade mit klaren Ausstiegsmöglichkeiten für legitime Ausnahmen.
- Stellen Sie Fähigkeiten über APIs, Vorlagen, Automatisierung und Dokumentation bereit; ein Portal ist nur eine Schnittstelle.
- Messen Sie Nutzerergebnisse und Produktakzeptanz zusammen mit Lieferung, Zuverlässigkeit, Sicherheit und Kosten.
Plattform als internes Produkt
Ein Plattform‑Team identifiziert interne Nutzer, Journeys, Schmerzpunkte und gewünschte Ergebnisse. Es pflegt eine Roadmap, Service‑Levels, Dokumentation, Support und Feedback‑Schleifen wie jedes Produktteam. Die Akzeptanz wird durch Nützlichkeit verdient, nicht durch die Benennung eines zentralen Teams erzwungen.
Damit wird die Zusammenarbeit im DevOps-Umfeld erweitert. Anwendungsteams behalten die Verantwortung für ihre Services, während die Plattform wiederverwendbare Fähigkeiten und Richtlinien bereitstellt.
Fähigkeiten, Portale und Goldene Pfade
Fähigkeiten können Repositorys, Umgebungen, CI/CD, Secrets, Identität, Infrastruktur, Beobachtbarkeit, Servicekataloge, Kosten und Incident‑Integration umfassen. Ein Entwickler‑Portal kann sie sichtbar machen, doch Orchestrierung und Betriebsservices machen die Plattform real.
Ein Goldener Pfad ist ein gut unterstützter Weg, um eine gängige Aufgabe zu erledigen. Er sollte sichere Vorgaben kodieren und transparent bleiben. Teams benötigen einen gesteuerten Ausnahme‑Pfad, wenn Anforderungen abweichen.
Architektur und Leitplanken
Verwenden Sie stabile Schnittstellen und deklarative APIs, damit sich die Plattform dahinter weiterentwickeln kann. Trennen Sie die Kontroll‑Ebene von Workloads, begrenzen Sie Berechtigungen, bewahren Sie Metadaten zum Eigentum und machen Sie generierte Änderungen prüfbar und reversibel.
Integrieren Sie DevSecOps-Prüfungen, Richtlinien und die Herkunft von Artefakten in Workflows. Leitplanken sollten schnelles Feedback und umsetzbare Abhilfemaßnahmen bieten, anstatt unerklärte Ablehnungen.
Messen und weiterentwickeln
Messen Sie die Zeit bis zur ersten Bereitstellung, Durchlaufzeit, Wiederherstellung nach fehlgeschlagenen Änderungen, Plattform‑Verfügbarkeit, Support‑Aufwand, Akzeptanz, Zufriedenheit, Sicherheitslage und Kosten. Vermeiden Sie es, Portal‑Anmeldungen als Proxy für verbesserte Lieferung zu zählen.
Statten Sie die Plattform mit IT‑Operations-Praktiken aus und befragen Sie regelmäßig die Nutzer. Stilllegen Sie ungenutzte Pfade, standardisieren Sie dort, wo Wiederholungen kostspielig sind, und erlauben Sie Vielfalt, wo sie Produktwert schafft.
Interne Entwicklerplattformen und Goldene Pfade
Eine interne Entwicklerplattform ist ein Produkt, das genehmigte Infrastruktur‑ und Betriebsfähigkeiten über Self‑Service‑Schnittstellen bereitstellt. Sie kann ein Portal, einen Servicekatalog, Vorlagen, APIs, Befehlszeilen‑Tools, Bereitstellungs‑Workflows, Secrets, Umgebungen und Beobachtbarkeit kombinieren. Die Plattform ersetzt nicht Cloud oder Kubernetes; sie organisiert sie zu nutzbaren Fähigkeiten.
Ein Goldener Pfad ist ein voreingenommener, unterstützter Weg, um eine gängige Aufgabe zu erledigen, etwa das Erstellen eines Services mit Repository, CI‑Pipeline, Laufzeit, Dashboards, Alarmen und Eigentums‑Metadaten. Er sollte die sicherste und einfachste Option sein, während berechtigte Ausnahmen zugelassen werden. Ein zwingender Pfad, der reale Workloads nicht unterstützen kann, wird zum Engpass oder wird umgangen.
Plattform‑Teams sollten Entwickler als Kunden und Fähigkeiten als Produkte behandeln. Discovery‑Interviews, Nutzungsanalysen, Support‑Daten, Roadmaps, Dokumentation und Service‑Level‑Ziele sind ebenso wichtig wie Automatisierung. Akzeptanz ist ein Hinweis auf Nützlichkeit, aber alleinige Akzeptanz beweist nicht, dass Lieferung, Zuverlässigkeit, Sicherheit oder die Entwicklererfahrung verbessert wurden.
Kontroll‑Ebenen, Schnittstellen und Betriebsmodell
Die Kontroll‑Ebene der Plattform stimmt die deklarierte Absicht eines Entwicklers mit den zugrunde liegenden Ressourcen ab. Eine Service‑Definition könnte eine Laufzeit, Datenbank, Region und Zuverlässigkeits‑Stufe anfordern; Controller übersetzen das in Cloud‑, Netzwerk‑, Richtlinien‑ und Beobachtungs‑Konfigurationen. Stabile Abstraktionen sollten zufällige Komplexität verbergen, ohne den für das Debugging notwendigen Betriebszustand zu verbergen.
Schnittstellen können Web‑Portale, APIs, Git‑basierte Konfiguration, CLIs und wiederverwendbare Pipeline‑Komponenten umfassen. Die beste Schnittstelle hängt von der Aufgaben‑Häufigkeit und dem Nutzer‑Workflow ab. Jede Schnittstelle benötigt Authentifizierung, Autorisierung, Validierung, Prüf‑Historie, Fehlermeldungen und Versionierung. Self‑Service ohne Lebenszyklus‑Management führt zu aufgegebenen Ressourcen und Konfigurations‑Ausdehnung.
Ein Plattform‑Team besitzt gemeinsam genutzte Fähigkeiten und vorgebaute Wege, während Anwendungsteams die Verantwortung für das Software‑Verhalten und die Geschäftsergebnisse behalten. Sicherheits‑, Zuverlässigkeits‑, Finanz‑ und Infrastruktur‑Teams tragen zu Richtlinien und Services bei. Klare Verantwortungsgrenzen verhindern, dass die Plattform zu einer nicht nachvollziehbaren Ticket‑Warteschlange oder zu dem Versuch wird, jede technische Entscheidung zu zentralisieren.
Wert messen und Plattform‑Fehlschläge vermeiden
Messen Sie die Durchlaufzeit bis zur ersten Produktions‑Bereitstellung, die Zeit für die Bereitstellung von Umgebungen, die Bereitstellungs‑Häufigkeit, die Fehlerrate bei Änderungen, die Wiederherstellungszeit, die kognitive Belastung, das Support‑Volumen, die Zuverlässigkeit und die Einführung von Sicherheits‑Kontrollen. Segmentieren Sie die Ergebnisse nach Team und Workload. Ein schnellerer Vorlagen‑Start hat begrenzten Wert, wenn Änderungen am zweiten Tag weiterhin langsam sind oder Vorfälle schwerer zu diagnostizieren werden.
Häufige Fehlentwicklungen umfassen das Bauen, bevor die Nutzer verstanden werden, das Kopieren des Stacks eines großen Unternehmens, das Offenlegen roher Infrastruktur hinter einem Portal, das Erzwingen voreiliger Standardisierung und die Optimierung auf die Output‑Leistung des Plattform‑Teams. Beginnen Sie mit einer schmerzhaften, wiederkehrenden Journey, kartieren Sie deren Schritte und Wartezeiten, liefern Sie einen schlanken End‑zu‑End‑Pfad und iterieren Sie anhand beobachteter Ergebnisse.
Plattformen müssen sich weiterentwickeln, ohne jeden Service zu destabilisieren. Nutzen Sie versionierte Verträge, Deprecation‑Zeiträume, automatisierte Migrationen, Kompatibilitätstests und klare Eigentumsverhältnisse. Verfolgen Sie Plattform‑Abhängigkeiten, damit ein Ausfall der Kontroll‑Ebene nicht alle Deployments blockiert oder laufende Workloads beschädigt. Dokumentieren Sie Notfall‑Verfahren und testen Sie regelmäßig die Wiederherstellung nach einem Plattform‑Fehler.
Praktisches Beispiel: ein Self‑Service‑Pfad für eine neue API
Ein Entwickler wählt eine genehmigte API‑Vorlage aus und gibt Service‑Name, Eigentümer, Datenklassifizierung, Sprache und Zuverlässigkeits‑Stufe an. Die Plattform erstellt ein Repository, eine Abhängigkeits‑Richtlinie, eine CI‑Pipeline, eine Testumgebung, eine Bereitstellungs‑Konfiguration, einen Service‑Katalog‑Eintrag, Dashboards, Alarme und ein erstes Runbook. Die Richtlinie prüft Namen, Regionen, Berechtigungen und Netzwerk‑Exposition vor der Bereitstellung, während die erzeugten Artefakte prüfbar und im Besitz des Teams bleiben.
Die Plattform stellt Lebenszyklus‑Operationen – Umgebung erstellen, deployen, skalieren, ein Secret rotieren, Logs anzeigen, zurückrollen und stilllegen – über stabile APIs und ein Portal bereit. Laufende Workloads bleiben aktiv, wenn das Portal nicht verfügbar ist. Ausnahmen nutzen einen dokumentierten Erweiterungspunkt und ein Ablaufdatum anstelle einer nicht nachverfolgten manuellen Änderung. Versionierte Vorlagen und automatisierte Migrationen verhindern, dass Plattform‑Verbesserungen stillschweigend bestehende Services brechen.
Messen Sie die Zeit von der Erstellung des Repositories bis zu einer gesunden Produktions‑Bereitstellung, den Entwickler‑Aufwand, die Support‑Nachfrage, Fehlerraten bei Änderungen, Wiederherstellung, Richtlinien‑Einhaltung und die Akzeptanz nach Workload‑Typ. Befragen Sie Nutzer, die den Pfad abbrechen, und prüfen Sie, wo sie warten oder die Abstraktion verlassen. Das Plattform‑Team sollte die größte wiederkehrende Reibung priorisieren, Zuverlässigkeit und Roadmap veröffentlichen und ungenutzte Fähigkeiten stilllegen. Ein gepflegter Katalog ist keine Plattform, wenn Teams weiterhin Tickets für jede bedeutende Operation benötigen.
Die Einführung sollte gestaffelt erfolgen. Beginnen Sie mit freiwilligen Teams und einer Workload‑Klasse, beweisen Sie die Operationen am zweiten Tag und migrieren Sie dann mit Werkzeugen und Support. Veröffentlichen Sie die Service‑Ziele und den Abhängigkeits‑Status der Plattform und entwerfen Sie einen Notfall‑Pfad, der kontrolliert, aber während Ausfällen nutzbar ist. Chargeback oder Showback können Ressourcenkosten sichtbar machen, doch Produktteams benötigen ebenfalls sinnvolle Vorgaben, damit die Finanz‑Governance nicht zu einer weiteren manuellen Genehmigungswarteschlange wird.
Praktische Implementierungs‑Checkliste
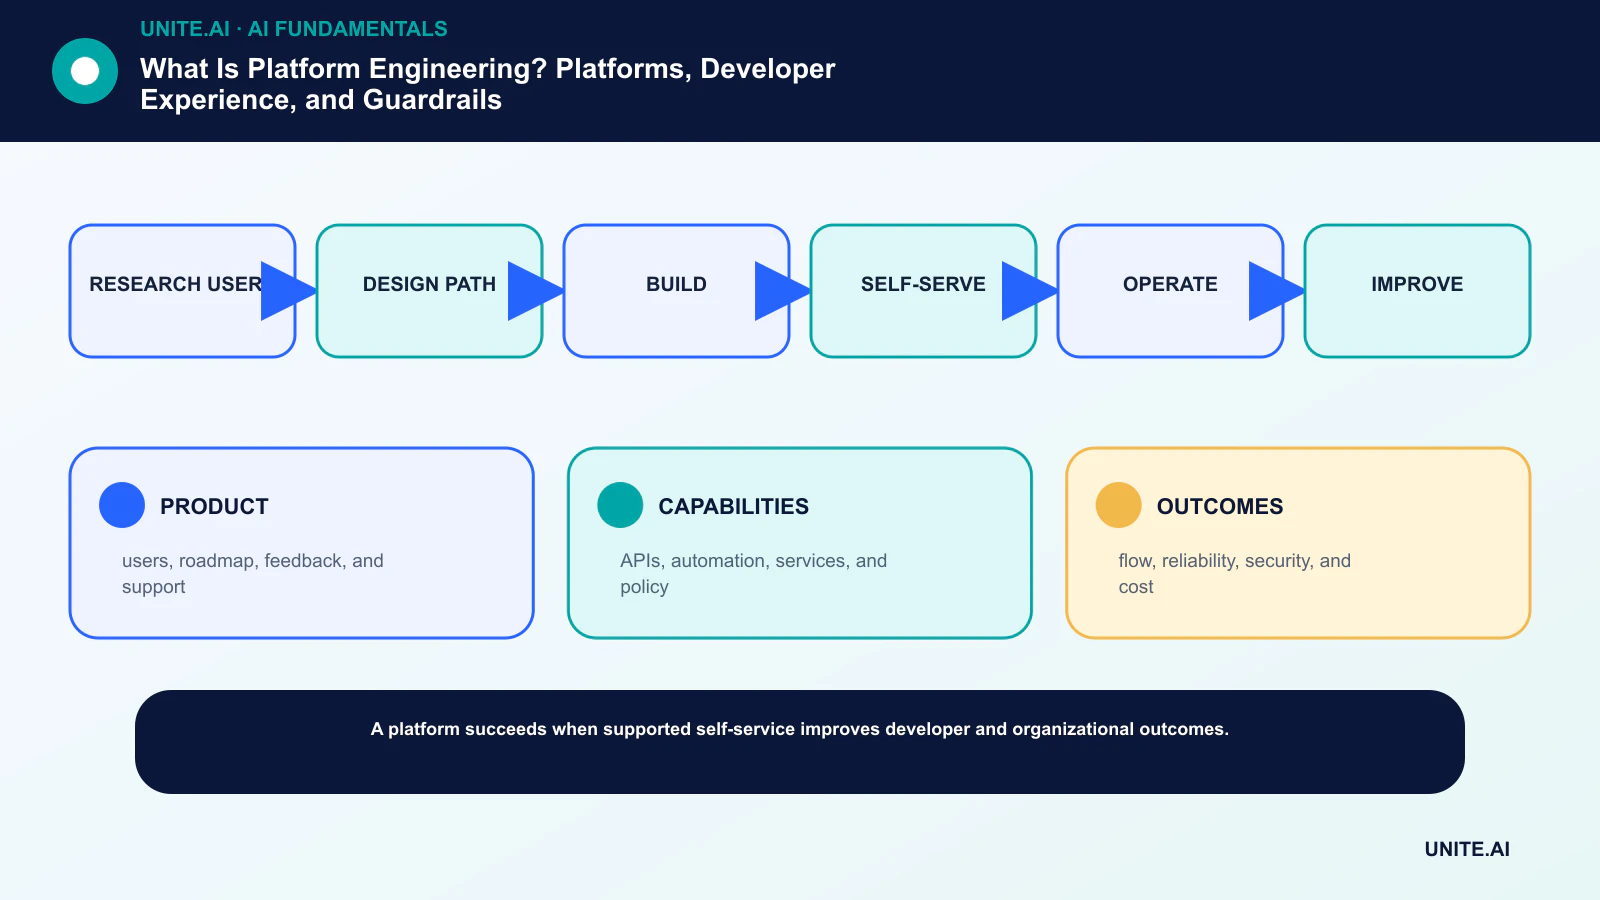
Verwandeln Sie das Konzept in einen abgegrenzten, testbaren Workflow: Nutzer recherchieren → Pfad designen → bauen → Self‑Service → betreiben → verbessern. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie die Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, setzen Sie Akzeptanz‑ und Stopp‑Kriterien, testen Sie repräsentative Fehler und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Readiness‑Prüfung mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Ausfälle von Abhängigkeiten und Fehlgebrauch; bewahren Sie die Beweise und offenen Risiken. Definieren Sie, wer die Veröffentlichung freigeben, Schwellenwerte ändern, ein Ergebnis überschreiben oder den Betrieb stoppen kann. Überprüfen Sie die Entscheidung erneut, sobald reale Daten vorliegen, da ein technisch erfolgreicher Pilot keine zuverlässige Leistung im größeren Maßstab garantiert.
- PRODUCT: Nutzer, Roadmap, Feedback und Support.
- CAPABILITIES: APIs, Automatisierung, Services und Richtlinien.
- OUTCOMES: Ablauf, Zuverlässigkeit, Sicherheit und Kosten.
Häufig gestellte Fragen
Ersetzt Plattform‑Engineering DevOps?
Nein. Plattform‑Engineering ist ein Weg, DevOps‑Prinzipien zu skalieren, indem gemeinsame Produkte und Self‑Service‑Fähigkeiten bereitgestellt werden. Zusammenarbeit und Service‑Verantwortung bleiben essenziell.
Ist ein internes Entwickler‑Portal die Plattform?
In der Regel nicht. Ein Portal ist eine Schnittstelle. Die Plattform umfasst außerdem APIs, Automatisierung, Infrastruktur, Richtlinien, Services, Dokumentation, Support und den operativen Besitz.
Primäre Referenzen











