Grundlagen der KI
Programmieren und KI: Ein Anfängerpfad in die Künstliche Intelligenz

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Sie können mit dem Erlernen von KI beginnen, ohne vorherige professionelle Programmiererfahrung zu haben, doch das Erstellen zuverlässiger Systeme erfordert schließlich ausreichend Programmier‑, Daten‑ und Bewertungskompetenz, um zu prüfen, was die Werkzeuge tun. Der schnellste Weg besteht aus einer kleinen Reihe von Projekten, die an den Grundlagen ausgerichtet sind, anstatt einer langen Tour durch lose verbundene Tutorials.
KI‑unterstütztes Codieren kann Syntax erklären, Beispiele generieren und beim Debuggen helfen. Betrachten Sie die Ausgabe als Entwurf: führen Sie sie aus, testen Sie sie, lesen Sie die Dokumentation und verstehen Sie die Daten und Berechtigungen, bevor Sie ihr vertrauen.
Wesentliche Erkenntnisse
- Lernen Sie grundlegendes Python, Notebooks, Git, die Kommandozeile und wie man Fehlermeldungen liest.
- Erstellen Sie ein kleines überwacht‑Lern‑Projekt, bevor Sie zu Agenten oder großen Modellen übergehen.
- Verwenden Sie Trainings‑, Validierungs‑ und Testdaten korrekt; vergleichen Sie mit einer einfachen Ausgangsbasis.
- Lassen Sie KI die Rückkopplungsschleife unterstützen, prüfen Sie jedoch Code, Quellen, Lizenzen, Sicherheit und Ergebnisse selbst.
Stufe 1: Grundlagen der Programmierung
Lernen Sie Variablen, Sammlungen, Bedingungen, Schleifen, Funktionen, Module, Dateien, Umgebungen und Ausnahmen. Üben Sie das Einlesen einer CSV, das Transformieren von Datensätzen, das Aufrufen einer dokumentierten API, das Schreiben eines Tests und die Nutzung von Git zur Versionsverfolgung.
Sie benötigen keine fortgeschrittene Mathematik, bevor Sie programmieren, doch sollten Sie grundlegende Wahrscheinlichkeitsrechnung, Vektoren, Mittelwerte, Verteilungen und Diagramme lernen, sobald sie relevant werden. Computational Thinking hilft, ein vages Ziel in prüfbare Schritte zu übersetzen.
Stufe 2: ein vollständiges ML‑Projekt
Wählen Sie einen kleinen öffentlichen Datensatz und eine klare Vorhersagefrage. Erkunden Sie die Daten, erstellen Sie eine unabhängige Aufteilung, bauen Sie eine Ausgangsbasis, trainieren Sie ein einfaches Modell, prüfen Sie Fehler und notieren Sie Einschränkungen. Verwenden Sie scikit-learn, bevor Sie ein eigenes neuronales Netzwerk einsetzen, wenn es passt.
Dieses Projekt macht Machine Learning‑Konzepte greifbar: Merkmale, Labels, Datenleckage, Overfitting, Metriken, Reproduzierbarkeit und den Unterschied zwischen einer Modellbewertung und einer nützlichen Entscheidung.
Stufe 3: Deep Learning und Sprachmodelle
Lernen Sie Tensoren, Batches, Verlust, Gradientenabstieg und Backpropagation anhand eines kleinen Bild‑ oder Textmodells. Nutzen Sie anschließend ein vortrainiertes Modell über eine API oder eine offene Bibliothek, protokollieren Sie Eingabeaufforderungen und Versionen und vergleichen Sie es mit einer einfacheren Methode.
Erforschen Sie generative KI durch eine abgegrenzte Anwendung mit Retrieval oder Werkzeugnutzung. Fügen Sie Validierung, Zitate, Berechtigungen und Fallback‑Mechanismen hinzu, sodass das Projekt sowohl Systemtechnik als auch Prompting vermittelt.
KI‑Coding‑Assistenten bewusst einsetzen
Bitten Sie um kleine Funktionen, Tests, Erklärungen, Randfälle und Dokumentationsverweise. Führen Sie statische Prüfungen und Tests durch, überprüfen Sie Änderungen von Abhängigkeiten und fügen Sie niemals Geheimnisse oder private Daten ohne Genehmigung ein. Wenn Sie eine kritische Zeile nicht erklären können, verlangsamen Sie das Tempo.
Ein aussagekräftiges Portfolio zeigt die Fragestellung, Datenrechte, Ausgangsbasis, Methode, Bewertung, Fehler und mögliche Verbesserungen. Abgeschlossene, dokumentierte Kleinstprojekte zeigen mehr Urteilsvermögen als kopierter Code aus einer umfangreichen Demo.
Ein praktischer Lernpfad vom Problem zum Prototyp
Starten Sie mit einer konkreten Aufgabe und einer kleinen Menge repräsentativer Beispiele, anstatt einer breiten Ambition, ‚KI zu lernen‘. Das Klassifizieren von Support‑Nachrichten, das Extrahieren von Rechnungsfeldern oder das Beantworten von Fragen aus genehmigten Dokumenten liefert beobachtbare Eingaben und Ausgaben. Beschreiben Sie, wie ein gutes Ergebnis aussehen soll, bevor Sie ein Modell oder Werkzeug wählen.
No‑Code‑Schnittstellen können Prompting, Datenaufbereitung, Bewertung und Workflow‑Design vermitteln, aber sie ersetzen nicht die Notwendigkeit technischer Urteilsfähigkeit. Lernen Sie Tabellen, Dateien, APIs, Authentifizierung, Variablen, Bedingungen und grundlegende Statistik. Diese Konzepte erklären, wie Daten fließen, warum Integrationen scheitern und was ein Modellergebnis bedeutet – und was es nicht bedeutet.
Erstellen Sie eine Ausgangsbasis mit einer einfachen Regel, einer Suchmethode, einer Tabelle oder einem kleinen Modell. Vergleichen Sie anschließend einen KI‑Ansatz anhand derselben Testfälle. Eine Ausgangsbasis zeigt, ob Komplexität Mehrwert liefert, und gibt Anfängern ein konkretes Debugging‑Ziel. Halten Sie Testdaten getrennt von Beispielen, die zur Konfiguration oder zum Prompten des Systems verwendet werden.
Prompting, APIs und der Übergang zum Code
Ein sinnvolles Prompt definiert die Aufgabe, den relevanten Kontext, Einschränkungen, das Ausgabeschema und bei Bedarf Beispiele. Änderungen am Prompt sind Software‑Änderungen: versionieren Sie sie, testen Sie sie gegen ein festes Bewertungsset und prüfen Sie Fehlermeldungen. Betrachten Sie flüssige Erklärungen des Modells nicht als Beweis dafür, dass die Antwort oder das zitierte Evidenzmaterial korrekt ist.
Workflow‑Builder verbinden Modellaufrufe mit Formularen, Datenbanken, Dateien und Business‑Anwendungen. Verstehen Sie, welche Daten jeder Schritt an Dritte sendet, wie Anmeldedaten gespeichert werden und was bei Zeitüberschreitung oder Wiederholungsversuchen geschieht. Fügen Sie Eingabevalidierung, strukturierte Ausgaben, Rate‑Limits, menschliche Freigabe und Protokolle hinzu, bevor Sie einen Prototyp mit echten Nutzern einsetzen.
Code wird wertvoll, wenn der Workflow benutzerdefinierte Logik, wiederholbare Tests, Skalierbarkeit, Performance, Portabilität oder detaillierte Sicherheitskontrollen erfordert. Python und JavaScript sind gängige Einstiegspunkte, doch die Sprache ist weniger entscheidend als die Grundlagen: Funktionen, Datenstrukturen, Pakete, Fehler, Versionskontrolle und Tests. Verwenden Sie generierten Code nur, nachdem Sie ihn gelesen und sicher ausgeführt haben.
Portfolio‑Projekte, Bewertung und Karriereentwicklung
Ein starkes Anfängerprojekt dokumentiert das Problem, die Nutzer, Datenberechtigungen, die Ausgangsbasis, die Architektur, das Bewertungssatz, Metriken, Fehler, Risiken und die nächsten Schritte. Eine ausgefeilte Oberfläche ohne Bewertung zeigt weniger als ein kleines, reproduzierbares Experiment. Entfernen Sie private Daten und Geheimnisse, bevor Sie Code, Screenshots, Prompts oder Protokolle veröffentlichen.
Bewerten Sie den Erfolg der Aufgabe statt die Eindruckskraft des Modells. Klassifikation erfordert klassenspezifische Präzision und Recall; Extraktion benötigt Feld‑Genauigkeit; Retrieval verlangt Evidenz‑Abdeckung; Generierung braucht Faktentreue, Nützlichkeit, Sicherheit, Latenz und Kosten. Prüfen Sie die Leistung über verschiedene Sprachen, Randfälle und betroffene Gruppen hinweg und definieren Sie, wann ein Mensch entscheiden muss.
KI‑Arbeit umfasst Produktmanagement, Fachwissen, Datenbetrieb, Bewertung, Design, Sicherheit, Richtlinien und Change‑Management sowie die Modellentwicklung. Entwickeln Sie Tiefe in einem Fachgebiet und ausreichende technische Kompetenz, um bereichsübergreifend zusammenzuarbeiten. Glaubwürdige Portfolios erläutern Kompromisse und Einschränkungen, anstatt jedes Prototyp‑Projekt als produktionsreife Automatisierung darzustellen.
Praktisches Beispiel: ein Anfänger erstellt einen Dokument‑Triage‑Assistenten
Ein Lernender sammelt einen kleinen Satz öffentlicher oder erlaubter Dokumente und definiert drei Kategorien sowie ein ‚unsicheres‘ Ergebnis. Er kennzeichnet Beispiele anhand einer schriftlichen Regel, reserviert einen Testdatensatz und implementiert eine Schlüsselwort‑Ausgangsbasis in einer Tabelle. Ein No‑Code‑Modell oder eine API liefert anschließend eine strukturierte Kategorie und ein Konfidenz‑Level, das mit denselben Fällen verglichen wird. Fehl- und mehrdeutige Beispiele werden zum Lernmaterial, nicht zu etwas Verstecktem in einer Demo.
Der Workflow akzeptiert eine Datei, extrahiert Text, entfernt nicht unterstützte Formate, ruft das Modell mit einem festen Schema auf, validiert die Antwort und leitet unsichere Fälle zur Überprüfung weiter. Er speichert nur notwendige Felder und enthält niemals Anmeldedaten in Prompts oder geteilten Screenshots. Der Lernende protokolliert Modellname, Prompt‑Version, Latenz, Kosten und Ausgabe, sodass Änderungen getestet und nicht aus dem Gedächtnis beurteilt werden können.
Ein Portfolio‑Bericht gibt die Präzision und den Recall pro Klasse, Datenschutzannahmen, Fehlbeispiele und die Grenze zwischen Prototyp und Produktion an. Der nächste Codierungsschritt kann eine fragile manuelle Integration durch eine kleine getestete Funktion oder API ersetzen. Dieser Fortschritt vermittelt übertragbare Fähigkeiten: Problemdefinition, Datenqualität, Bewertung, Schnittstellen, Fehlermanagement, Sicherheit und Kommunikation. Diese Grundlagen sind wichtiger, als zu behaupten, man habe nach einem erfolgreichen Beispiel einen anspruchsvollen Agenten gebaut.
Praktische Implementierungs‑Checkliste
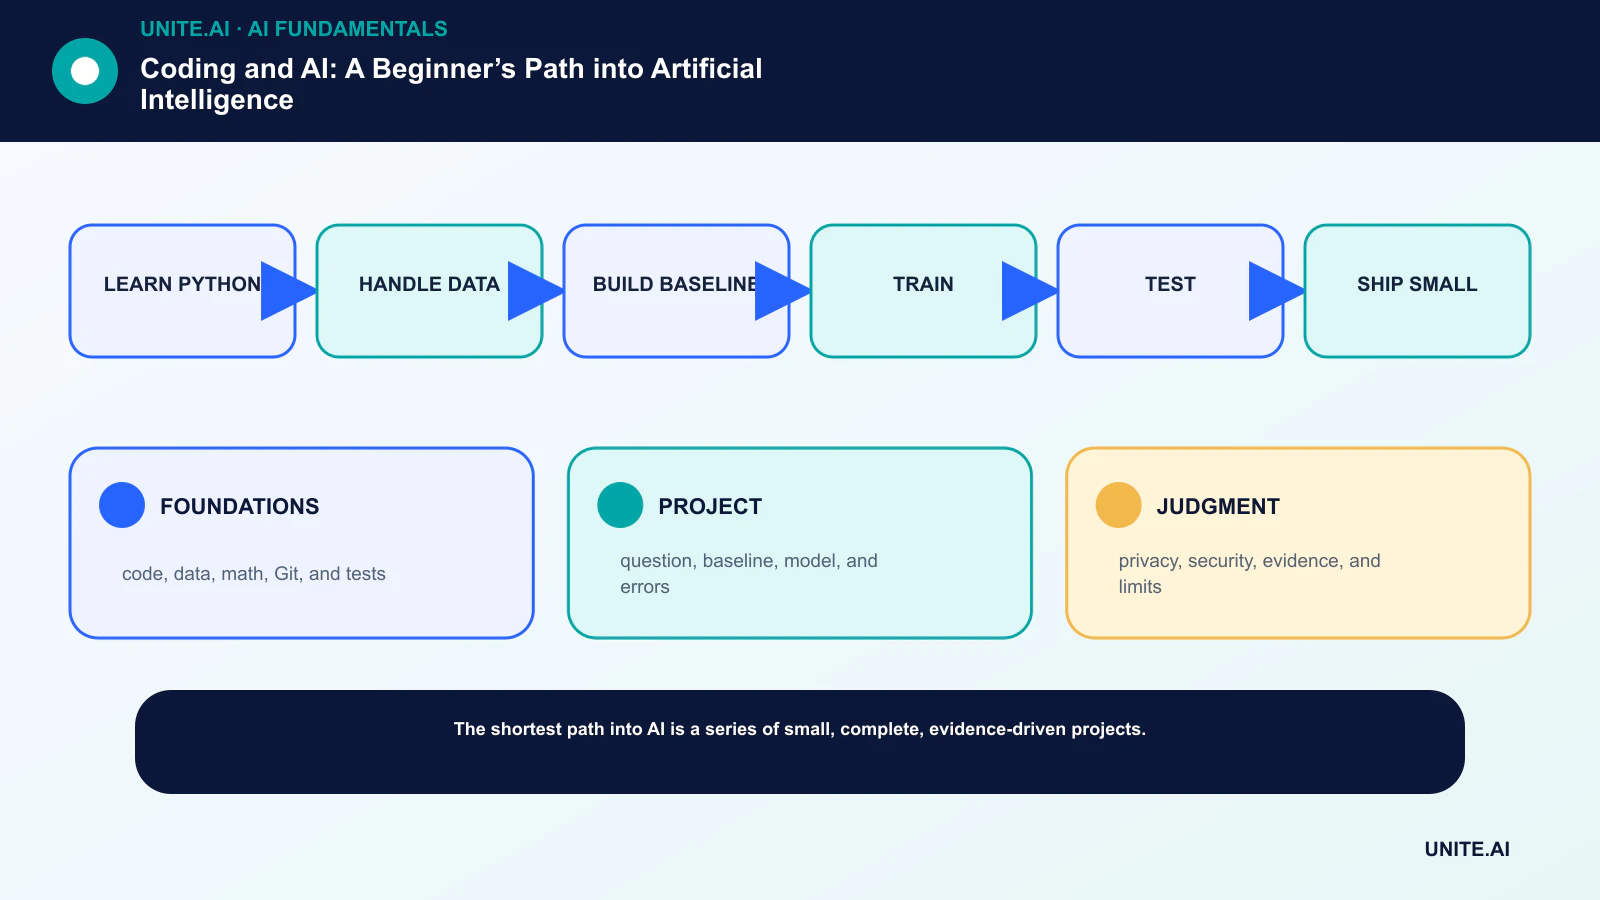
Verwandeln Sie das Konzept in einen abgegrenzten, testbaren Workflow: Python lernen → Daten verarbeiten → Ausgangsbasis erstellen → trainieren → testen → klein ausliefern. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie die Daten und Abhängigkeiten, etablieren Sie eine einfache Ausgangsbasis, definieren Sie Akzeptanz‑ und Abbruchkriterien, testen Sie repräsentative Fehler und legen Sie Monitoring, Rollback und Review fest, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Readiness‑Prüfung mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Ausfälle von Abhängigkeiten und Missbrauch; bewahren Sie die Evidenz und ungelösten Risiken. Definieren Sie, wer die Freigabe genehmigen, einen Schwellenwert ändern, eine Ausgabe überschreiben oder den Betrieb stoppen kann. Überprüfen Sie die Entscheidung erneut, sobald reale Daten vorliegen, da ein technisch erfolgreicher Pilot nicht automatisch zuverlässige Leistung im größeren Maßstab garantiert.
- GRUNDLAGEN: Code, Daten, Mathematik, Git und Tests.
- PROJEKT: Fragestellung, Ausgangsbasis, Modell und Fehler.
- URTEIL: Datenschutz, Sicherheit, Evidenz und Grenzen.
Häufig gestellte Fragen
Brauche ich einen Abschluss in Informatik, um im Bereich KI zu arbeiten?
Nein. Zu den Rollen gehören Engineering, Forschung, Produkt, Design, Betrieb, Daten, Bewertung, Richtlinien und Fachwissen. Jede erfordert ein unterschiedliches Maß an Programmierkenntnissen.
Welche Programmiersprache sollte ein Anfänger lernen?
Python ist eine praktische Erstwahl, weil seine Syntax zugänglich ist und sein Daten‑ und ML‑Ökosystem breit gefächert ist. Die zugrunde liegenden Problemlösungsfähigkeiten lassen sich auf andere Sprachen übertragen.
Primäre Referenzen