
Grundlagen der KI
Was ist Meta-Learning?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Meta-Learning trainiert ein System über eine Verteilung von Aufgaben, sodass es sich an eine neue, verwandte Aufgabe mit begrenzten Daten oder Rechenressourcen anpassen kann. Es wird oft als „Lernen zu lernen“ zusammengefasst, aber das technische Ziel ist präziser: den Lernenden zu optimieren, sodass Erfahrungen aus früheren Aufgaben die Anpassung an eine spätere Aufgabe verbessern.
Meta-Learning überschneidet sich mit Few-Shot-Lernen und Transfer-Lernen, aber die Begriffe sind nicht austauschbar. Few-Shot beschreibt die Menge der Zieldaten; Transfer beschreibt die Wiederverwendung; Meta-Learning macht die Anpassung über Aufgaben hinweg explizit zum Teil des Trainings.
Wesentliche Erkenntnisse
- Meta-Training verwendet viele Aufgaben, nicht nur viele unabhängige Beispiele.
- Eine N-way K-shot‑Episode enthält N Klassen und K gelabelte Unterstützungsbeispiele pro Klasse.
- Gradientenbasierte, metrische, speicherbasierte und gelernte Optimierer‑Methoden passen sich auf unterschiedliche Weise an.
- Die Leistung hängt stark davon ab, ob die Meta‑Training‑Aufgaben der Zielaufgabe ähneln.
Aufgaben, Support‑Mengen und Query‑Mengen
Ein Meta‑Learning‑Datensatz ist als Aufgaben organisiert. Beim Few-Shot‑Klassifizieren kann eine Episode 5-way 1-shot: fünf Klassen, ein gelabeltes Support‑Beispiel pro Klasse und zusätzliche Query‑Beispiele zur Bewertung der Anpassung enthalten. Eine 5-way 5-shot‑Aufgabe hat fünf Support‑Beispiele für jede der fünf Klassen – nicht insgesamt fünf Beispiele.
Während des Meta‑Trainings passt sich der Lernende wiederholt an einer Support‑Menge an und wird anhand einer Query‑Menge bewertet. Das äußere Ziel verbessert die zukünftige Query‑Leistung über Aufgaben hinweg. Meta‑Validierung stimmt Entscheidungen auf separaten Aufgaben ab, und Meta‑Testing evaluiert wirklich ungesehene Aufgaben oder Klassen.
Gradientenbasiertes Meta-Learning
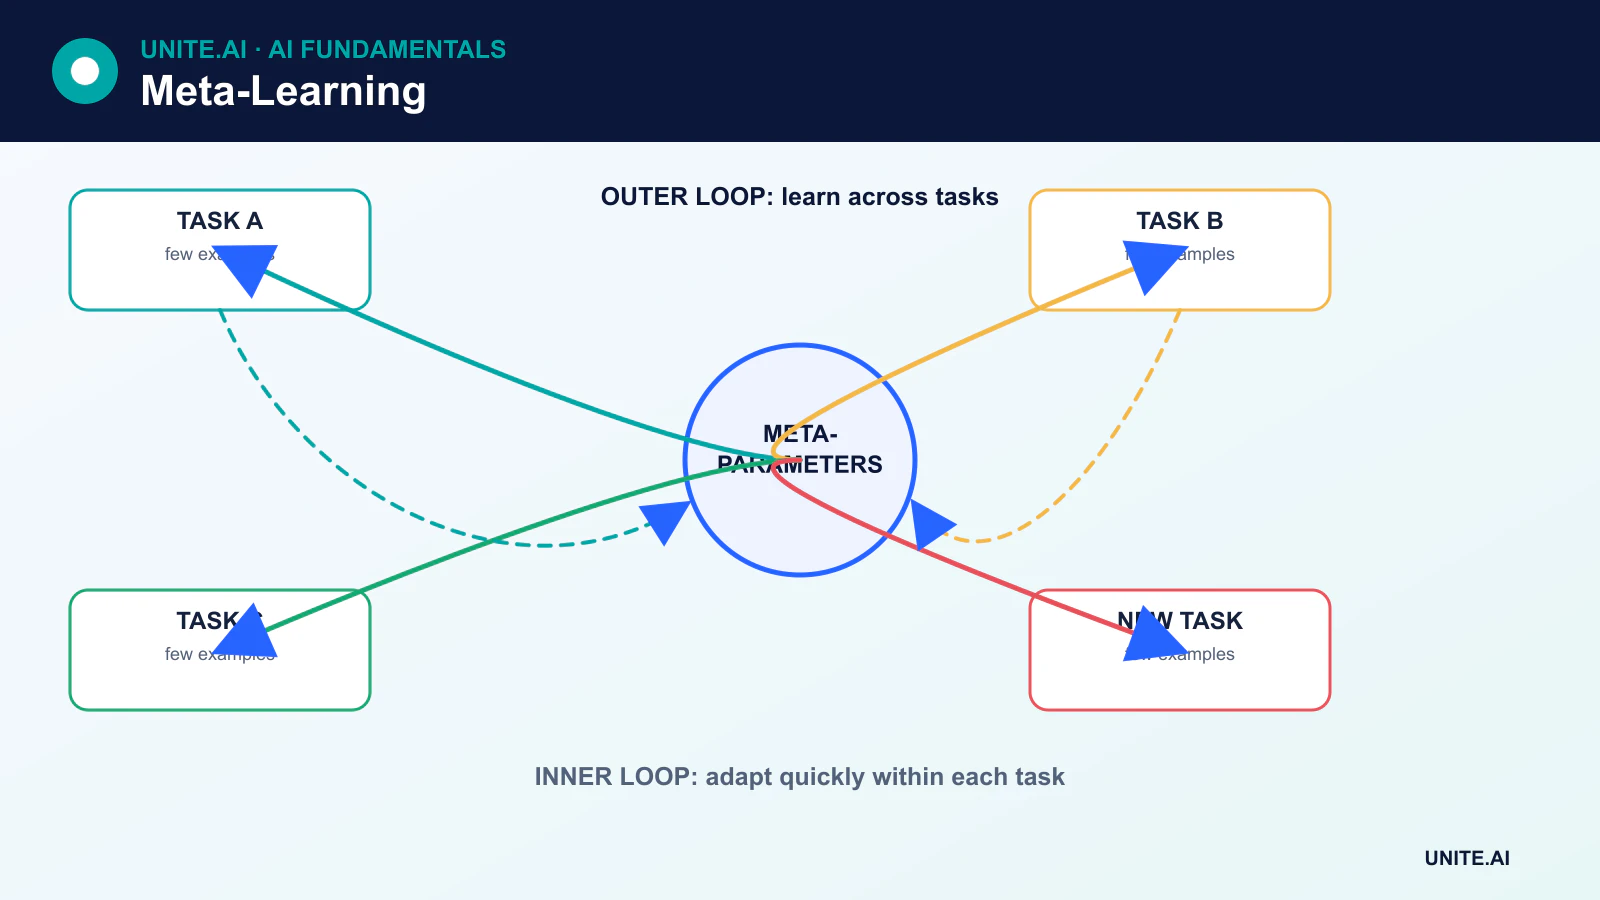
Model-Agnostic Meta-Learning (MAML) lernt eine Initialisierung, von der aus eine kleine Anzahl von Gradienten-Schritten eine gute Leistung bei einer neuen Aufgabe erzeugt. Die innere Schleife passt Modellparameter mithilfe von Support‑Daten an. Die äußere Schleife aktualisiert die gemeinsame Initialisierung anhand des Query‑Verlusts über ausgewählte Aufgaben.
MAML ist nicht auf Klassifikation beschränkt; es kann auf Regression und Verstärkungslernen angewendet werden, wenn Modell und Aufgabe differenzierbar sind. Reptile bietet einen einfacheren Ansatz erster Ordnung, der Parameter in Richtung task‑adaptierter Lösungen bewegt, ohne den vollständigen MAML‑Meta‑Gradienten zu berechnen.
Metrikbasiertes Meta-Learning
Metrikbasierte Methoden lernen eine Einbettung, in der Beispiele derselben Klasse nahe beieinander liegen und verschiedene Klassen getrennt sind. Ein prototypisches Netzwerk mittelt Support‑Einbettungen, um einen Prototyp pro Klasse zu bilden, und klassifiziert Anfragen anhand der Distanz zu diesen Prototypen.
Matching‑ und Siamese‑artige Netzwerke verwenden verwandte Ähnlichkeitsmechanismen. Diese Methoden prüfen nicht nur, ob ein Modell eine Zielmetrik „erreicht“; die gelernte Distanz oder Repräsentation ist selbst Teil des Vorhersageverfahrens.
Speicherbasierte Methoden und gelernte Optimierer
Speicherbasierte Systeme nutzen rekurrente oder aufmerksamkeitsbasierte Zustände, um Informationen über die aktuelle Aufgabe zu speichern. Gelernte Optimierer nehmen Gradienten oder Trainingssignale als Eingaben und lernen, wie ein anderes Modell aktualisiert wird. Diese Methoden können Anpassungsregeln entdecken, fügen jedoch Parameter, Rechenaufwand und eine weitere Ebene potenziellen Overfittings hinzu.
Meta-Learning und In‑Context‑Learning
Große Transformer können ihre Ausgabe anhand von Beispielen, die in einer Eingabeaufforderung bereitgestellt werden, anpassen, ohne Gewichte zu aktualisieren. Dies wird In‑Context‑Learning genannt. Es ähnelt dem Verhalten von Meta-Learning, und Trainingsdaten können die Aufgabeninferenz fördern, doch ein In‑Context‑Lernender wird nicht automatisch mit einem klassischen episodischen Meta-Learning-Ziel trainiert.
Wo Meta-Learning nützlich ist
Mögliche Anwendungsbereiche umfassen Personalisierung, Robotik, Erkennung mit wenig Ressourcen, wissenschaftliche Aufgaben mit wenigen Messungen und schnelle Anpassung an neue Umgebungen. Meta-Learning ist besonders attraktiv, wenn viele verwandte Quell‑Aufgaben verfügbar sind, aber Daten für die Ziel‑Aufgabe knapp sind.
Einschränkungen
Meta-Learning kann rechenintensiv sein, da das Training die Anpassung in die Optimierung einbettet. Die Ergebnisse sind empfindlich gegenüber Aufgaben‑Konstruktion, Support‑/Query‑Leckage, Architektur und Domänen‑Shift. Ein auf engen, homogenen Aufgaben trainiertes Modell kann sich außerhalb dieser Verteilung schlecht anpassen.
Vergleiche sollten herkömmliches Transfer‑Learning und Multitask‑Baselines einschließen. Eine starke vortrainierte Repräsentation, gefolgt von standardmäßigem Fine‑Tuning, kann einfacher und effektiver sein als ein dedizierter Meta‑Learning‑Algorithmus.
Aufgaben, Anpassung und die innere‑äußere Optimierungsstruktur
Meta‑Learning trainiert über eine Verteilung von Aufgaben, sodass ein Lernender sich mit begrenzten Daten oder Aktualisierungen an eine neue Aufgabe anpassen kann. Jede Episode wählt eine Aufgabe aus, teilt Beispiele in eine Support‑Menge für die Anpassung und eine Query‑Menge für die Bewertung und aktualisiert das geteilte Wissen über die Episoden hinweg. Metrikbasierte Methoden lernen eine Einbettung und Vergleichsregel; optimierungsbasierte Methoden lernen eine Initialisierung oder Aktualisierungs‑Verhalten; speicher‑ und modellbasierte Methoden konditionieren auf Aufgabenbeispiele. Die Aufgabenverteilung ist die reale Trainingsdatenbasis und muss zukünftigen Anpassungsproblemen ähneln.
Beim modellagnostischen Meta‑Learning passt eine innere Schleife Parameter anhand von Support‑Beispielen an und eine äußere Schleife optimiert die Leistung auf Query‑Beispielen nach der Anpassung. Höher‑ordentliche Gradienten können teuer sein; Approximationen erster Ordnung tauschen Treue gegen Kosten. Prototypische Netzwerke repräsentieren jede Klasse durch einen Support‑Mengen‑Zentroid und klassifizieren anhand der Distanz. Diese Methoden gehen davon aus, dass Klassengeometrie, Anpassungsschritte und Episoden‑Konstruktion die Einsatzbedingungen widerspiegeln. Eine Methode kann schnell zu lernen scheinen, während sie feste Labels, Akquisitionsartefakte oder Überschneidungen zwischen Quell‑Datensätzen ausnutzt.
Evaluation, Baselines und reale Einschränkungen
Separate Trainings‑, Validierungs‑ und Test‑Aufgaben – nicht nur Beispiele – zur Messung der Anpassung an wirklich ungesehene Aufgaben. Genauigkeit oder Verlust als Funktion von Shots und Anpassungsschritten, Konfidenzintervalle über Aufgaben, Rechenaufwand, Speicher und Empfindlichkeit gegenüber der Zusammensetzung der Support‑Menge berichten. Vergleiche mit Transfer‑Learning, Fine‑Tuning eines vortrainierten Modells, nächsten Nachbarn und einem Modell, das gemeinsam auf allen Quell‑Daten trainiert wurde. Viele scheinbare Meta‑Learning‑Gewinne schrumpfen, wenn Baselines gleichwertige Backbones, Augmentation und Tuning erhalten.
Echte Einsätze benötigen eine Möglichkeit zu erkennen, wann eine neue Aufgabe außerhalb der Meta‑Training‑Verteilung liegt. Schlechte oder falsch gelabelte Support‑Beispiele können zu schnellen, zuversichtlichen Fehlfunktionen führen. Begrenzen Sie die Aktualisierungs‑Magnitude, validieren Sie angepasste Modelle, bewahren Sie ein Fallback und schützen Sie Adaptionsdaten vor Vergiftungen. Verfolgen Sie Basis‑Modell, Aufgaben‑Sampler, Episoden‑Seeds und Adaptionscode. Meta‑Learning ist nützlich für wiederholte Familien von Small‑Data‑Problemen, erzeugt jedoch keine allgemeine Lernfähigkeit aus beliebigen Beispielen und beseitigt nicht den Bedarf an domänenspezifischer Evaluation.
Praktisches Beispiel: Few‑Shot‑Anpassung über Maschinen hinweg
Ein Hersteller behandelt jeden Maschinentyp als Aufgabe und meta‑trainiert eine Anomalie‑Repräsentation über viele Maschinen mit verifizierten Wartungsergebnissen. Testmaschinen werden vollständig vom Aufgaben‑Training ausgeschlossen. Für eine neue Maschine deckt eine kleine Support‑Menge normale Betriebsmodi ab, statt beliebiger Minuten an Daten. Meta‑Learning wird mit einem vortrainierten, eingefrorenen Encoder, nächsten Nachbarn und gewöhnlichem Fine‑Tuning unter Verwendung derselben Support‑Beispiele und des gleichen Rechenaufwands verglichen.
Die Evaluation wiederholt viele Support‑Auswahlen und berichtet über Ereignis‑Recall, Fehlalarme, Anpassungszeit und Varianz. Das System verzichtet, wenn das Sensorset oder die Dynamik der neuen Maschine außerhalb der Aufgaben‑Verteilung liegen. Anpassungs‑Updates sind begrenzt und werden geprüft, bevor sie die Wartung beeinflussen. Support‑Labels und Maschinenidentität sind vor Vergiftungen geschützt, und jedes angepasste Modell behält seine Basisversion und Beispiele bei. Schnelle Anpassung wird nur akzeptiert, wenn sie konsequent einfachere Transfer‑Methoden unter realistischen Aufgaben‑Shifts übertrifft.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Tuning. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungs‑Shift, Ausfall von Abhängigkeiten, Missbrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgaben‑Qualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollte die Zuständigkeit für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zugewiesen werden. Verwenden Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingebrachten Fehlfunktionen. Operative Telemetrie sollte die Eingabe‑Qualität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie danach reale Evidenz nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Incidents, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist Few‑Shot‑Prompting Meta‑Learning?
Few‑Shot‑Prompting ist eine In‑Context‑Anpassungstechnik. Es kann Verhaltensweisen zeigen, die mit Lernen über Aufgaben hinweg verbunden sind, aber es wird nicht automatisch mit Support‑/Query‑Episoden oder einer expliziten Meta‑Optimierungsschleife trainiert.
Was ist das größte Risiko beim Meta‑Learning?
Eine Diskrepanz zwischen Meta‑Training‑Aufgaben und der Ziel‑Aufgabe kann schnelle Anpassung in einem Benchmark stark erscheinen lassen, aber im Einsatz scheitern. Aufgaben‑Splits und die Herkunft der Quellen müssen ebenso sorgfältig geprüft werden wie herkömmliche Train‑/Test‑Splits.
Primärreferenzen











