Grundlagen der KI
Was ist Transferlernen?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Transferlernen nutzt Wissen, das für ein Problem erlernt wurde, um das Lernen bei einem verwandten Problem zu verbessern. Anstatt jeden Parameter zufällig zu initialisieren, beginnt ein Praktiker mit einem vortrainierten Modell oder einer Repräsentation und passt es an eine Zielaufgabe an.
Dieser Ansatz ist besonders nützlich, wenn der Ziel‑Datensatz klein ist, das Labeln teuer ist oder das Vor‑Training mehr Rechenleistung erfordert, als das Zielteam rechtfertigen kann. Ein Modell von Grund auf zu trainieren ist die Alternative zum Transferlernen – kein Typ des Transferlernens.
Wesentliche Erkenntnisse
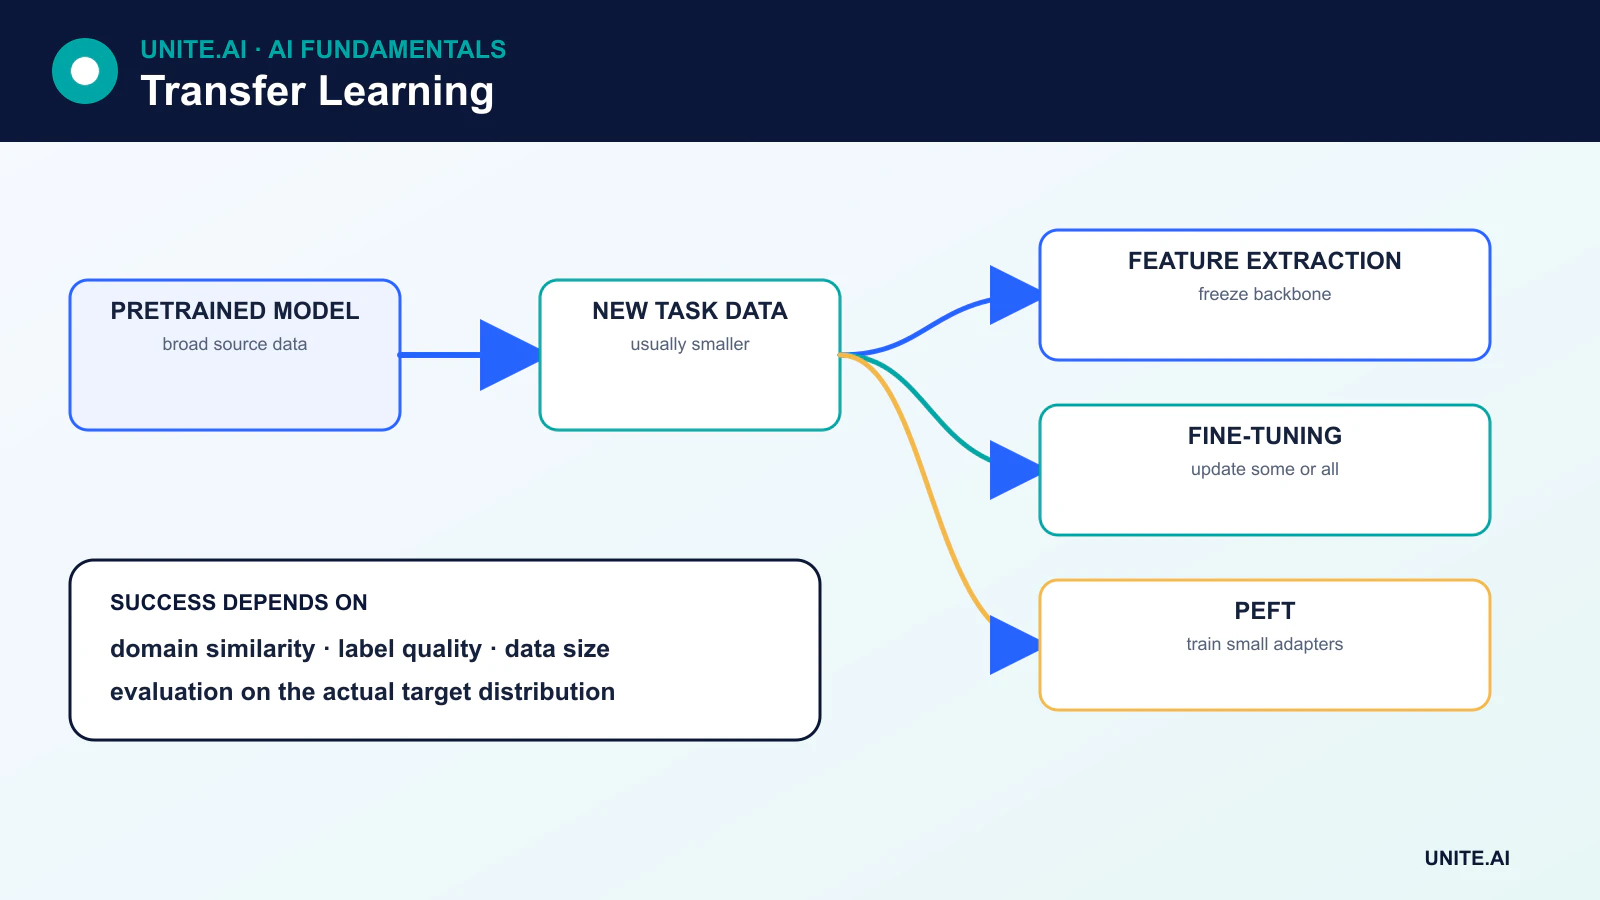
- Feature‑Extraktion lässt die vortrainierte Basis eingefroren und trainiert einen neuen, auf die Aufgabe zugeschnittenen Kopf.
- Fine‑Tuning aktualisiert einige oder alle vortrainierten Parameter mithilfe von Daten der Zieldomäne.
- Parameter‑effiziente Methoden wie Adapter und LoRA aktualisieren einen kleinen Teil des Modells.
- Transfer kann scheitern, wenn sich Quell‑ und Zieldomäne unterscheiden, Lizenzen konfligieren oder das Quellmodell ungeeignete Vorurteile enthält.
Warum Transferlernen funktioniert
Modelle lernen häufig Repräsentationen, die über die genauen Daten, auf denen sie trainiert wurden, hinaus nützlich sind. Frühe Schichten eines Bildmodells können wiederverwendbare lokale Muster erfassen; ein Sprachmodell kann Syntax, Semantik und breite Assoziationen durch selbstüberwachtes Vorhersagen erlernen. Eine Zielaufgabe kann auf diesen Repräsentationen aufbauen, anstatt alles aus begrenzten Beispielen neu zu lernen.
Der Nutzen hängt von der Ähnlichkeit zwischen Quell‑ und Zielaufgaben, dem Umfang und der Qualität des Vor‑Trainings sowie der Art der Modellanpassung ab. Wiederverwendung ist nicht garantiert: übertragene Merkmale können irrelevant oder sogar schädlich sein.
Feature‑Extraktion
Bei der Feature‑Extraktion wird die vortrainierte Basis eingefroren, sodass sich ihre Parameter nicht ändern. Ihre Ausgabe dient als Eingabe für einen neuen Klassifikator, Regressor oder einen anderen auf die Aufgabe zugeschnittenen Kopf. Nur der neue Kopf wird trainiert.
Dies ist schnell und dateneffizient und verringert das Risiko, nützliche vortrainierte Repräsentationen zu zerstören. Es kann jedoch zu Unteranpassung führen, wenn die Zieldomäne stark von dem Vor‑Training abweicht. Schichten wie Batch‑Normalization erfordern besondere Sorgfalt, da ihre gespeicherten Statistiken und das Trainingsverhalten die Anpassung beeinflussen können, selbst wenn die meisten Gewichte eingefroren sind.
Fine‑Tuning
Fine‑Tuning aktualisiert vortrainierte Parameter anhand von Zieldaten. Ein gängiger Arbeitsablauf ist:
- Lade das vortrainierte Modell und ersetze oder füge den Ausgabekopf hinzu.
- Friere die Basis ein und trainiere den neuen Kopf.
- Entfriere ausgewählte Schichten – oder das gesamte Modell – und fahre mit einer kleineren Lernrate fort.
- Validiere hinsichtlich Overfitting, Forgetting und der Leistung in der Zieldomäne.
Es gibt keine universelle Regel, dass nur die letzten Schichten angepasst werden sollten. Die beste Wahl hängt von Architektur, Größe der Zieldaten, Domänenähnlichkeit, Normalisierungsschichten, Speicher und Rechenleistung ab. Vollständiges Fine‑Tuning kann mehr Kapazität bieten, erfordert jedoch mehr Ressourcen und kann zu katastrophalem Forgetting führen.
Parameter‑effizientes Fine‑Tuning
Große Transformer machen vollständiges Fine‑Tuning kostenintensiv. Parameter‑effizientes Fine‑Tuning (PEFT) modifiziert oder fügt einen kleinen Satz von Parametern hinzu, während der Großteil des Basismodells eingefroren bleibt.
- Adapter fügen kleine trainierbare Module in das Netzwerk ein.
- LoRA stellt Gewichtsupdates mit niederrangigen Matrizen dar, wodurch trainierbare Parameter und Optimierer‑Speicher reduziert werden.
- Prompt‑ und Prefix‑Tuning lernen kontinuierliche, auf die Aufgabe zugeschnittene Eingaben oder interne Präfixe.
PEFT kann viele Aufgaben‑Adaptionen um ein Basismodell herum speichern, obwohl das Bereitstellen von Inferenz, die Kompatibilität von Adaptern und das Management zusammengeführter Gewichte weiterhin sorgfältige Engineering erfordern.
Transferlernen über Datentypen hinweg
Bildklassifikatoren beginnen häufig mit Modellen, die auf großen Bilddatensätzen vortrainiert wurden. Sprachsysteme starten von einem Grundmodell und passen es durch überwachtes Fine‑Tuning, Präferenzoptimierung, Retrieval oder Werkzeugnutzung an. Sprach‑, Audio‑, Protein‑ und multimodale Modelle folgen ähnlichen Mustern.
Transfer kann auch ohne Änderung des Originalmodells stattfinden. Ein eingefrorenes Modell kann Embeddings für einen nachgelagerten Klassifikator, ein Vektor‑Ähnlichkeitssuch-System oder eine Retrieval‑Pipeline erzeugen.
Domänenverschiebung und negativer Transfer
Domänenverschiebung tritt auf, wenn Ziel‑Inputs von den Quelldaten abweichen. Ein medizinisches Bildmodell kann beispielsweise auf Geräte, Populationen oder Erfassungsprotokolle stoßen, die im Vor‑Training nicht vorhanden waren. Negativer Transfer bedeutet, dass die Wiederverwendung die Ziel‑Performance schlechter macht als ein geeigneter von‑Grund‑auf‑Basis‑Baseline.
Teams sollten Anpassungsstrategien vergleichen, sinnvolle Untergruppen evaluieren und einen Test‑Set der Zieldomäne beibehalten. Wenn die Quellaufgabe schlecht passt, kann ein kleineres domänenspezifisches Modell ein größeres allgemeines Modell übertreffen.
Lizenzierung, Herkunft und Sicherheit
Ein herunterladbares Modell ist nicht automatisch sicher einsetzbar. Prüfen Sie die Lizenz, erlaubte Verwendungen, Offenlegung der Trainingsdaten, Einschränkungen der Model‑Card und die Abhängigkeitskette. Modelle können Vorurteile reproduzieren, sensible Daten memorisieren oder bösartigen serialisierten Code enthalten. Verwenden Sie vertrauenswürdige Formate, scannen Sie Artefakte und laden Sie nicht vertrauenswürdige Gewichte in einer isolierten Umgebung.
Wann Transferlernen einsetzen
Transferlernen ist die bevorzugte Standardlösung, wenn ein relevantes vortrainiertes Modell existiert und die Zieldaten begrenzt sind. Von Grund auf zu trainieren kann vorzuziehen sein, wenn die Domäne stark spezialisiert ist, Lizenzen inkompatibel sind, die Modellgröße die Deploy‑Grenzen überschreitet oder eine einfache Aufgabe nicht von einer großen vortrainierten Repräsentation profitiert. Die Entscheidung sollte empirisch validiert werden, anstatt sie allein aus der Modellgröße abzuleiten.
Was wird übertragen und wie man es anpasst
Transferlernen nutzt Repräsentationen, die auf einer Quellaufgabe oder einem Datensatz erlernt wurden, für eine Zielaufgabe. In der Bildverarbeitung erfassen frühe Merkmale oft Kanten und Texturen; in der Sprache kodieren vortrainierte Modelle statistische Muster über Tokens und Kontexte. Transfer funktioniert, wenn Quell‑Repräsentationen Informationen enthalten, die für das Ziel relevant sind, doch Domänen‑, Label‑, Modalitäts‑ und Erfassungsunterschiede können zu negativem Transfer führen. Beginnen Sie mit einer vortrainierten Basis, prüfen Sie deren Trainingslizenz und Dokumentation und vergleichen Sie sie mit dem Training eines kleinen, ziel‑spezifischen Modells von Grund auf.
Feature‑Extraktion friert das Backbone ein und trainiert einen neuen Kopf; partielles Fine‑Tuning entfriert ausgewählte Schichten; vollständiges Fine‑Tuning aktualisiert das gesamte Modell. Parameter‑effiziente Methoden fügen Adapter oder Niederrang‑Updates hinzu, reduzieren die trainierbaren Parameter, aber nicht zwingend den Inferenz‑Speicher. Verwenden Sie eine niedrigere Lernrate für vortrainierte Gewichte, bewahren Sie das Normalisierungsverhalten und vermeiden Sie katastrophales Forgetting mittels Zeitplänen, Regularisierung, Wiederholung oder eingeschränkten Updates, wo nötig. Wählen Sie Checkpoints anhand der Ziel‑Validierungsdaten und testen Sie mehrere Seeds, da kleine Zieldatensätze eine hohe Varianz erzeugen.
Daten, Bewertung und Bereitstellungs‑Komprimisse
Zieldaten sollten die Bereitstellungsbedingungen und wichtige Untergruppen repräsentieren, nicht nur eine bequeme gelabelte Stichprobe sein. Teilen Sie nach Subjekt, Quelle, Zeit oder Ort, um zu verhindern, dass verwandte Beispiele Partitionen überschreiten. Testen Sie sowohl In‑Domain‑ als auch verschobene Bedingungen. Vergleichen Sie eingefrorene, teilweise abgestimmte und vollständig abgestimmte Varianten hinsichtlich Qualität, Kalibrierung, Trainingskosten, Latenz und Robustheit. Eine Verbesserung des Durchschnittsscores kann einen Verlust bei seltenen Klassen verbergen, die aus dem Quell‑Bias stammen. Prüfen Sie Fehlbeispiele auf quellspezifische Abkürzungen, Vokabularlücken oder Sensors Unterschiede.
Verfolgen Sie das Basismodell, Gewichte, Tokenizer oder Vorverarbeitung, Adapter, Daten und Lizenz als einen Abhängigkeitsgraphen. Gehostete Basismodelle können ihr Verhalten ändern; offene Gewichte können Lieferketten‑ und Patch‑Verantwortungen einführen. Validieren Sie das zusammengeführte oder exportierte Artefakt und scannen Sie Modelldateien aus nicht vertrauenswürdigen Quellen. In der Produktion überwachen Sie Ziel‑Drift und Performance und behalten die Möglichkeit, sowohl die Anpassung als auch die Basisversion zurückzusetzen. Transfer reduziert den Bedarf an Zieldaten; es eliminiert nicht das Labeln, die Bewertung, den Datenschutz oder die Domänen‑Expertise.
Praktisches Beispiel: Anpassung eines Vision‑Modells an eine neue Klinik
Eine Klinik passt einen vortrainierten Bild‑Encoder an, um die Bildqualität vor der diagnostischen Prüfung zu klassifizieren. Sie prüft die Lizenz des Quellmodells und die beabsichtigte Modalität, sammelt lokale Geräte und Erfassungsbedingungen und teilt nach Patienten. Varianten mit eingefrorenen Features, Adapter, partielles und vollständiges Fine‑Tuning werden mit einer kleinen lokalen Basis verglichen. Metriken umfassen Klassen‑Recall, Kalibrierung, Untergruppen‑Verhalten, Rechenaufwand und Empfindlichkeit gegenüber Gerät, Standort und seltenen Artefakten.
Das angepasste Modell kann keine Diagnose stellen und leitet Bilder mit geringer Sicherheit oder nicht unterstützten Formaten an Techniker weiter. Die Export‑Validierung bestätigt die lokale Vorverarbeitung und numerische Äquivalenz. Modell‑, Adapter‑, Geräte‑ und Datensatz‑Versionen werden im Protokoll verknüpft. Monitoring erkennt neue Scanner, Protokolländerungen und Output‑Drift, während periodisch geprüfte Stichproben die reale Leistung schätzen. Ein Upgrade des Quellmodells wird als neue Abhängigkeit behandelt, die Validierung erfordert; Transferlernen rechtfertigt nicht automatisch die Wiederverwendung alter Evidenz.
Implementierungsnachweise und operative Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die beabsichtigten Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, Verantwortlichen und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie vor dem Tuning einen reproduzierbaren Ausgangszustand und einen versionierten Evaluations‑Datensatz. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungs‑Shift, Ausfall von Abhängigkeiten, Missbrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten benachteiligt sind. Messen Sie die Aufgaben‑Qualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Sie die Zuständigkeit für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung festlegen. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und verifizieren Sie das Monitoring mit bewusst eingefügten Fehlfunktionen. Operative Telemetrie sollte die Eingabe‑Qualität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse aufzeigen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie nach der Bereitstellung Evidenz aus der Praxis, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Vorfall‑Prozesse, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Primärreferenzen