Grundlagen der KI
Was ist Gradientenabstieg?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Gradientenabstieg ist ein Optimierungsverfahren, das Modellparameter anpasst, um eine Zielfunktion zu reduzieren. Beim Training von neuronalen Netzen ist dieses Ziel in der Regel ein über Beispiele berechneter Verlust. Der Gradient zeigt in die Richtung des steilsten lokalen Anstiegs, sodass Gradient Descent einen Schritt in die entgegengesetzte Richtung macht.
Der Gradient beschreibt die lokale Empfindlichkeit; seine Größe ist keine direkte Messgröße dafür, wie schnell ein Modell „lernt“. Der tatsächliche Fortschritt hängt zudem von der Lernrate, Krümmung, Rauschen, Parametrisierung, dem Optimierer‑Zustand und den Daten ab.
Wesentliche Erkenntnisse
- Backpropagation berechnet Gradienten, während Gradient Descent sie zur Aktualisierung der Parameter verwendet.
- Mini‑Batch‑Optimierung ist der gängige praktische Ansatz für Deep Learning.
- Die Lernrate steuert die Skalierung der Updates und kann einem Zeitplan folgen, anstatt nach jedem Schritt zu schrumpfen.
- Momentum, AdamW, Clipping und Normalisierung adressieren unterschiedliche Optimierungsprobleme.
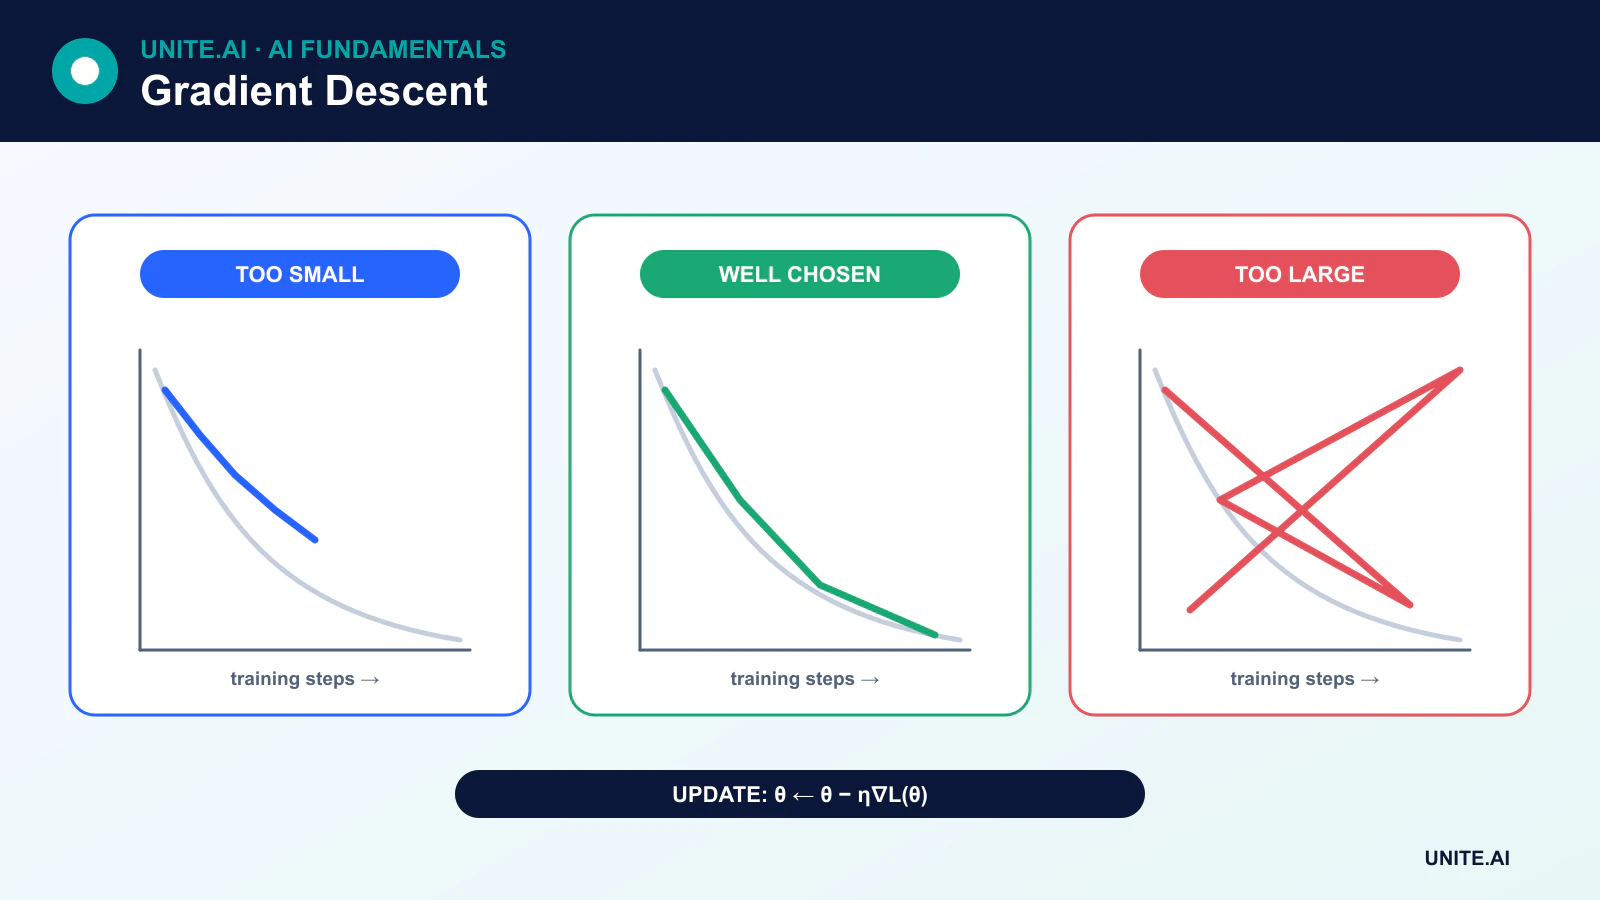
Die grundlegende Aktualisierungsregel
Für den Parametervektor θ, die Lernrate η und den Verlust L:
θ ← θ - η∇L(θ)
Der Gradient ∇L(θ) enthält für jeden Parameter eine partielle Ableitung. Das Subtrahieren führt zu einem lokalen Abstieg. Ein stationärer Punkt hat einen Gradienten von null, kann jedoch ein Minimum, Maximum, Sattelpunkt oder eine flache Region sein. Verlustflächen im Deep Learning sind nicht konvex, sodass das Training nicht garantiert ein eindeutiges globales Minimum oder einen Verlust von null findet.
Batch‑, stochastische und Mini‑Batch‑Methoden
Batch‑Gradientenabstieg
Batch‑Gradientenabstieg berechnet den Gradient mithilfe des gesamten Trainingsdatensatzes für jedes Update. Die Schätzung ist stabil, kann jedoch zeit- und speicherintensiv sein, und ein einzelnes Update kann moderne Beschleuniger unterausnutzen.
Stochastischer Gradientenabstieg
Strenger stochastischer Gradientenabstieg verwendet pro Update ein zufällig ausgewähltes Beispiel. Seine Gradienten sind verrauscht, was die Erkundung der Verlustfläche unterstützen kann, jedoch können Operationen mit einem einzelnen Beispiel auf paralleler Hardware ineffizient sein.
Mini‑Batch‑Gradientenabstieg
Mini‑Batch‑Training schätzt den Gradient aus einer Teilmenge von Beispielen. Es balanciert statistisches Rauschen mit effizienten Matrixoperationen und ist der übliche Ansatz im Deep Learning. Die Batch‑Größe beeinflusst Speicher, Durchsatz, Gradientenrauschen, Normalisierung und manchmal die Generalisierung.
Auswahl einer Lernrate
Eine zu große Lernrate kann nützliche Regionen überspringen oder zu Divergenz führen. Eine zu kleine Lernrate kann das Training unpraktisch langsam machen oder in flachen Regionen stagnieren. Die optimale Skalierung hängt vom Optimierer, der Batch‑Größe, dem Modell, der Initialisierung und dem Ziel ab.
Zeitpläne können allmählich aufwärmen, an Meilensteinen abklingen, einer Kosinuskurve folgen oder auf Validierungsfortschritt reagieren. Die Lernrate muss nicht nach jedem Update monoton schrumpfen. Warm‑Restarts und zyklische Pläne erhöhen sie bewusst in Teilen des Trainings.
Momentum
Momentum hält einen exponentiell gleitenden Mittelwert vergangener Gradienten. Es kann den Fortschritt in konsistenten Richtungen beschleunigen und Oszillationen in steilen, engen Richtungen reduzieren. Nesterov‑ähnliches Momentum bewertet oder approximiert den Gradient, nachdem es entlang der Momentum‑Richtung vorausgeschaut hat.
Adaptive Optimierer
RMSProp skaliert Updates mithilfe eines gleitenden Mittelwerts quadratischer Gradienten. Adam kombiniert momentum‑ähnliche erste Momente mit einer Skalierung nach dem zweiten Moment. AdamW entkoppelt das Gewichtsnormieren (Weight Decay) vom adaptiven Gradient‑Update und wird häufig für Transformer eingesetzt.
Adaptive Optimierer erleichtern oft das frühe Training, sind jedoch nicht automatisch überlegen für jedes Modell oder das endgültige Generalisierungsziel. Optimierer‑Vergleiche erfordern abgestimmte Zeitpläne und sorgfältige Feinabstimmung.
Gradienten‑Clipping und -Akkumulation
Gradienten‑Clipping begrenzt die Norm oder Werte eines Gradienten, um die Auswirkungen explodierender Gradienten zu reduzieren, insbesondere beim rekurrenten oder instabilen Training. Gradient‑Akkumulation addiert Gradienten über mehrere kleinere Batches hinweg vor einem Update und approximiert so einen größeren effektiven Batch, wenn der Speicher begrenzt ist.
Überwachung der Optimierung
Verfolgen Sie Trainings‑ und Validierungsverlust, Aufgabenmetriken, Lernrate, Gradient‑Normen, Parameter‑Normen und numerische Fehler. Ein sinkender Trainingsverlust bei gleichzeitig verschlechternder Validierungsleistung deutet auf Overfitting hin, nicht auf einen Optimierungserfolg, der automatisch fortgesetzt werden sollte.
Optimierung minimiert das gegebene Ziel. Ein niedriger Verlust beweist nicht, dass die Daten, die Metrik oder das Verhalten in der realen Welt angemessen sind. Datenlecks, schlechte Labels und ein missaligned Ziel können ein gut optimiertes, aber schädliches Modell erzeugen.
Optimierungsgeometrie und Aktualisierungsregeln
Gradientenabstieg aktualisiert Parameter entgegen dem Gradient eines Verlustes. Voll‑Batch‑Abstieg verwendet für jeden Schritt jedes Trainingsbeispiel; stochastischer Abstieg verwendet eines; Mini‑Batch‑Methoden schätzen den Gradient aus einer Teilmenge und dominieren das Deep Learning. Die Lernrate bestimmt die Schrittgröße. Zu klein verschwendet Rechenleistung oder führt zu Stagnation; zu groß verursacht Oszillation oder Divergenz. Momentum akkumuliert eine gleitende Richtung, während adaptive Methoden wie Adam Koordinaten anhand von Gradient‑Momenten skalieren. Ihre unterschiedlichen impliziten Verzerrungen können Modelle mit ähnlichem Trainingsverlust, aber unterschiedlicher Generalisierung erzeugen.
Verlustflächen in neuronalen Netzen enthalten flache und scharfe Regionen, Sattelpunkte, Symmetrien und schlecht konditionierte Richtungen. Feature‑Scaling, Normalisierung, Initialisierung, Residual‑Verbindungen und Prä‑Konditionierung verändern die vom Optimierer wahrgenommene Geometrie. Zeitpläne können aufwärmen, abklingen, zyklisch sein oder auf Plateaus reagieren. Gewichtsnormierung (Weight Decay) unterscheidet sich in einigen adaptiven Optimierern vom bloßen Hinzufügen einer L2‑Strafe. Die Batch‑Größe beeinflusst Rauschen, Speicher, Parallelität und das Lernraten‑Regime, sodass Optimierer‑Vergleiche abgestimmte Trainingsbudgets und sorgfältige Feinabstimmung erfordern.
Diagnose, Reproduzierbarkeit und Abbruch
Verfolgen Sie Trainings‑ und Validierungsverlust, Aufgabenmetriken, Gradient‑ und Parameter‑Normen, Lernrate, Durchsatz und numerische Warnungen. Divergenz kann durch fehlerhafte Batches, ungültige Labels, instabile gemischte Präzision oder eine falsche Verlust‑Reduktion entstehen. Plateaus können auf Unterkapazität, gesättigte Aktivierungen, schlechte Features, übermäßige Regularisierung oder ein Zeitplan‑Problem hinweisen. Overfitting erfordert Daten, Augmentation, Regularisierung oder Early Stopping – nicht die Behauptung, dass der Optimierer versagt hat. Untersuchen Sie repräsentative Fehler und vergleichen Sie ein einfaches Basismodell, bevor Sie die Trainingskomplexität erhöhen.
Reproduzierbarkeit erfordert Seeds, Datenreihenfolge, Code, Konfiguration, Hardware‑ und Bibliotheksversionen, obwohl einige Accelerator‑Kernels nondeterministisch bleiben. Speichern Sie Checkpoints mit Optimierer‑ und Scheduler‑Zustand, damit das Training konsistent fortgesetzt werden kann. Wählen Sie einen Checkpoint anhand vorher festgelegter Validierungskriterien und reservieren Sie ein unberührtes Testset. Beim verteilten Training bestätigen Sie die effektive Batch‑Größe, das Gradient‑Mittelwertverfahren und den Umgang mit ausgefallenen Workern. Optimierung minimiert das gewählte Ziel auf verfügbaren Daten; sie garantiert jedoch keine kalibrierten Wahrscheinlichkeiten, kausales Schließen, Fairness, Sicherheit oder Nutzen in der realen Welt.
Praktisches Beispiel: Abstimmung eines Optimierers für ein Sprachmodell
Ein Team legt Tokenizer, Datenreihenfolge, Modell, effektiven Batch und das Trainings‑Token‑Budget fest und vergleicht anschließend SGD mit Momentum und AdamW über vertretbare Lernraten‑Zeitpläne. Aufwärmen, Abklingen, Gewichtsnormierung, Clipping und Präzision werden protokolliert. Jeder Kandidat wird mit mehreren Seeds ausgeführt, und die Validierung nutzt einen zurückgehaltenen Zeitabschnitt plus Aufgaben‑Evaluierungen. Durchsatz und Energie werden zusammen mit dem Verlust gemeldet, sodass ein leicht besserer Optimierer nicht zu unverhältnismäßigen Kosten ausgewählt wird.
Diagnosen zeigen, ob Instabilität aus einem Daten‑Shard, zu großer Schrittweite, Unterlauf oder der Modellarchitektur stammt. Checkpoints bewahren Optimierer‑ und Scheduler‑Zustand und werden in einem Test fortgesetzt. Die endgültige Wahl basiert auf Validierungsqualität und Robustheit, nicht auf dem niedrigsten Trainingsverlust. Ein versiegeltes Testset wird einmal nach der Auswahl ausgeführt. Die Produktion‑Inference wird separat kalibriert und überwacht, da der Optimierer‑Erfolg während des Vortrainings kein sicheres oder wahres Verhalten garantiert.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Verantwortlichen und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor der Feinabstimmung. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten benachteiligt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und den Nachweis von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Sie die Zuständigkeit für Release, Ausnahmen, Änderungen, Rollback und Stilllegung festlegen. Verwenden Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und prüfen Sie dann nach der Bereitstellung reale Evidenz, anstatt anzunehmen, dass die Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Vorfall‑Prozesse, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Erreicht Gradient Descent immer das globale Minimum?
Nein. Für konvexe Ziele bieten geeignete Bedingungen starke Garantien. Ziele von tiefen Netzwerken sind nicht konvex, und praktische Optimierer suchen in der Regel eine brauchbare Lösung, anstatt zu beweisen, dass sie das eindeutige globale Minimum gefunden haben.
Warum kann ein Null‑Gradient irreführend sein?
Ein Null‑ oder sehr kleiner Gradient kann ein Minimum, Maximum, einen Sattelpunkt, Sättigung oder ein flaches Plateau anzeigen. Trainingsdiagnosen müssen die Verlust‑Historie, Krümmung, Parameter‑Skala und die Validierungsleistung berücksichtigen.
Primärreferenzen