
Grundlagen der KI
Was ist Backpropagation?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Backpropagation ist der Algorithmus, der verwendet wird, um zu berechnen, wie sich der Verlust eines neuronalen Netzwerks in Bezug auf seine trainierbaren Parameter ändert. Er wendet die Kettenregel der Analysis rückwärts auf die während eines Vorwärtsdurchlaufs aufgezeichneten Operationen an.
Backpropagation berechnet Gradienten; es entscheidet nicht selbst über die Aktualisierung. Ein Optimierer wie stochastischer Gradientenabstieg oder AdamW verwendet diese Gradienten, um Gewichte, Biases und andere trainierbare Parameter zu verändern.
Wesentliche Erkenntnisse
- Der Vorwärtsdurchlauf erzeugt Zwischenwerte und liefert eine Vorhersage.
- Die Verlustfunktion wandelt die Vorhersage und das Ziel in ein skalare Trainingsziel um.
- Backpropagation nutzt lokale Ableitungen und die Kettenregel, um Parametergradienten effizient zu berechnen.
- Moderne Frameworks implementieren die automatische Differenzierung im Reverse‑Mode über einem Rechengraphen.
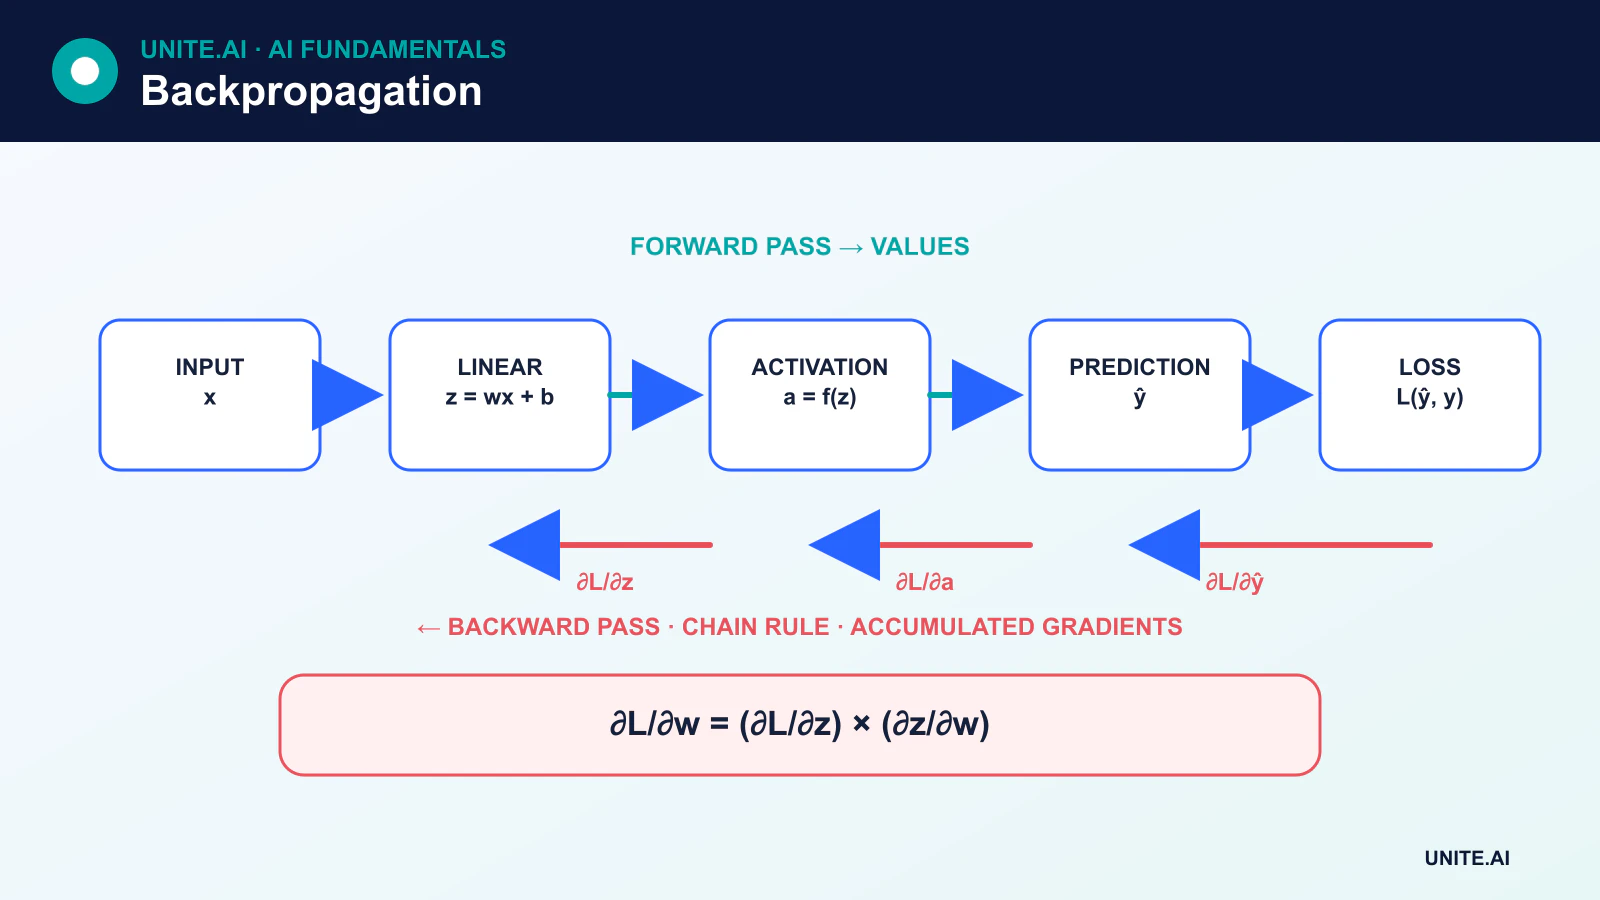
Der Vorwärtsdurchlauf
Betrachten wir eine einfache Einheit:
z = wx + bŷ = activation(z)
Der Input ist x, während w und b trainierbare Gewicht‑ und Bias‑Parameter sind. Biases ändern sich während des Trainings normalerweise genauso wie Gewichte. Ein Netzwerk kombiniert viele solcher Operationen sowie Normalisierung, Attention, Faltungen, Residualverbindungen oder andere differenzierbare Bausteine.
Der Vorwärtsdurchlauf führt diese Operationen aus und erzeugt eine Vorhersage. Ein Verlust wie Kreuzentropie oder mittlere quadratische Abweichung misst das Ziel. Der geeignete Verlust hängt von der Aufgabe und der Interpretation der Ausgabe ab.
Die Kettenregel
Wenn der Verlust L von einem Zwischenwert z abhängt und z von Parameter w abhängt, liefert die Kettenregel:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Ein tiefes Netzwerk enthält viele Pfade. Backpropagation durchläuft den Rechengraphen rückwärts und akkumuliert Beiträge, wenn ein Wert den Verlust über mehr als einen Pfad beeinflusst. Das Ergebnis ist ein Gradient für jeden trainierbaren Parameter, der an der Vorwärtsberechnung beteiligt war.
Ein kleines numerisches Beispiel
Angenommen ŷ = wx + b, mit x = 2, w = 3 und b = 1. Die Vorhersage beträgt 7. Ist das Ziel 5 und der Verlust L = ½(ŷ – y)², dann:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
Der Optimierer kann dann w und b in Richtung des negativen Gradienten verschieben. Diese Formel ist spezifisch für die gewählte lineare Einheit und den quadratischen Fehlerverlust; eine universelle Backpropagation‑Regel ist die Kettenregel über den tatsächlichen Graphen, nicht eine feste „Fehler“-Gleichung.
Backpropagation versus Gradientabstieg
Gradientabstieg ist ein Optimierungsverfahren. Backpropagation liefert die dafür benötigten Gradienten. Ein Trainingsschritt folgt in der Regel:
- Gespeicherte Gradienten löschen oder zurücksetzen.
- Den Vorwärtsdurchlauf ausführen.
- Den Verlust berechnen.
- Den Rückwärtsdurchlauf ausführen.
- Die Optimierer‑Aktualisierung anwenden.
Die Trennung dieser Konzepte erleichtert das Verständnis von Momentum, AdamW, Gradientensammlung und Training mit gemischter Präzision.
Automatische Differenzierung
Frameworks wie PyTorch protokollieren Operationen und bauen während des Vorwärtsdurchlaufs einen Graphen auf. Die automatische Differenzierung im Reverse‑Mode berechnet dann effizient Vektor‑Jacobi‑Produkte von den Ausgaben zurück zu den Parametern. Das ist allgemeiner als das manuelle Codieren von Ableitungen für ein festes Netzwerk und bildet die Grundlage moderner Deep‑Learning‑Frameworks.
Einige Operationen sind nicht differenzierbar oder besitzen instabile Ableitungen. Frameworks definieren in bestimmten Fällen Subgradienten oder dokumentierte Konventionen, doch Anwender müssen dennoch detach‑Tensoren, In‑Place‑Operationen und numerische Präzision verstehen.
Verschwindende und explodierende Gradienten
Wiederholte Multiplikation durch viele Schichten oder Zeitschritte kann Gradienten extrem klein oder groß werden lassen. Verschwindende Gradienten verlangsamen das Lernen in frühen Schichten; explodierende Gradienten destabilisieren Aktualisierungen. ReLU‑artige Aktivierungen, sorgfältige Initialisierung, Residualverbindungen, Normalisierung, gesteuerte Rekurrenz und Gradient‑Clipping helfen, aber keine ist eine universelle Lösung.
Gradienten prüfen
Das Gradient‑Checking mittels finiter Differenzen vergleicht einen analytischen oder automatischen Gradient mit einer numerischen Approximation. Es ist langsam, aber nützlich zum Debuggen benutzerdefinierter Operationen. Das Überwachen von Gradientennormen und das Erkennen von NaN‑ oder unendlichen Werten kann Instabilitäten während des Trainings aufdecken.
Die Kettenregel durch einen Rechengraphen
Backpropagation berechnet effizient die Gradienten eines skalaren Verlusts in Bezug auf jeden differenzierbaren Parameter. Ein Vorwärtsdurchlauf zeichnet Zwischenwerte in einem Rechengraphen auf. Ausgehend vom Verlust wendet die automatische Differenzierung im Reverse‑Mode die Kettenregel an, multipliziert lokale Ableitungen und akkumuliert Beiträge, wo Pfade zusammenlaufen. Für eine Schicht y=f(x,w) kombiniert die upstream‑Sensitivität zu y die partiellen Ableitungen, um Sensitivitäten für x und w zu erzeugen. Backpropagation berechnet die Gradienten; der Optimierer entscheidet, wie sich die Parameter ändern.
Eine einfache affine Schicht erzeugt y=Wx+b. Der Gradient für W ist das äußere Produkt des upstream‑Gradienten und des Inputs, der Gradient für b summiert upstream‑Werte, und der Input‑Gradient wird mit der transponierten Gewichtsmatrix multipliziert. Aktivierungen fügen elementweise Ableitungen hinzu. Faltung, Normalisierung, Attention und rekurrente Wiederverwendung folgen demselben Graphprinzip, erfordern jedoch korrekte Tensorformen, Broadcasting, Maskierung und Parameter‑Sharing. Frameworks geben gespeicherte Aktivierungen nach dem Rückwärtsdurchlauf frei, sofern sie nicht behalten werden, sodass der Speicherverbrauch häufig mit Batch‑Größe, Tiefe und Sequenzlänge wächst.
Gradienten‑Fehler, Verifikation und ingenieurtechnische Praxis
Produkte vieler Ableitungen können verschwinden oder explodieren. ReLU‑artige Aktivierungen, sorgfältige Initialisierung, Normalisierung, Residualverbindungen, Gating und Gradient‑Clipping adressieren unterschiedliche Mechanismen. Sättigte Aktivierungen und nicht differenzierbare Operationen können nützliche Signale blockieren; abgeschnittenes Backpropagation begrenzt die Sequenzhistorie; gemischte Präzision kann ohne Verlust‑Scaling unterlaufen. Explodierende Gradienten sind ein Symptom, daher sollte Clipping von einer Untersuchung der Lernrate, Daten, Architektur und numerischer Fehler begleitet werden, anstatt sie zu verbergen.
Verifizieren Sie benutzerdefinierte Operationen mit Gradient‑Checks mittels finiter Differenzen an kleinen Double‑Precision‑Eingaben, wobei nicht differenzierbare Punkte vermieden werden. Untersuchen Sie Gradientennormen, NaNs, inaktive Parameter und ob die Gradienten die erwarteten Module erreichen. Löschen Sie akkumulierte Gradienten bewusst und unterscheiden Sie das Verhalten von Training und Evaluation bei Dropout und Normalisierung. Checkpointing berechnet Aktivierungen erneut, um Speicher zu sparen; verteiltes Training muss Gradienten konsistent aggregieren. Ein sinkender Trainingsverlust zeigt, dass ein Optimierungspfad existiert, nicht jedoch, dass die Gradienten konzeptionell korrekt, die Daten frei von Lecks oder das Modell generalisiert.
Praktisches Beispiel: Verifizierung einer benutzerdefinierten neuronalen Schicht
Ein Ingenieur implementiert eine differenzierbare spektrale Schicht für ein Audio‑Netzwerk. Ein kleiner Double‑Precision‑Test vergleicht automatische Gradienten mit zentralen finiten Differenzen über Eingaben und Parameter, wobei Punkte ausgeschlossen werden, an denen die Operation bewusst nicht differenzierbar ist. Form, Broadcasting, Padding und die Umwandlung von komplex zu real erhalten separate Fälle. Der Test verifiziert akkumulierte Gradienten, wenn ein Parameter wiederverwendet wird, und bestätigt, dass maskierte Audio‑Frames keinen Gradient erzeugen.
Während des Trainings verfolgen Dashboards Gradient‑ und Aktivierungsnormen, NaNs, inaktive Parameter und Verlust‑Scaling. Ein bewusst korrupter Batch bestätigt, dass die Validierung nicht‑finite Ausgaben vor einer Optimierer‑Aktualisierung erkennt. Gemischte Präzision und exportierte Implementierungen werden mit der Referenz verglichen. Checkpoint‑Fortsetzungstests umfassen den Optimierer‑Zustand und eine zufällige Reihenfolge. Die Schicht wird nicht allein deshalb akzeptiert, weil der Gesamtloss sinkt; Einheits‑Gradienten, numerische Stabilität und nachgelagerte Generalisierung müssen alle konsistente Evidenz liefern.
Implementierungsnachweis und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Verantwortlichen und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluationsdatensatz vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Fehlgebrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout weisen Sie Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabeverhalten, die Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Eingriffe und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion, prüfen Sie dann Evidenz aus der Praxis nach der Bereitstellung, anstatt anzunehmen, dass Offline‑Leistung bestehen bleibt. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lern‑Aus‑Vorfall‑Prozesse, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Aktualisiert Backpropagation die Gewichte?
Backpropagation berechnet Gradienten. Der Optimierer wendet ein Update unter Verwendung dieser Gradienten, seiner Lernrate und ggf. Zuständen wie Momentum oder adaptiven Momenten an.
Ist Backpropagation biologisch realistisch?
Standard‑Backpropagation ist ein ingenieurtechnischer Algorithmus und wird nicht als detailliertes Modell des Lernens in biologischen Gehirnen akzeptiert. Die historische neuronale Analogie sollte nicht als biologische Gleichwertigkeit angesehen werden.
Primärreferenzen












