
Grundlagen der KI
Wie funktioniert Textklassifizierung?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Textklassifizierung weist einem Dokument, einer Nachricht oder einem Textabschnitt ein oder mehrere Labels zu. Beispiele sind Spam‑Erkennung, Intent‑Routing, Sentiment‑Analyse, Themen‑Tagging, Moderation und Priorisierung von Support‑Tickets.
Ein produktiver Klassifikator ist mehr als ein Modell. Er beruht auf einer genauen Label‑Taxonomie, repräsentativen Anmerkungen, lecksicheren Aufteilungen, einer kalibrierten Entscheidungsregel und Überwachung von sich ändernder Sprache und Klassenhäufigkeit.
Wichtige Erkenntnisse
- Definieren Sie Labels und mehrdeutige Fälle, bevor Sie eine Architektur auswählen.
- Einfache Bag‑of‑Words‑Baseline‑Modelle bleiben wertvoll; vortrainierte Encoder fügen Kontext und Transfer‑Learning hinzu.
- Genauigkeit kann schlechte Leistungen bei Minderheitsklassen verbergen, daher sollten klassenbewusste Metriken und Fehlermusteranalysen verwendet werden.
- Wahrscheinlichkeitskalibrierung, Zurückhaltung und menschliche Überprüfung verwandeln Scores in sicherere Entscheidungen.
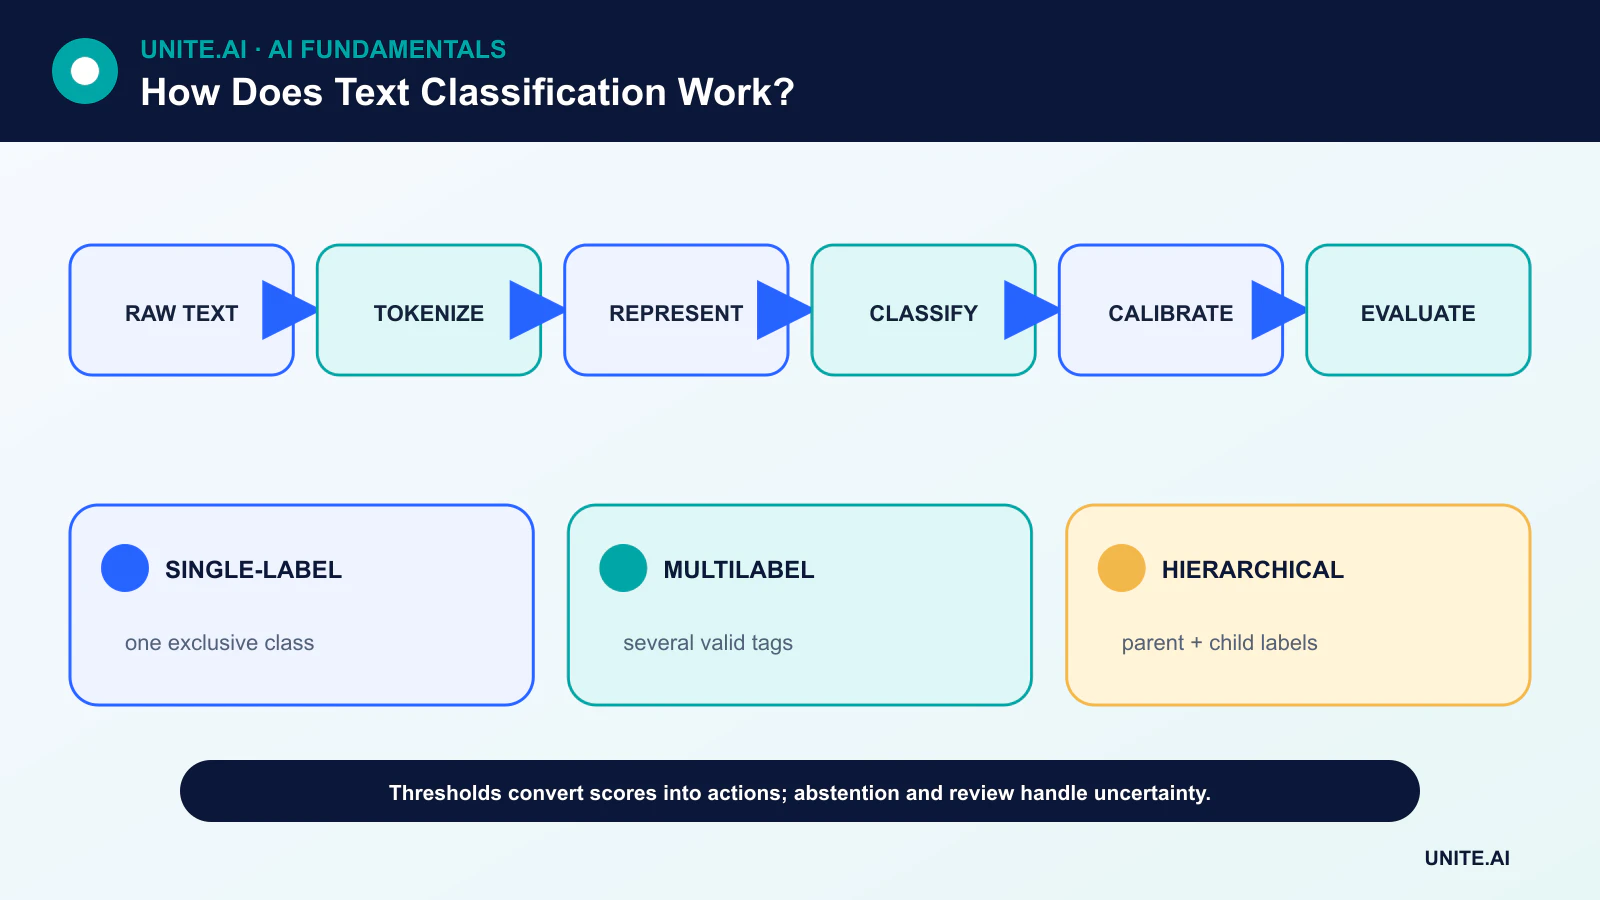
Taxonomie und Annotationsrichtlinie definieren
Eine Single‑Label‑Aufgabe wählt eine gegenseitig ausschließende Klasse. Eine Multi‑Label‑Aufgabe kann mehrere unabhängige Tags zuweisen. Hierarchische Taxonomien enthalten übergeordnete und untergeordnete Labels. Dies sind unterschiedliche Lernprobleme und erfordern verschiedene Ausgaben und Metriken.
Annotatoren benötigen Definitionen, positive und negative Beispiele, Regeln für fehlenden Kontext und einen Eskalationspfad. Übereinstimmungsstatistiken können eine unklare Aufgabe aufdecken, doch Unstimmigkeiten können auch echte Mehrdeutigkeit darstellen, die das System erhalten sollte.
Textrepräsentation
Traditionelle Pipelines verwenden Token‑Zählungen, N‑Gramme und TF‑IDF mit linearen Klassifikatoren oder Support‑Vector‑Machines. Sie trainieren schnell, zeigen einflussreiche Terme und bieten eine solide Basis.
Neuronale Systeme bilden Tokens auf Einbettungen ab. Vorgefertigte Transformer‑Encoder nutzen Attention, um kontextuelle Repräsentationen zu erzeugen, und können mit gelabelten Beispielen feinabgestimmt werden. Prompt‑ oder Zero‑Shot‑Klassifikatoren können den initialen Aufwand für Labeling reduzieren, doch ihre Beschriftungsformulierung, Modellversion und Kalibrierung müssen im jeweiligen Anwendungsbereich evaluiert werden.
Training ohne Datenleck
Der Datensatz wird in Trainings‑, Validierungs‑ und endgültige Testdaten aufgeteilt. Nahe‑Duplikate von Dokumenten, Nachrichten aus derselben Konversation oder Vorlagen aus derselben Quelle sollten im selben Split bleiben. Für zeitabhängige Anwendungen repräsentiert ein chronologischer Split die Bereitstellung besser.
Klassenungleichgewicht kann durch Gewichtung, Resampling, Schwellenwertauswahl oder zusätzliche Daten adressiert werden. Synthetische Beispiele sollten nicht die Überprüfung realer Minderheitsklassen‑Fehlschläge ersetzen und können Artefakte einführen, die das Modell zu leicht lernt.
Metriken und kalibrierte Entscheidungen
Eine Verwirrungsmatrix zeigt, welche Labels verwechselt werden. Präzision misst, wie viele vorhergesagte Positive korrekt sind; Recall misst, wie viele wahre Positive gefunden werden. Makro‑Durchschnitte gewichten Klassen gleich, während Mikro‑Durchschnitte einzelne Beispiele gewichten.
Ein roher Softmax‑Score ist nicht automatisch eine vertrauenswürdige Wahrscheinlichkeit. Kalibrierung vergleicht das Vertrauen mit der beobachteten Richtigkeit. Teams können klassenspezifische Schwellenwerte festlegen, bei geringem Vertrauen zurückhalten und sensible Fälle an einen Prüfer weiterleiten.
Bereitstellung, mehrsprachige Nutzung und Drift
Texte ändern sich mit Produkten, Ereignissen, Slang und adversarialem Verhalten. Das Monitoring sollte Eingabesprache, Länge, Out‑of‑Vocabulary‑Muster, Klassenraten, Vertrauen und verzögerte Ergebnisse verfolgen. Retraining erfordert versionierte Daten und eine Regression‑Suite wichtiger Beispiele.
Mehrsprachige Leistung muss pro Sprache und Dialekt getestet werden. Alles in eine Sprache zu übersetzen kann Sentiment oder Entitäten verändern; ein mehrsprachiger Encoder kann dennoch ungleichmäßig performen, weil sein Pre‑Training und die Labels nicht gleich repräsentativ sind.
Repräsentationen und Klassifikatorfamilien
Textklassifizierung ordnet einem Dokument, Satz oder einer Token‑Sequenz ein oder mehrere Labels zu. Definieren Sie, ob Labels gegenseitig ausschließend, multilabel, hierarchisch, geordnet oder open‑set sind. Traditionelle Pipelines tokenisieren Text, erzeugen Bag‑of‑Words‑ oder TF‑IDF‑Features und trainieren logistische Regression, Naive Bayes oder ein lineares SVM. Neuronale Systeme lernen Einbettungen mittels Convolution, Rekurrenz oder Transformern. Prompt‑basierte Sprachmodelle können ohne aufgabenspezifisches Training klassifizieren, doch Ausgabebeschränkungen, Kosten, Drift und Evidenz müssen weiterhin gegenüber einfacheren Baselines evaluiert werden.
Die Vorverarbeitung hängt von der Repräsentation ab. Kleinschreibung oder das Entfernen von Interpunktion kann Signale für Namen, Sentiment, Code oder Sprache zerstören; Stemming kann unterschiedliche Bedeutungen zusammenführen. Transformer‑Tokenizer arbeiten mit Subwords und haben Längenbeschränkungen, daher ist die Trunkierungsstrategie wichtig. Lange Dokumente können Chunking und Aggregation erfordern. Bewahren Sie den Rohtext und die Transformationsversion und teilen Sie nach Autor, Konversation, Quelle oder Zeit, um zu verhindern, dass Near‑Duplicates und wiederkehrende Vorlagen über Training und Test hinweg gelangen.
Labels, Metriken und Fehlermusteranalyse
Ein Annotationsleitfaden sollte Umfang, Beispiele, mehrdeutige Fälle und eine Option für unbekannt oder Zurückhaltung definieren. Messen Sie die Übereinstimmung und entscheiden Sie über Unstimmigkeiten, anstatt sie durch Mehrheitsabstimmung zu verbergen. Bei unausgeglichenen Klassen ist Genauigkeit unzureichend; berichten Sie Präzision, Recall, F1, Verwirrung, Kalibrierung und schwellenwertspezifische Arbeitsbelastung pro Klasse. Multi‑Label‑Aufgaben benötigen Mikro‑, Makro‑ und Label‑Ebene‑Metriken. Evaluieren Sie Sprachen, Dialekte, Domänen, Nachrichtenlänge und Zeit. Ein zufälliger Split kann die Qualität überschätzen, wenn Vokabular oder Vorlagen driften.
Fehlermusteranalyse sollte Repräsentationsfehler, unzureichenden Kontext, Label‑Mehrdeutigkeit, seltenes Vokabular, Negation, Sarkasmus und irreführende Hinweise trennen. Verwenden Sie kontrafaktische Tests, die Namen, Dialekt‑Marker oder irrelevante Metadaten ändern, während die Bedeutung erhalten bleibt. Untersuchen Sie Fehlermeldungen mit hohem Vertrauen und abgelehnte Fälle. Ein Modell kann lernen, dass ein Kundenkanal oder eine Signatur ein Label vorhersagt, anstatt den Inhalt zu interpretieren. Entfernen Sie Lecks und überarbeiten Sie die Daten, bevor Sie einfach die Modellkapazität erhöhen.
Produktionsdesign
Stellen Sie einen festen Tokenizer und ein Modell mit Schema‑Validierung, Längenbeschränkungen, Batch‑Verarbeitung und einem Fallback für nicht unterstützte Sprachen oder geringes Vertrauen bereit. Überwachen Sie Eingabeverteilung, Label‑Raten, Kalibrierung, Latenz und geprüfte Ergebnisse. Schützen Sie Texte, da sie persönliche, vertrauliche oder adversariale Anweisungen enthalten können. Für automatisierte Moderation, Berechtigung oder Routing bieten Sie Beschwerde‑Möglichkeiten und messen Sie unterschiedliche Fehlerraten. Versionieren Sie Labels und Schwellenwerte gemäß Unternehmensrichtlinien. Textklassifizierung ist nur innerhalb des definierten Label‑Systems und der Datenverteilung zuverlässig; flüssige Modellerklärungen beweisen nicht, dass eine Klassifizierung korrekt ist.
Praktisches Beispiel: Klassifizierung eingehender Support‑Anfragen
Ein Support‑Team definiert gegenseitig ausschließende Routing‑Labels sowie Flags für Dringlichkeit, Mehrsprachigkeit und Unbekannt. Annotatoren versehen anonymisierte Nachrichten mit Anweisungen für gemischte Probleme und messen die Übereinstimmung. Eine TF‑IDF‑Logistik‑Baseline, ein feinabgestimmter Encoder und ein Prompt‑Modell nutzen denselben zeitbasierten Test‑Set. Die Evaluierung berichtet Klassen‑Präzision und Recall, dringende False‑Negatives, Kalibrierung, Schema‑Gültigkeit, Latenz und Kosten, wobei Near‑Duplicate‑Vorlagen gruppiert werden, um Lecks zu vermeiden.
Der bereitgestellte Klassifikator prüft Sprache und Länge, hält bei schwachen Beweisen zurück und lässt Agenten die Routen korrigieren. Prompts und Nachrichten werden als nicht vertrauenswürdig behandelt; der Zugriff auf Werkzeuge fehlt. Das Monitoring verfolgt Label‑Häufigkeit, Vertrauen, Korrekturen, Reaktionszeit und aufkommende Themen. Eine Richtlinien‑ oder Produktänderung aktualisiert die Taxonomie und die Retraining‑Daten durch Review. Das System verbessert die Queue‑Platzierung, aber es schließt niemals Kundenemotionen oder Anspruchshaltungen über die validierten Labels hinaus.
Nachweise zur Implementierung und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluations‑Set vor dem Tuning. Testen Sie gewöhnliche Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungs‑Shift, Ausfall von Abhängigkeiten, Missbrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und jeden Schwellenwert, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Sie die Zuständigkeit für Release, Ausnahmen, Änderungen, Rollback und Stilllegung festlegen. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und verifizieren Sie das Monitoring mit bewusst eingespeisten Fehlern. Operative Telemetrie sollte Eingabequalität, Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse aufzeigen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion und prüfen Sie dann reale Evidenz nach dem Deployment, anstatt anzunehmen, dass Offline‑Leistung bestehen bleibt. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Incident‑Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist Sentiment‑Analyse eine Textklassifizierungsaufgabe?
In der Regel ja, jedoch kann Sentiment multilabel, aspektbasiert oder kontinuierlich sein, anstatt eines einzelnen positiven/neutralen/negativen Labels.
Wann sollte ein Textklassifikator zurückhalten?
Wenn das Vertrauen gering ist, der Text außerhalb des Anwendungsbereichs liegt, notwendiger Kontext fehlt oder die Kosten einer falschen automatischen Aktion die Kosten einer Überprüfung übersteigen.
Primärreferenzen












