
Grundlagen der KI
Wie man einen Chatbot erstellt: Architektur, Daten, Sicherheit und Bewertung

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Ein Chatbot ist eine Anwendung, die eine Nachricht empfängt, ermittelt, was der Nutzer benötigt, und eine Antwort als Text oder Sprache zurückgibt. Moderne Systeme können Regeln, Retrieval, Klassifikatoren, Transformer, Werkzeuge und große Sprachmodelle kombinieren, anstatt sich auf ein einziges Modell zu verlassen.
Einen nützlichen Chatbot zu bauen ist daher ein Produkt‑ und Systemproblem. Die Dialogschicht muss mit vertrauenswürdigem Wissen und Geschäftsaktionen verknüpft werden, während Identität, Berechtigungen, Protokollierung, Bewertung, Fallback und menschliche Eskalation einschränken, was der Bot tun darf.
Wesentliche Erkenntnisse
- Beginnen Sie mit einer engen Nutzeraufgabe und einem messbaren Erfolgskriterium.
- Trennen Sie die Sprachgenerierung von Retrieval, Werkzeugen, Berechtigungen und Geschäftsregeln.
- Testen Sie vollständige Konversationen, einschließlich Mehrdeutigkeit, Unterbrechung, Ablehnung und Wiederherstellung.
- Behandeln Sie Eingabeaufforderungen und Modellausgaben als nicht vertrauenswürdige Daten; überwachen Sie die Produktion und erhalten Sie Eskalationspfade.
Aufgabe definieren, bevor ein Modell gewählt wird
Notieren Sie, wer der Nutzer ist, was er erreichen möchte, auf welche Daten das System zugreifen darf und welche Aktionen Bestätigung benötigen. Ein FAQ‑Bot, ein Bestell‑Status‑Assistent und ein Konten‑Verwaltungs‑Agent haben sehr unterschiedliche Risikoprofile.
Erstellen Sie eine nicht‑KI‑Baseline und ein Akzeptanzset repräsentativer Unterhaltungen. Messen Sie Aufgabenerfüllung, Antwortunterstützung, Latenz, Abbruch, Eskalation und die Kosten schädlicher Fehler. Eine flüssige Demo beweist nicht, dass der Workflow zuverlässig funktioniert.
Schichtenarchitektur verwenden
Eine typische Pipeline umfasst einen Kanaladapter, Sitzungszustand, Eingabevalidierung, Intent‑ oder Routing‑Logik, Retrieval, ein Antwort‑ oder Richtlinienmodell, Werkzeugadapter und Beobachtbarkeit. Retrieval kann Antworten in genehmigten Dokumenten verankern; Werkzeuge führen kontrollierte Aktionen über explizite Schemata aus.
Halten Sie deterministische Prüfungen außerhalb des Sprachmodells. Authentifizierung, Autorisierung, Bestandsgrenzen, Rückerstattungen und irreversible Aktionen sollten durch Anwendungscode erzwungen werden. Prompt‑Engineering kann das Verhalten formen, ist aber kein Zugriffskontrollsystem.
Dialog, Wissen und Wiederherstellung gemeinsam entwerfen
Gute Unterhaltungen gehen mit unvollständigen Anfragen, Korrekturen, mehreren Intents und Verweisen auf frühere Runden um. Speichern Sie nur den für die Aufgabe benötigten Kontext, machen Sie die Aufbewahrung sichtbar und unterscheiden Sie eine Nutzeräußerung von einer vertrauenswürdigen Tatsache, die von einem genehmigten System zurückgegeben wird.
Wenn das Vertrauen oder die Evidenz unzureichend sind, sollte der Bot eine fokussierte Frage stellen, eine sichere Alternative anbieten oder an eine Person mit einer knappen Zusammenfassung weiterleiten. Wiederherstellung ist Teil des Kernerlebnisses – kein Randfall, der nach dem Start hinzugefügt wird.
Das gesamte System bewerten und betreiben
Testen Sie die Qualität von Retrieval, Werkzeugauswahl, Argumentgenauigkeit, Richtlinienkonformität, Prompt‑Injection‑Resistenz, Datenschutzlecks und End‑zu‑End‑Ergebnisse. Führen Sie Red‑Team‑Adversarial‑Inputs durch und prüfen Sie, dass ein bösartiges Dokument Systemanweisungen nicht stillschweigend überschreiben kann.
Versionieren Sie Prompt‑s, Indizes, Modelle, Richtlinien und Werkzeuge. Überprüfen Sie Stichprobenunterhaltungen mit Datenschutzkontrollen, beobachten Sie Drift‑ und Fehlermuster und halten Sie Rollbacks bereit. Diese operative Disziplin verbindet die Chatbot‑Entwicklung mit AIOps und Incident‑Response.
Kernkomponenten von Chatbots im Detail
Die Kanalschicht normalisiert Eingaben aus Web‑Chat, mobilen Apps, Messaging‑Plattformen oder Sprache. Eine Sitzungsschicht ordnet Nachrichten einer authentifizierten oder anonymen Unterhaltung zu, erzwingt das Verfallen und speichert nur den für die Aufgabe notwendigen Zustand. Eingabekontrollen begrenzen Größe und Dateitypen, erkennen unsichere Payloads und entfernen Markup, das nachgelagerte Systeme nicht ausführen sollten.
Ein Router entscheidet dann, ob die Anfrage zu einem deterministischen Ablauf, einer Suche, Generierung oder einer menschlichen Warteschlange gehört. Klassische Intent‑Klassifikatoren bleiben nützlich, wenn das Label‑Set stabil ist; Sprachmodelle sind flexibler, aber schwerer zu kalibrieren. Hybride Router können regulierte oder hochvolumige Aufgaben für getestete Workflows reservieren und ein allgemeines Modell für offene Erklärungen nutzen.
Die Antwortschicht sollte Evidenz und Zustand getrennt tragen. Ein generierter Satz kann einen abgerufenen Abschnitt zitieren, aber die Anwendung muss bewahren, welche Quelle und Version ihn unterstützt hat. Das Gesprächs‑Gedächtnis sollte Nutzerpräferenzen von verifizierten Kontodaten unterscheiden und darf niemals einer früheren Nutzer‑Nachricht neue Berechtigungen verleihen.
Retrieval, Werkzeuge und Transaktionen
Die Qualität von Retrieval beginnt vor der Vektorsuche. Dokumente benötigen Eigentümerschaft, Zugriffslabels, kanonische Versionen, nützliche Abschnitte und Löschdaten. Anfrage‑Umformulierung, Stichwortsuche, Einbettungen, Filter und erneutes Ranking können kombiniert werden. Die Bewertung sollte messen, ob die notwendige Evidenz abgerufen wurde, ob irrelevante Abschnitte ausgeschlossen wurden und ob die Antwort tatsächlich der Evidenz folgt.
Werkzeuge wandeln einen Modellsuggestion in eine typisierte Anfrage an Anwendungscode um. Jedes Werkzeug braucht einen engen Zweck, ein explizites Schema, serverseitige Validierung, Least‑Privilege‑Anmeldedaten, Timeouts, Idempotenz wo möglich und ein klares Ergebnis. Das Modell sollte keine rohen Datenbankabfragen oder beliebige URLs konstruieren, wenn stattdessen ein abgegrenzter Geschäftsprozess bereitgestellt werden kann.
Transaktionen erfordern Bestätigung zum Zeitpunkt der Verpflichtung. Zeigen Sie dem Nutzer die materiellen Felder – Empfänger, Betrag, Adresse, Datum oder Zugriffsänderung – und behandeln Sie ein altes „Ja“ nicht als Genehmigung für eine neue Aktion. Für mehrstufige Arbeiten halten Sie eine Zustandsmaschine außerhalb des Modells, sodass ein Wiederholungs‑ oder umsortierter Nachricht nicht ein erforderliches Gate überspringen kann.
Ein praktischer Aufbau‑ und Bewertungsplan
Beginnen Sie mit zwanzig bis fünfzig repräsentativen Aufgaben und schließen Sie erfolglose, mehrdeutige und außerhalb des Umfangs liegende Anfragen ein. Markieren Sie die erwartete Aktion, Evidenz, Eskalation und verbotene Verhaltensweisen. Implementieren Sie den einfachsten funktionsfähigen Ablauf und fügen Sie Retrieval oder Generierung nur dort hinzu, wo sie ein gemessenes Ergebnis verbessert. Das erzeugt eine wiederverwendbare Regression‑Suite, bevor die Oberfläche kompliziert wird.
Bewerten Sie Komponenten und Unterhaltungen separat. Retrieval‑Metriken, Werkzeug‑Aufruf‑Genauigkeit, Richtlinienprüfungen und Antwortunterstützung diagnostizieren spezifische Fehler; Aufgabenerfüllung und Nutzeraufwand zeigen die Qualität auf Systemebene. Verwenden Sie Mehr‑Turn‑Tests, die frühere Details korrigieren, einen Ablauf unterbrechen, das Thema wechseln, erforderliche Informationen zurückhalten und Abhängigkeitsfehler auslösen.
Der Produktions‑Rollout sollte nach Nutzergruppe, Aufgabe und Berechtigung gestaffelt werden. Überwachen Sie nicht unterstützte Behauptungen, wiederholte Klarstellungen, Werkzeugablehnungen, Eskalationen, Latenz und Abbrüche. Prüfen Sie datenschutz‑sichere Stichproben, halten Sie für jedes Werkzeug einen Not‑Deaktivierungspfad bereit und nutzen Sie Erkenntnisse aus Vorfällen, um Prompt‑s, Daten, Code und den Testsatz gemeinsam zu aktualisieren.
Praxisbeispiel: ein Support‑Chatbot von Prototyp bis Produktion
Angenommen, ein Einzelhändler möchte einen Chatbot, der Fragen zu Bestellungen und Rücksendungen beantwortet. Definieren Sie unterstützte Intents, Eskalationsbedingungen, genehmigtes Wissen, Authentifizierungsregeln und verbotene Aktionen zuerst. Erstellen Sie ein Testset aus anonymisierten historischen Fragen, einschließlich vager Anfragen, Rechtschreibfehler, mehrsprachiger Eingaben, verärgerten Nutzern, Prompt‑Injection und Fragen ohne Antwort. Eine Retrieval‑Baseline sollte Evidenz liefern, bevor irgendeine generative Antwort behaupten darf, dass sie Richtlinien- oder Bestellstatus wiedergibt.
Die Laufzeit kann Intent klassifizieren, Richtlinienabschnitte abrufen, Identitätsprüfung nur anfordern, wenn Kontodaten benötigt werden, einen eng begrenzten Bestell‑API‑Aufruf tätigen, eine Antwort formulieren und Zitate anhängen. Jeder Werkzeugaufruf benötigt ein explizites Schema, Autorisierungsprüfung, Timeout, Wiederholungs‑Richtlinie und Idempotenz‑Schlüssel. Das Modell sollte niemals rohe Datenbankabfragen konstruieren oder eigene Berechtigungen entscheiden. Aktionen mit hoher Auswirkung wie Stornierung oder Rückerstattung erfordern Bestätigung und, über definierte Grenzen hinaus, menschliche Genehmigung.
Bewerten Sie Intent‑Genauigkeit, Antwortkorrektheit, Evidenzunterstützung, Ablehnungsqualität, erfolgreiche Eindämmung, Eskalationspräzision, Latenz und Kosten pro gelöster Konversation. Prüfen Sie Ergebnisse nach Intent und Nutzergruppe statt nach einem Durchschnitt. In der Produktion protokollieren Sie zustimmungs‑bewusste Spuren, Werkzeug‑Ergebnisse, abgerufene Dokumentversionen und Nutzerkorrekturen. Rollen Sie schrittweise aus, vergleichen Sie mit dem bestehenden Kanal und deaktivieren Sie Funktionen, wenn Fehler‑, Missbrauchs‑ oder Abhängigkeits‑Schwellenwerte überschritten werden.
Praktische Implementierungs‑Checkliste
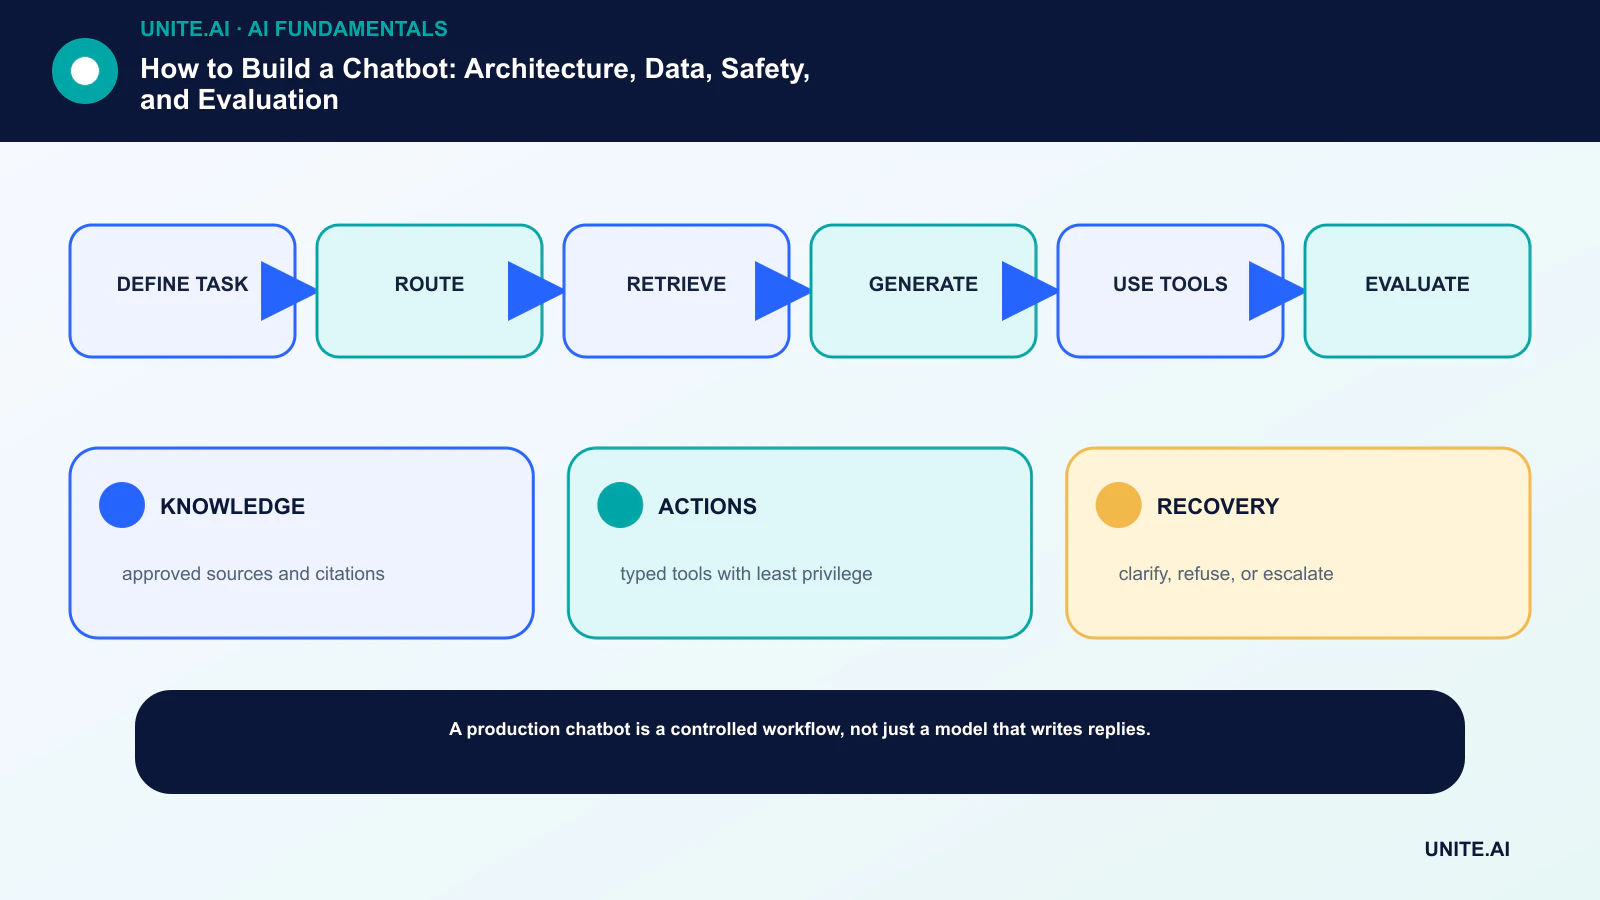
Verwandeln Sie das Konzept in einen begrenzten, testbaren Workflow: Aufgabe → Routing → Retrieval → Generierung → Werkzeuge nutzen → Bewertung. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, setzen Sie Akzeptanz‑ und Stopp‑Kriterien, testen Sie repräsentative Fehlerszenarien und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Dokumentieren Sie Versionen und Annahmen, sodass ein anderes Team das Ergebnis reproduzieren und verstehen kann, was sich geändert hat.
Vor dem Start führen Sie ein dokumentiertes Readiness‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Grenzbedingungen, Abhängigkeitsfehler und Missbrauch; bewahren Sie Evidenz und ungelöste Risiken. Definieren Sie, wer die Veröffentlichung freigeben, Schwellenwerte ändern, eine Ausgabe überschreiben oder den Betrieb stoppen kann. Überarbeiten Sie die Entscheidung, wenn reale Daten eintreffen, da ein technisch erfolgreicher Pilot keine zuverlässige Leistung im größeren Maßstab garantiert.
- WISSEN: genehmigte Quellen und Zitate.
- AKTIONEN: typisierte Werkzeuge mit minimalen Rechten.
- WIEDERHERSTELLUNG: klären, ablehnen oder eskalieren.
Häufig gestellte Fragen
Benötigt ein Chatbot ein großes Sprachmodell?
Nein. Regeln, Suche, Formulare und kleine Klassifikatoren können für enge Aufgaben sicherer und kostengünstiger sein. Ein LLM ist nützlich, wenn flexibles Sprachverständnis oder -generierung einen messbaren Mehrwert liefert.
Was sollte vor dem Start getestet werden?
Repräsentative Aufgaben, nicht unterstützte Anfragen, mehrdeutige Formulierungen, Werkzeugfehler, Datenschutzgrenzen, adversariale Prompt‑s, menschliche Übergabe, Latenz und die Genauigkeit jeder folgebezogenen Aktion.
Primärreferenzen












