
Grundlagen der KI
Was ist Sentiment-Analyse? Methoden, Verwendungen und Einschränkungen

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Sentiment‑Analyse schätzt bewertende Sprache in Texten, Transkripten von Sprache oder anderem Inhalt. Ein System kann die Polarität (z. B. positiv, negativ oder neutral) klassifizieren; Meinungen auf Aspekt‑Ebene erkennen; Intensität abschätzen; oder die Haltung zu einer bestimmten Behauptung identifizieren.
Das Ziel muss sorgfältig definiert werden. Sentiment ist nicht dasselbe wie Emotion, Absicht, Toxizität, Zufriedenheit oder Wahrheit. Ein positiver Satz kann ein schädliches Ereignis sarkastisch beschreiben, während eine negative Produktbewertung das Produkt insgesamt dennoch empfehlen kann.
Wesentliche Erkenntnisse
- Definieren Sie Einheit, Ziel, Labels und Kontext, bevor Sie Beispiele sammeln.
- Lexika sind transparente Baselines; überwachte und Transformer‑Modelle können mehr Kontext erfassen, benötigen jedoch repräsentative Daten.
- Negation, Sarkasmus, domänenspezifischer Wortschatz, mehrsprachiger Text und Aspekt‑Grenzen bleiben schwierig.
- Bewerten Sie pro Klasse, Untergruppe, Domäne und Zeitraum; schließen Sie bei folgenreichen Anwendungen eine menschliche Überprüfung ein.
Ebenen und Ziele
Die Analyse auf Dokumentenebene erzeugt ein Label für das gesamte Element. Die Analyse auf Satzebene trennt einzelne Aussagen, während die aspektbasierte Analyse Sentiment mit einer Entität oder einem Attribut verknüpft – zum Beispiel positiv zur Bildqualität, aber negativ zur Akkulaufzeit.
Stance fragt, ob ein Sprecher eine bestimmte Aussage unterstützt, was sich vom emotionalen Ton unterscheiden kann. Diese Unterscheidungen sollten im Annotationsleitfaden festgelegt werden, bevor Textklassifikations‑Methoden angewendet werden.
Lexika, klassische Modelle und Transformer
Ein Lexikon weist Wörtern Punktzahlen zu und kombiniert sie mit Regeln für Negation oder Intensität. Es ist interpretierbar und kostengünstig, hat jedoch Schwierigkeiten mit Kontext. Klassische, überwachte Modelle nutzen Wort‑ oder n‑Gram‑Merkmale, während Transformer kontextuelle Repräsentationen lernen und feinabgestimmt werden können.
Few‑Shot‑Prompting kann praktisch sein, aber die Ausgaben hängen von Beispielen und Formulierungen ab. Vergleichen Sie jede komplexe Vorgehensweise mit einer Baseline und verwenden Sie Few‑Shot‑Learning nur mit einem zurückgehaltenen, versionierten Evaluations‑Set.
Daten‑ und Sprachherausforderungen
Labels können die Perspektive der Annotatoren widerspiegeln und nicht eine objektive Tatsache darstellen. Der Domänenshift ist stark: „unvorhersehbar“ kann Lob für einen Film und Kritik für ein Fahrzeug sein. Code‑Switching, Dialekte, Emojis, zitierte Rede und Ironie erschweren tokenbasierte Signale.
Klassen sollten bewusst ausbalanciert werden, und verwandte Autoren, Produkte oder Konversationen dürfen nicht zwischen Trainings‑ und Testdaten auslecken. Ein Modell, das sich eine Marke oder einen Sprecher merkt, kann genau erscheinen, ohne Sentiment zu lernen.
Evaluierung und verantwortungsbewusste Nutzung
Berichten Sie über Präzision, Recall, F1‑Score und eine Verwirrungsmatrix statt nur über die Genauigkeit. Analysieren Sie Fehler nach Aspekt, Länge, Dialekt und Zeit und kalibrieren Sie Schwellenwerte hinsichtlich der operativen Kosten jedes Fehlers.
Aggregierte Trends können Forschung oder Triage unterstützen, doch das Schließen auf den Zustand einer einzelnen Person oder Entscheidungen in den Bereichen Beschäftigung, Kredit, Gesundheit oder Strafverfolgung birgt ein höheres Risiko. Stellen Sie Unsicherheit, Kontextquellen, Datenschutz‑Kontrollen und eine menschliche Überprüfung bereit.
Annotation und Datensatzkonstruktion
Erstellen Sie einen Annotationsleitfaden mit Ziel‑Entität, Analyseeinheit, Label‑Definitionen, Umgang mit gemischten und neutralen Fällen, Zitat‑Regeln, Sarkasmus‑Richtlinie und Beispielen aus der Domäne. Pilotieren Sie mit mehreren Annotatoren, berechnen Sie die Übereinstimmung, diskutieren Sie Differenzen und überarbeiten Sie die Aufgabe, bevor Sie die Labels skalieren.
Die Stichprobenwahl bestimmt, was das Modell lernt. Ein Social‑Media‑Stream kann stark aktive Konten überrepräsentieren; Support‑Tickets können zufriedene Kunden auslassen; Sternbewertungen stimmen möglicherweise nicht mit dem Rezensionstext überein. Bewahren Sie Quell‑ und Zeit‑Metadaten, respektieren Sie Plattform‑Bedingungen und Datenschutz und erstellen Sie ein Testset aus der Population, in der Entscheidungen getroffen werden.
Label‑Leakage kann durch Bewertungen, von dem Erfassungssystem eingefügte Emojis, vorgefertigte Signaturen oder Produktnamen, die mit Sentiment korrelieren, auftreten. Entfernen Sie nahezu identische Beiträge und gruppieren Sie Konversationen oder Autoren, sodass deren Sprache nicht auf beiden Seiten einer Aufteilung erscheint.
Modellierungsentscheidungen und Kalibrierung
Lexikon‑Systeme summieren Wortwerte und passen sie bei Negation, Verstärkern, Interpunktion oder Emojis an. Sie bieten einen nützlichen Plausibilitäts‑Check und können mit domänenspezifischen Begriffen angepasst werden. Lineare Modelle mit TF‑IDF‑Merkmalen bleiben bei manchen Datensätzen konkurrenzfähig und zeigen einflussreiche n‑Gramme.
Kontextuelle Encoder repräsentieren Wörter anhand des umgebenden Textes und können für Polarität oder Aspekte feinabgestimmt werden. Lange Dokumente benötigen möglicherweise hierarchische Modelle, Satz‑Aggregation oder das Abrufen relevanter Textabschnitte. Mehrsprachige Ansätze können ein gemeinsames Modell trainieren, in eine Pivot‑Sprache übersetzen oder lokale Modelle pflegen; jeder Ansatz hat Abdeckungs‑ und kulturelle Kompromisse.
Die Wahrscheinlichkeits‑Kalibrierung ist wichtig, wenn Scores Aktionen auslösen. Zuverlässigkeits‑Plots und der erwartete Kalibrierungsfehler zeigen, ob ein gemeldetes Vertrauen von 0,8 etwa 80 % Korrektheit entspricht. Schwellenwerte können ein Abstinenz‑Band für menschliche Überprüfung erzeugen, und separate Schwellen können gerechtfertigt sein, wenn Fehlkosten variieren – nicht, um ungleiche Qualität zu verbergen.
Anwendungen und häufige Fehlinterpretationen
Aggregiertes Sentiment kann helfen, Themen zu priorisieren, Kampagnenreaktionen zu vergleichen oder dringende Service‑Nachrichten zu leiten. Aspekt‑Analysen sind oft handlungsfähiger als die Gesamtpolarität, da sie aufzeigen, worüber Menschen sprechen. Trendanalysen benötigen stabile Stichproben und konsistente Label‑Definitionen über die Zeit.
Verwechseln Sie nicht die Häufigkeit negativer Beiträge mit der Meinung der Gesamtbevölkerung. Posting‑Verhalten, Bots, Moderation, Plattform‑Demografie, Kampagnen und Abfrage‑Parameter bestimmen die Stichprobe. Ein Sentiment‑Modell misst nicht die stille Bevölkerung, und eine Wortänderung kann wie ein Einstellungswechsel erscheinen.
Bei individuellen Entscheidungen können falsche Labels stigmatisierend und schwer anzufechten sein. Vermeiden Sie die Verwendung von Sentiment als Proxy für Mitarbeiter‑Engagement, psychische Gesundheit, Kreditwürdigkeit, Absicht oder Täuschung. Wenn Personen betroffen sind, zeigen Sie den Quell‑Kontext, ermöglichen Sie Korrekturen und verlangen Sie einen menschlichen Entscheidungsträger mit echter Entscheidungsfreiheit.
Praktisches Beispiel: Sentiment‑Analyse für Kundenfeedback
Ein Unternehmen, das Support‑Kommentare analysiert, sollte festlegen, ob es Dokument‑Sentiment, Aspekt‑Sentiment, Emotion, Dringlichkeit oder Issue‑Klassifikation benötigt. „Die Lieferung war schnell, aber das Produkt ging kaputt“ kann nicht treu durch ein einziges positiv‑oder‑negativ‑Label abgebildet werden. Erstellen Sie einen Annotationsleitfaden für Ziele, Negation, Sarkasmus, gemischte Aussagen, zitierte Rede und unbekannte Fälle und messen Sie die Übereinstimmung, bevor Sie die Labels als Ground‑Truth behandeln.
Vergleichen Sie ein Lexikon‑ oder lineares Basismodell mit einem feinabgestimmten Encoder oder einem prompt‑basierten Sprachmodell. Teilen Sie die Daten nach Zeit oder Kunde, um nahe‑duplizierte Leckagen zu verhindern, und bewahren Sie die Klassenhäufigkeit. Berichten Sie Präzision, Recall, F1, Kalibrierung und Verwirrung nach Sprache, Kanal, Produkt und demografischen Proxy‑Variablen, jedoch nur dort, wo es rechtlich zulässig und gerechtfertigt ist. Überprüfen Sie Fehler mit hoher Sicherheit, da sie im automatisierten Routing gefährlicher sind als unsichere Ausgaben, die eskaliert werden.
Verwenden Sie Sentiment als ein Signal für Aggregation oder Priorisierung, nicht als unbestreitbares Maß für den Zustand einer Person. Überwachen Sie Wortschatz‑ und Produkt‑Drift, trainieren Sie mit überprüften Beispielen neu und ermöglichen Sie Agenten, Labels zu korrigieren. Leiten Sie niemals geschützte Merkmale ab oder bestrafen Sie Mitarbeitende anhand unvalidierter Sentiment‑Scores. Für Management‑Berichte zeigen Sie Stichprobengröße, Unsicherheit, fehlende Daten und die Themen, die Veränderungen antreiben, sodass ein schwankender Score zu einer Untersuchung führt und nicht zu einer simplen Schlussfolgerung.
Mehrsprachige Bereitstellungen sollten nicht davon ausgehen, dass die Übersetzung von Eingaben Ton, Negation, Redewendungen oder kulturelle Konventionen bewahrt. Validieren Sie jede unterstützte Sprache und gemischte Sprachmuster mit muttersprachlichen Prüfern und geben Sie ein „unbekannt“-Ergebnis aus, wenn die Evidenz schwach ist. Domänen‑Adaption ist ebenfalls wichtig: Wörter, die im normalen Gespräch negativ klingen, können neutrale technische Beschreibungen sein. Pflegen Sie separate Schwellenwerte oder Modelle nur dann, wenn betriebliche Evidenz die zusätzliche Komplexität und Governance‑Aufwand rechtfertigt.
Praktische Checkliste zur Implementierung
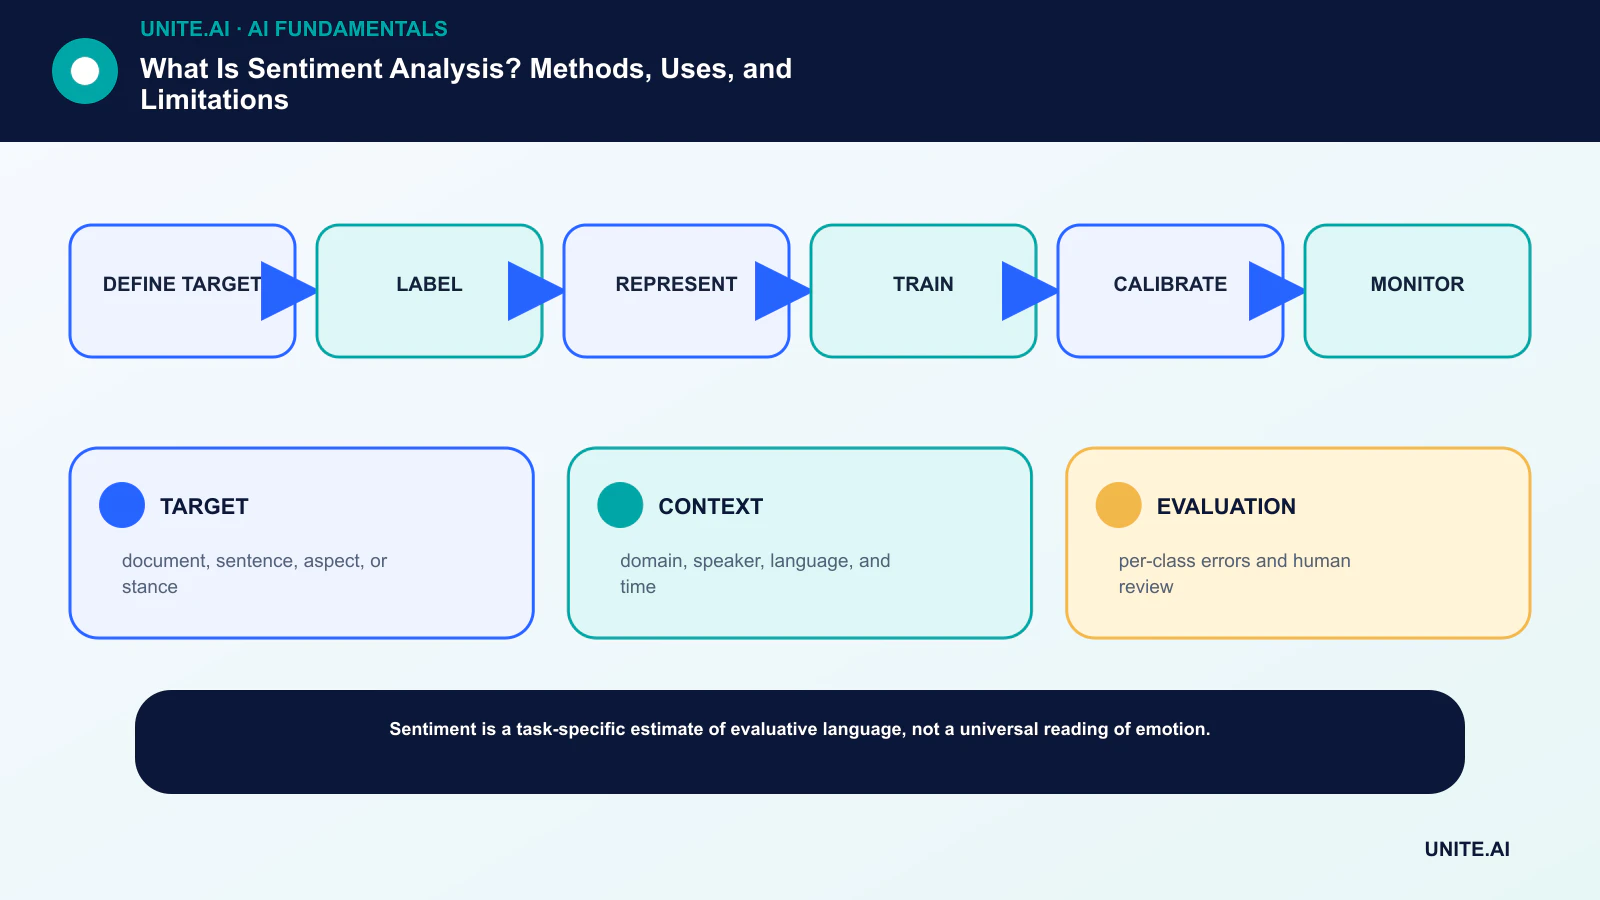
Verwandeln Sie das Konzept in einen abgegrenzten, testbaren Workflow: Ziel → Label → Repräsentation → Training → Kalibrierung → Monitoring definieren. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie Daten und Abhängigkeiten, etablieren Sie eine einfache Baseline, setzen Sie Akzeptanz‑ und Abbruchkriterien, testen Sie repräsentative Fehlerszenarien und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Bereitschafts‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Randbedingungen, Ausfälle von Abhängigkeiten und Missbrauch; bewahren Sie die Beweise und offenen Risiken. Definieren Sie, wer die Freigabe genehmigen, einen Schwellenwert ändern, ein Ergebnis überschreiben oder den Betrieb stoppen darf. Überprüfen Sie die Entscheidung erneut, sobald Real‑World‑Daten vorliegen, da ein technisch erfolgreicher Pilot nicht automatisch eine zuverlässige Leistung im größeren Maßstab garantiert.
- TARGET: Dokument, Satz, Aspekt oder Haltung.
- CONTEXT: Domäne, Sprecher, Sprache und Zeit.
- EVALUATION: Klassenbezogene Fehler und menschliche Überprüfung.
Häufig gestellte Fragen
Ist Sentiment‑Analyse objektiv?
Nein. Sie schätzt Labels, die durch eine Aufgabe und den Annotationsprozess definiert werden. Einige Texte sind tatsächlich mehrdeutig, gemischt, kontextabhängig oder werden von Lesern unterschiedlich interpretiert.
Kann Sentiment‑Analyse Sarkasmus erkennen?
Modelle können einige Muster erlernen, doch Sarkasmus hängt häufig von der Geschichte des Sprechers, gemeinsamem Wissen und Kontext außerhalb des Textes ab. Er bleibt ein häufiges Versagensszenario.
Primärreferenzen












