Grundlagen der KI
Was ist der Satz von Bayes?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Bayesscher Satz beschreibt, wie die Wahrscheinlichkeit einer Hypothese nach Beobachtung von Evidenz aktualisiert wird. Er verbindet die Wahrscheinlichkeit der Evidenz unter der Annahme einer Hypothese mit der Wahrscheinlichkeit der Hypothese, gegeben diese Evidenz.
Diese Unterscheidung ist zentral für statistisches Denken und Maschinelles Lernen. Ein Test kann sehr genau sein, wenn eine Erkrankung vorliegt, während ein positives Ergebnis dennoch nur eine geringe Wahrscheinlichkeit hat, die Erkrankung anzuzeigen, wenn diese selten ist.
Wesentliche Erkenntnisse
- Die Posterior-Verteilung kombiniert einen a priori Glauben mit der Likelihood der beobachteten Evidenz.
- Der Evidenzterm normalisiert die möglichen Hypothesen.
- Grundraten können scheinbar starke Evidenz überwiegen.
- Naive Bayes nimmt an, dass Merkmale bedingt unabhängig sind, gegeben die Klasse, nicht in jeder Situation unabhängig.
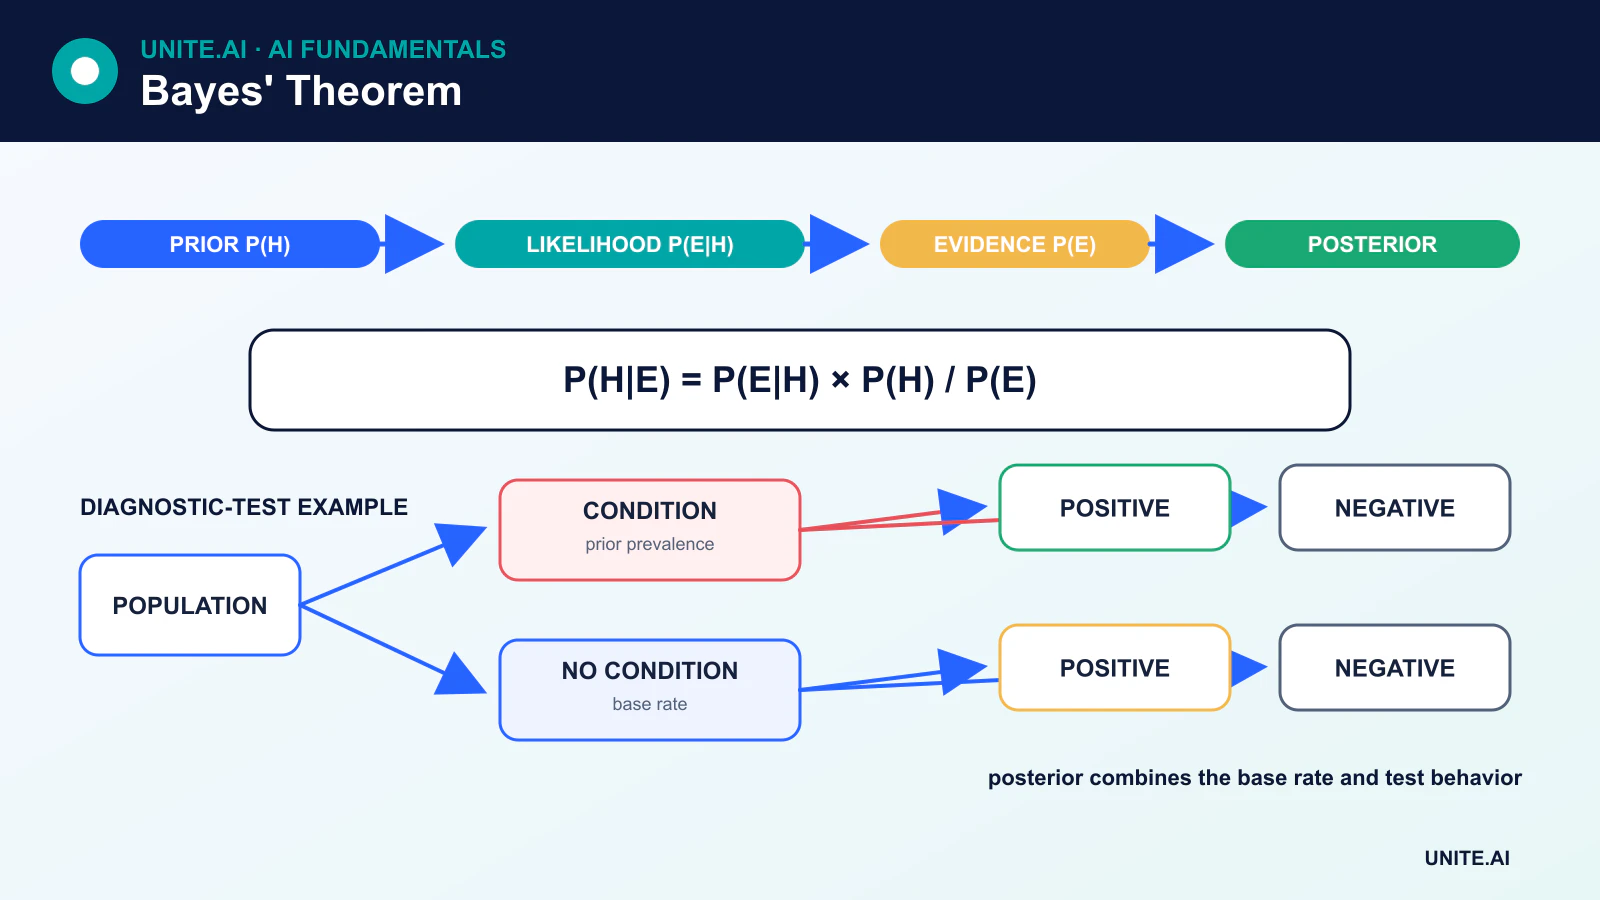
Die Formel
P(A|B) = P(B|A)P(A) / P(B)
- P(A) ist die a priori Wahrscheinlichkeit der Hypothese A.
- P(B|A) ist die Likelihood, Evidenz B zu beobachten, falls A wahr ist.
- P(B) ist die Gesamtevidenzwahrscheinlichkeit.
- P(A|B) ist die Posterior-Wahrscheinlichkeit von A nach Beobachtung von B.
Der Satz folgt aus zwei äquivalenten Ausdrücken für die gemeinsame Wahrscheinlichkeit: P(A ∩ B) = P(B|A)P(A) und P(A ∩ B) = P(A|B)P(B).
Ein numerisches Grundraten-Beispiel
Angenommen, eine Erkrankung betrifft 1 % einer Population. Ein Test hat 90 % Sensitivität und eine 5 %ige Fehlalarmrate. Betrachte 1.000 Personen:
- Etwa 10 haben die Erkrankung; der Test erkennt korrekt 9.
- Etwa 990 nicht; eine 5‑%ige Fehlalarmrate markiert etwa 50.
- Damit gibt es etwa 59 positive Ergebnisse, von denen 9 wahre Positive sind.
Die Wahrscheinlichkeit der Erkrankung nach einem positiven Ergebnis beträgt etwa 9 / 59 ≈ 15 %, nicht 90 %. Die Sensitivität des Tests beantwortet P(positiv | Erkrankung); der Nutzer will in der Regel P(Erkrankung | positiv). Der Bayessche Satz verbindet sie mittels der Grundrate.
Bayessches Updating
Wenn neue Evidenz eintrifft, kann ein Posterior zur Prior für das nächste Update werden. Ein vollständiges Bayessches Modell spezifiziert mögliche Hypothesen, Prior-Verteilungen, eine Likelihood und die zu inferierende Größe. Unsicherheit wird durch eine Posterior-Verteilung dargestellt, nicht nur durch einen Punktschätzer.
Die Prior sollte dokumentiert und auf Sensitivität getestet werden. Eine schwach informative Prior kann unplausible Werte regularisieren, während eine schlecht gewählte starke Prior begrenzte Daten dominieren kann.
Naive‑Bayes‑Klassifikatoren
Naive Bayes sagt eine Klasse y aus Merkmalen x₁ … xₙ mittels Bayesschem Satz und der Annahme voraus:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Es wird angenommen, dass die Merkmale bedingt unabhängig sind, sobald die Klasse bekannt ist. Dies ist oft unrealistisch, doch der Klassifikator kann gut funktionieren, wenn die resultierenden Klassenscores dennoch nützlich sind.
Übliche Varianten
- Multinomial Naive Bayes modelliert zählähnliche Merkmale und ist üblich in der Dokumentklassifikation.
- Bernoulli Naive Bayes modelliert das Vorhandensein binärer Merkmale.
- Gaussian Naive Bayes modelliert jedes kontinuierliche Merkmal mit einer klassenbedingten Gaußschen Verteilung.
- Categorical Naive Bayes modelliert diskrete Kategorien.
Glättung und numerische Stabilität
Wenn ein Merkmalwert in der Schulung nie mit einer Klasse auftritt, kann eine unsmoothe Wahrscheinlichkeitsschätzung Null werden und das gesamte Produkt eliminieren. Additive oder Laplace‑artige Glättung verhindert das. Implementierungen berechnen Log‑Wahrscheinlichkeiten, sodass das Multiplizieren vieler kleiner Werte zum Addieren stabiler Log‑Werte wird.
Wahrscheinlichkeiten, Scores und Kalibrierung
Die Wahrscheinlichkeitsausgaben von Naive Bayes können schlecht kalibriert sein, weil korrelierte Merkmale effektiv mehrfach gezählt werden. Ein Klassifikator kann Klassen gut ranken, dabei jedoch das Vertrauen überbewerten. Die Kalibrierung sollte anhand von Hold‑out‑Daten evaluiert werden, wenn Wahrscheinlichkeiten Entscheidungen steuern.
Bayes jenseits von Naive Bayes
Bayessche Inferenz unterstützt hierarchische Modelle, A/B‑Tests, wissenschaftliche Parameterschätzungen, Prognosen, unsicherheitsbewusste Entscheidungsfindung und probabilistische graphische Modelle. Approximationen wie Markov‑Ketten‑Monte‑Carlo und Variationsinferenz werden eingesetzt, wenn ein Posterior nicht in geschlossener Form berechnet werden kann.
Häufige Denkfehler
- Verwechseln von
P(A|B)mitP(B|A). - Ignorieren einer seltenen oder häufigen Grundrate.
- Eine Prior als objektiv behandeln oder sie undokumentiert lassen.
- Annehmen, dass eine hohe Likelihood automatisch einen hohen Posterior impliziert.
- Eine prädiktive Assoziation als Kausalität interpretieren.
Bedingte Wahrscheinlichkeit, Quoten und Evidenz
Der Bayessche Satz verknüpft die Wahrscheinlichkeit einer Hypothese nach Evidenz mit ihrer a priori Wahrscheinlichkeit, der Likelihood, diese Evidenz unter der Hypothese zu beobachten, und der Gesamtevidenzwahrscheinlichkeit. In Quotenform entsprechen die Posterior‑Quoten den Prior‑Quoten multipliziert mit einem Likelihood‑Verhältnis. Dies trennt, was vor einem Test geglaubt wurde, von der Stärke, mit der der Test Hypothesen unterscheidet. Ein scheinbar hochpräziser Test kann dennoch viele Fehlalarme erzeugen, wenn die Erkrankung selten ist, weil die Grundrate in den Posterior einfließt.
Die Likelihood ist eine Funktion der Hypothese für fest beobachtete Daten und darf nicht mit der Wahrscheinlichkeit der Hypothese verwechselt werden. Die Evidenznormalisierung summiert oder integriert über konkurrierende Hypothesen. Annahmen bedingter Unabhängigkeit können die Berechnung vereinfachen, wie beim Naive Bayes, müssen jedoch hinsichtlich ihrer Konsequenzen geprüft werden. Mehrere Evidenzstücke können nicht als unabhängig multipliziert werden, wenn sie gemeinsame Ursachen haben oder Informationen duplizieren. Auch die kausale Richtung ist wichtig: P(Evidenz|Hypothese) ist im Allgemeinen nicht P(Hypothese|Evidenz), der klassische Fehler der inversen Wahrscheinlichkeit.
Modellierungsentscheidungen, Berechnung und Entscheidungsnutzung
Die Bayessche Analyse spezifiziert eine Prior, eine Likelihood und eine posterior‑prädiktive Verteilung. Priors können etabliertes Wissen kodieren, kleine Stichproben regularisieren oder schwach informativ sein; sie sollten begründet und mittels Sensitivitätsanalyse getestet werden. Konjugierte Modelle liefern analytische Updates, während Markov‑Ketten‑Monte‑Carlo, Variationsinferenz und sequentielle Methoden komplexe Posterioren approximieren. Diagnose von Konvergenz, effektiver Stichprobengröße, Approximationsfehler und Plausibilität der Prior‑Prädiktion sollte erfolgen, anstatt eine Posterior‑Zahl ohne Rechenprüfungen zu berichten.
Eine Posterior‑Wahrscheinlichkeit informiert, wählt jedoch nicht allein eine Handlung. Entscheidungen erfordern Verluste, Nutzen, Einschränkungen und verfügbare Alternativen. Evaluieren Sie probabilistische Modelle mit Kalibrierung, geeigneten Scoring‑Regeln und posterior‑prädiktiven Checks an neuen Daten. Aktualisieren Sie nur mit Evidenz, die unter einem modellierten Prozess gesammelt wurde; Selektionsbias und Datensatzverschiebungen können die Likelihood ungültig machen. Kommunizieren Sie glaubwürdige Intervalle und Annahmen, ohne sie als garantierte Häufigkeitsbereiche darzustellen. Der Bayessche Satz ist exakte Wahrscheinlichkeitsalgebra, während die Qualität einer Bayesschen Schlussfolgerung vom Modell und den bereitgestellten Evidenzen abhängt.
Praktisches Beispiel: Interpretation eines diagnostischen Tests
Ein Test hat 95 % Sensitivität und 90 % Spezifität, aber die Erkrankung betrifft nur 1 % der gescreenten Bevölkerung. Für 10.000 Personen werden etwa 95 wahre Positive und 990 falsche Positive erwartet, was einen positiven Vorhersagewert von unter 9 % ergibt. Der Bayessche Satz macht den Grundraten‑Effekt explizit. Die Berechnung gibt Bevölkerung, Testschwelle und Unsicherheit an, anstatt die Sensitivität als die Chance zu bewerben, dass ein positives Ergebnis korrekt ist. Diese Unterscheidung ist ebenfalls grundlegend für sorgfältige Datenwissenschaft.
Kliniker aktualisieren die Wahrscheinlichkeit mit zusätzlicher Evidenz nur, wenn die Abhängigkeit zwischen Tests modelliert wird. Ein Entscheidungsschwellenwert berücksichtigt den Schaden durch übersehene Erkrankungen, das Risiko von Bestätigungstests, Kosten und Patientenpräferenzen. Die Kalibrierung wird in der lokalen Bevölkerung geprüft, und Prävalenzänderungen lösen eine Überprüfung aus. Der Posterior unterstützt Diskussion und nächste Schritte; er ersetzt nicht die bestätigende Diagnose. Die Berichterstattung verwendet natürliche Frequenzen und Sensitivitätsanalysen, sodass Patienten und Praktiker sehen können, wie sich das Ergebnis unter plausiblen Annahmen ändert.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, die Betriebsumgebung, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluationsdatensatz vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Fehlgebrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenaufwand, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollbacks und Stilllegung zugewiesen werden. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regelversion, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion, prüfen Sie dann Evidenz aus der Praxis nach dem Deployment, anstatt anzunehmen, dass die Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lernprozesse aus Vorfällen, Lösch‑ und Aufbewahrungs‑Prozeduren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Was ist der Unterschied zwischen einer Likelihood und einer Wahrscheinlichkeit?
Bei festgelegten Parametern weist ein Modell den möglichen Daten Wahrscheinlichkeiten zu. Bei feststehenden beobachteten Daten kann derselbe Ausdruck als Likelihood‑Funktion über mögliche Parameterwerte betrachtet werden. Die numerische Formel kann übereinstimmen, während die Interpretation unterschiedlich ist.
Ist Naive Bayes eine vollständige Bayessche Inferenz?
Es verwendet den Bayesschen Satz für die Klassifikation unter einem stark bedingten Unabhängigkeitsmodell. Eine umfassendere Bayessche Inferenz legt Verteilungen über unbekannte Größen an und schließt mit einer Posterior‑Verteilung.
Primärreferenzen